用浏览器自动化与AI搭建闲鱼监控
该开源系统结合 Playwright 与多模态模型,支持自然语言建任务、商品筛选分析和多渠道通知。提供 Web 后台、Cron 调度、账号代理轮换及 Docker 部署,并持久化任务、结果和价格历史。
AI 深度解读
Usagi-org/ai-goofish-monitor 把闲鱼商品监控做成了一套可管理的应用:Playwright 搜索和抓取商品,AI 分析详情与图片,符合要求后发送通知。关键词、价格、区域、账号和定时规则,都能在 Web 界面配置。
它值得程序员看的地方,是浏览器自动化、异步任务、数据存储和前端管理界面如何连起来。但原文是一份项目说明,没有给出推荐准确率、运行成本或持续运行数据,功能齐全还不能直接等同于效果可靠。
AI 负责判断,筛选条件负责缩小范围
单个任务的处理链路很直观:选择账号和代理,搜索商品,发现新商品后抓取详情与卖家信息、下载图片,再交给 AI 判断是否推荐。推荐的商品触发通知,处理记录写入 SQLite,任务继续搜索。
价格范围、包邮、新发布时间和省 / 市 / 区三级区域筛选,承担的是提前缩小候选集的工作。区域数据来自闲鱼页面抓取快照,原文也提醒,限制区域会显著减少结果,初次观察整体市场可以先留空。
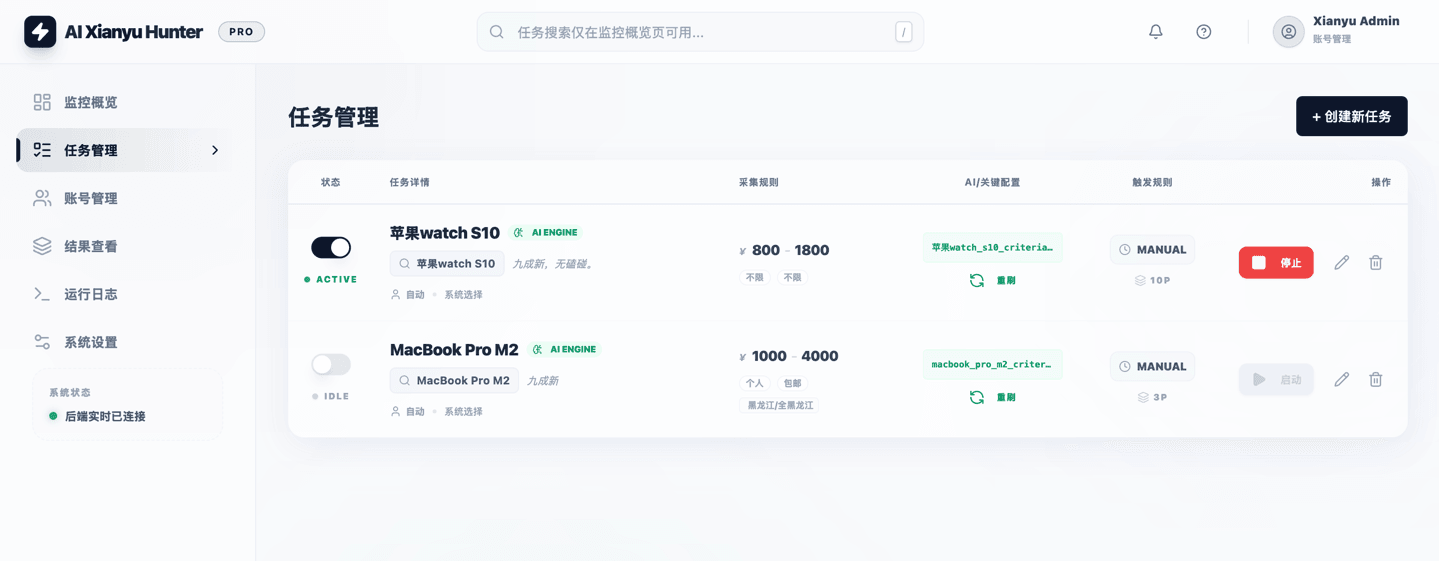
项目提供两条创建路径。AI 判断模式接收「详细需求」,先生成分析标准,再创建任务;关键词模式填写规则后直接创建,不经过 AI 生成流程。每个任务还能独立配置关键词、价格、筛选条件和 Prompt。
能明确写成条件的需求,适合先交给规则处理。
这是我从这套设计里提炼的使用建议,并非作者提供了规则与 AI 的效果对比。原文只说明多模态模型可以分析商品,没有交代模型选型、误判率和人工复核结果。
通知支持 ntfy.sh、企业微信、Bark、Telegram、Webhook 等渠道,定时任务支持 Cron。它解决的是持续盯盘与筛选的问题,最终是否购买仍需要使用者判断。
前端最值得借鉴的是异步任务接口
AI 创建任务可能要等待模型生成分析标准。项目把这一步改成后台 job,提交后打开独立进度弹窗,避免表单一直等待。
接口也明确区分了两种结果:POST /api/tasks/generate 在 decision_mode=ai 时返回 202 和 job,前端继续调用 GET /api/tasks/generate-jobs/{job_id} 查询进度;在 decision_mode=keyword 时,直接返回已经创建的任务。
这是一种能直接带回日常开发的交互设计:请求被接收、后台处理、任务创建完成,是不同状态,页面应分别表达。原文没有说明取消、超时和重复提交如何处理,复用时还得补上这些边界。
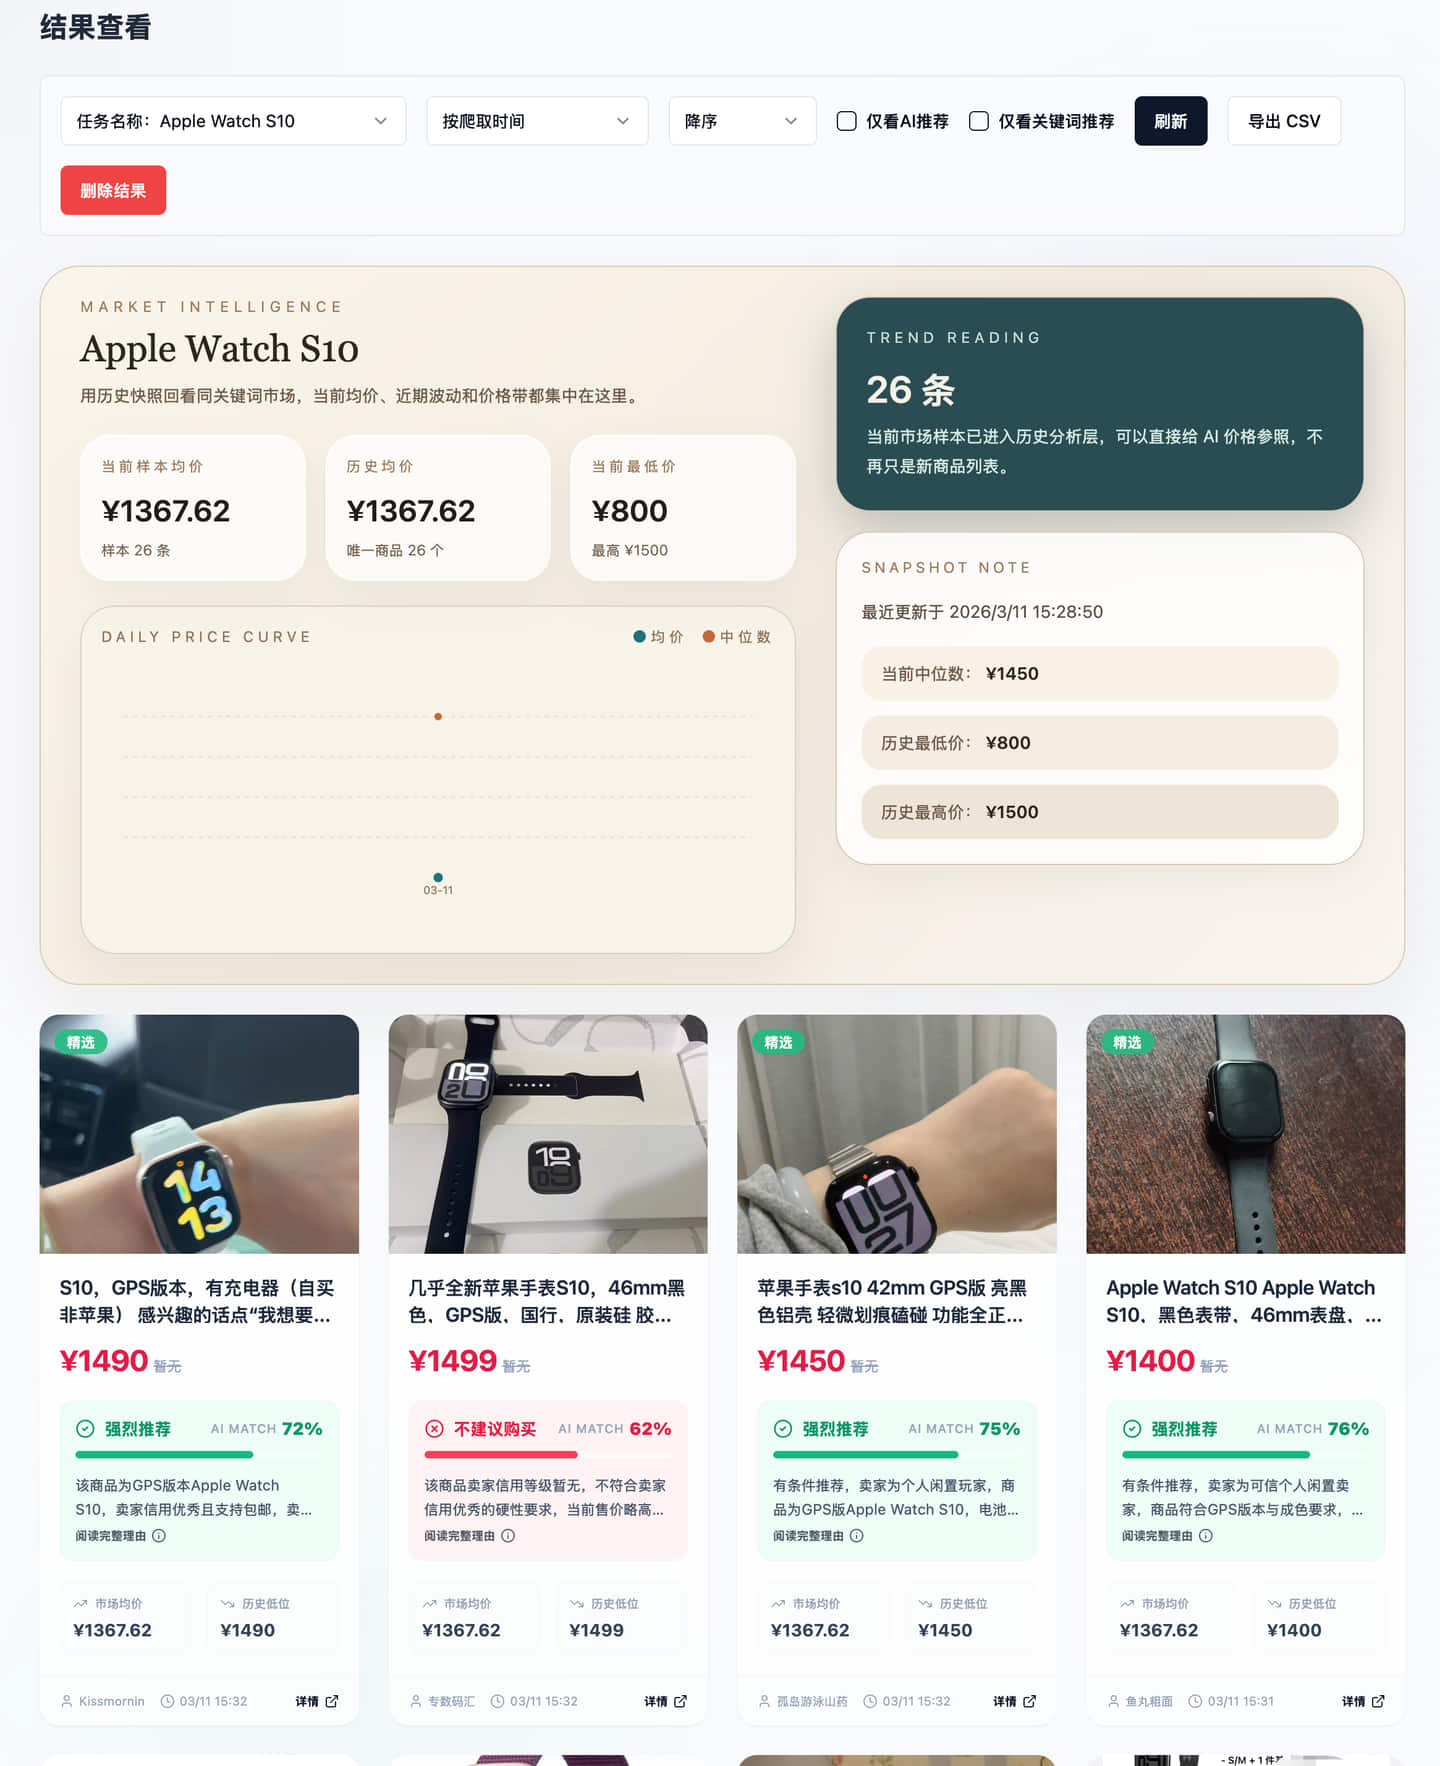
本地开发采用 FastAPI 与 Vite。Vite 将 /api、/auth、/ws 代理到 http://127.0.0.1:8000;npm run build 生成 web-ui/dist/,start.sh 再复制到根目录 dist/,由 FastAPI 提供页面与静态资源。原文只明确验证了 Node v20.18.3 可以完成前端构建。
日志页按任务展示运行过程,帮助排查登录态失效、风控和 AI 调用问题。对于这种依赖浏览器状态与外部模型的应用,可观察性直接影响维护成本。
跑起来之后,数据库和登录态都要管
Docker 是说明里较直接的启动方式,镜像已内置 Chromium:
git clone https://github.com/Usagi-org/ai-goofish-monitor && cd ai-goofish-monitor
cp .env.example .env
vim .env # 填写相关配置项
docker compose up -d
docker compose logs -f app
docker compose down
要留意最后一行:docker compose down 是停止服务,查看日志后无需立刻执行。默认 Web UI 地址是 http://127.0.0.1:8000;修改 .env 中的 SERVER_PORT 时,还要同步调整 docker-compose.yaml 的端口映射。
模型接入需要 OPENAI_API_KEY、OPENAI_BASE_URL、OPENAI_MODEL_NAME。PROXY_URL 用于单独指定 AI 请求的 HTTP/SOCKS5 代理;Docker 中 RUN_HEADLESS 应保持 true,容器使用 Chromium,不能通过 LOGIN_IS_EDGE 切到未内置的 Edge。
数据方面,当前在线主存储是 SQLite,任务、结果和价格历史默认存入 data/app.sqlite3。Docker 挂载为 ./data:/app/data,容器数据库路径默认是 /app/data/app.sqlite3,也能用 APP_DATABASE_FILE 自定义。
升级时,应用会尝试从 config.json、jsonl/、price_history/ 导入一次旧数据。结果页和导出功能已经改为查询 SQLite。确认导入正确后,再决定是否保留旧数据挂载。
但备份数据库并不等于备份完整应用。state/ 保存登录态,prompts/ 保存提示词,logs/ 保存日志,images/ 保存图片,它们仍在文件系统里。商品临时图片位于 images/task_images_<task_name>/,任务结束后默认清理。
闲鱼账号需要通过 Chrome 扩展导出登录态 JSON,再粘贴到管理界面,文件例如 state/acc_1.json。Web UI 自己还有一套登录,默认凭据是 admin/admin123,部署时需要修改。
我的判断
这套项目有参考价值:它覆盖了从任务配置、后台执行到结果查询和通知的完整链路,也提供关键词模式,让简单需求有更直接的入口。
但 AI 效果目前缺少证据。原文没有推荐准确率、漏报情况、模型调用成本,也没有和关键词监控做对照。因此,多模态分析是否比规则更有用,需要拿自己的需求验证。
账号与代理轮换、失败重试,也不能据此推断为长期稳定。原文没有给出并发规模、运行时长或账号受限情况。项目还明确要求遵守闲鱼用户协议和 robots.txt,避免频繁请求。
Web UI 登录成功后,前端会在浏览器本地保存登录状态,用于路由守卫和 WebSocket 初始化。仅凭这些描述,无法确认后端所有接口与 WebSocket 的鉴权方式,准备开放访问前需要检查实现。
能拿来做什么
- 想监控明确型号和价格区间时,先用关键词模式配置任务,确认结果覆盖范围,再判断是否需要加入 AI 分析。
- 做 AI 编程应用时,可以借鉴
202 + job + 进度查询的接口约定,把耗时生成从表单提交中拆出去,并补齐失败、超时与重复提交处理。 - 准备持续运行时,把 SQLite、登录态和 Prompt 一起纳入备份范围,升级后核对历史数据,再处理旧文件。
- 做前后端部署练习时,可以沿着 Vite 代理、前端构建、产物复制、FastAPI 静态托管这条链路阅读代码,理解开发与部署时请求分别流向哪里。