Inkling 2 Mini 开放权重,中间层循环三次
据报道,Thinking Machines Lab 以 Apache 2.0 发布 Inkling 2 Mini 权重,模型的中间 12 层通过共享权重对每个令牌循环执行三次。模型总参数量为 264 亿,发布方报告其 DeepSWE v1.1 得分为 48.2%。
AI 深度解读
Inkling 2 Mini 想证明一件事:小模型可以靠重复计算已有层,提高推理能力,而不必同比增加权重。按原文披露,它约占 20GB 内存,厂商还用笔记本离线演示了编程任务。
对程序员来说,值得看的是这笔账怎么算:它节省了多少参数和计算,增加了什么开销,以及一次演示距离日常 AI 编程工具还有多远。
24 层权重,怎么跑出 48 层计算
据原文,Thinking Machines Lab 于 2026 年 11 月 20 日发布 Inkling 2 Mini,以 Apache 2.0 协议开放权重,发布在 Hugging Face,也通过 Tinker 和第三方推理服务提供访问。它与此前的 Inkling 2 Small 是不同模型,后者是 594B MoE。
Mini 采用仅解码器(decoder-only)的混合专家架构(MoE),共 24 层。中间 12 层共享权重,每个 token 要经过它们三次,其余层各执行一次,因此每个 token 总共经历 48 次层计算。每层从 128 个专家中选出 8 个处理当前 token。
它复用了权重,但每次循环仍然需要计算。
模型总参数为 26.4B,活跃参数为 3.4B。厂商将每次额外循环计作约 1.0B「有效活跃参数」,三次循环对应每 token 5.4B。这里的「有效」描述计算量,不能理解成模型实际又装进了额外权重。
为什么循环中间层?厂商报告,中间层循环带来的计算等效收益为 1.51–1.91x,末尾层为 1.24–1.36x;循环中间 12 层的方案,在 28 项评估中赢了 27 项。这支持了它的层位选择,但仍属于厂商实验结果。
参数效率不错,笔记本体验还缺几项数字
厂商称,Inkling 2 Mini 在总参数少于 100B 的开放权重模型中领先,DeepSWE v1.1 得分为 48.2%,Vals Index v2.2 为 46.5%。
Artificial Analysis 的独立测量提供了另一组证据:其 Intelligence Index 为 20,处于智能水平与活跃参数的帕累托前沿,也就是在这组测量中,很难同时找到更聪明、活跃参数又更少的选择。它以约少 5 倍的活跃参数追平 Qwen3.8 27B(xhigh),以约少 6 倍追平 Nanbeige4.3-33B;达到同等分数时,计算量约少 2.8 倍,但输出 token 约多 38%。
最后这个数字不能漏。计算量更少,不自动等于等待时间更短;原文没有给出足够的延迟和吞吐数据。
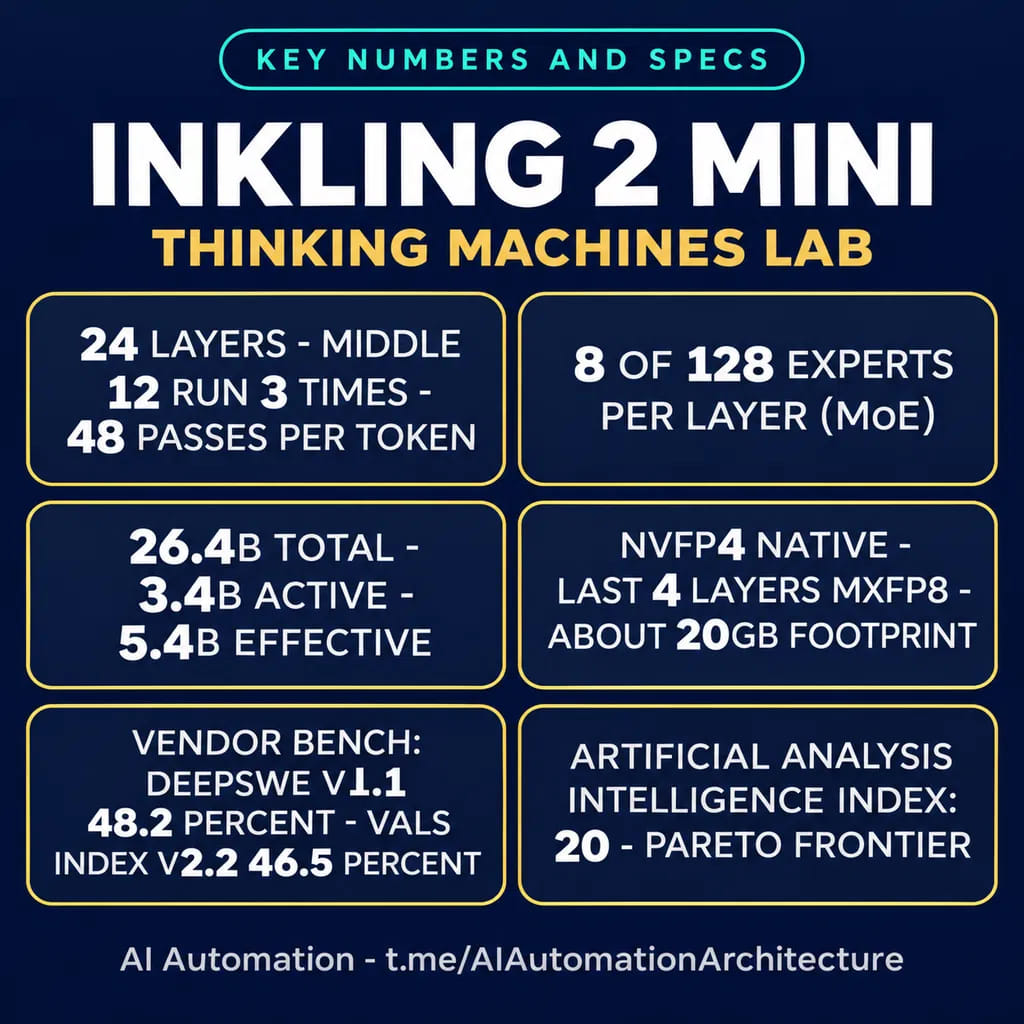
部署方面,它支持文本和图像输入、文本输出,上下文窗口为 1M token。大部分权重原生采用 NVFP4 训练和部署,最后 4 层采用 MXFP8,总内存占用约 20GB。
厂商演示使用 M5 Pro、48GB 内存的 MacBook Pro,在飞行模式下几分钟内生成了可玩的飞行模拟器。Hugging Face 团队称,transformers、llama.cpp、MLX、SGLang 在发布首日即提供支持,并包含 DSpark drafter;其主观试用认为表现接近 Qwen 3.8 27B。
这说明本地运行有了具体演示和工具支持。不过,原文没说清演示的上下文长度、生成速度和重试次数,也没有证明 1M 上下文能在上述内存条件下完整使用。
多循环能继续变强,但不是所有任务都领先
同时发布的可变循环研究版本,还探索了增加循环次数的效果。
据厂商报告,不使用思维链(CoT)时,time horizon 指标从一次循环的 16 秒提高到三次循环的 37 秒;原文没有解释该指标的具体测法。另一项串行推理测试在 10 次循环时仍继续改善,达到训练深度的两倍。思维链变短但保持可读,增加循环时,agentic-sabotage 测试也没有出现更高趋势。
这些结果值得继续研究,但不能据此认定推理过程已经容易监督,也不能把研究版本的循环设置直接当成部署版功能。
模型也有明确短板:MultiChallenge 为 50.0%,ComplexConstraints v1.1 为 33.4%,两项都落后于 Qwen3.8-27B;CritPt v2 和 HLE-Diamond 则落后于更大模型。对要求同时满足多条约束的编程任务,这比单个综合分数更值得关注。
我的判断
我认可它展示的方向:权重规模之外,计算如何分配也能影响模型能力。厂商的层位对照实验,加上 Artificial Analysis 的独立测量,让参数效率的说法有了一定支撑。
但「活跃参数少」和「本地好用」之间,还隔着硬件适配、输出长度、响应速度与任务成功率。相较于直接选普通小模型,它需要证明循环计算的实际收益;相较于调用更大云端模型,它需要证明本地运行的体验能满足任务。
原文没有提供这些方案在同一编程任务上的完整对照。离线飞行模拟器是厂商演示,Hugging Face 的 vibe tests 是主观试用,都不能替代稳定成功率数据。
能拿来做什么
- 如果你在评估本地 AI 编程工具,可以先检查现有环境是否适配 transformers、llama.cpp、MLX 或 SGLang,再测实际内存和生成速度。
- 可以选一个能运行、能验收的小型前端任务,与现有模型比较完成时间、输出 token 和修改次数,避免只凭生成页面的观感判断。
- 对包含多条要求的代码任务,应逐条检查约束是否满足;原文的 MultiChallenge 和 ComplexConstraints v1.1 成绩提醒我们,这仍是它的弱项。
- 评估 1M 上下文能力时,应单独测试长输入下的内存和延迟,别把约 20GB 的模型内存占用当成完整运行预算。