让AI提议、人来批准的版本化运行时
Derive World以共享世界对象为例,讨论版本、权限、审批和派生谱系的设计,让个人AI可以提出修改但不能自行批准。文中明确说明,演示使用确定性数据,不调用真实模型。
AI 深度解读
AI 几秒钟就能生成一个像样的世界,但把它变成可进入、可修改、可分享的产品,还要回答另一组问题:谁有权改、改的是哪个版本、谁批准了这次修改,以及派生出去的分支如何追溯来源。
Derive World v0.2.0 给出的答案是:让 Personal AI 提方案,把批准权留给人,再用服务端的版本与权限规则兜底。对做 AI 编辑器、共享工作区的程序员,这篇文章的价值就在这里:生成结果进入业务状态之前,系统需要建立哪些边界。
AI 可以提修改,为什么不能顺手执行
Derive World 是一个开源的 Living Objects 基础项目,把世界当作有内容、状态、变量、权限、版本和血缘关系的共享对象。v0.2.0 是第二个公开版本,对应 V2 产品阶段。
作者反对的并非聊天界面,而是拿聊天记录代替对象模型。对话能保存讨论过程,却不会自动提供成员权限、不可变快照和版本历史。一旦 AI 既提建议又直接落库,事后就很难解释谁授权了当前状态。
他们的规则是:Personal AI 读取当前状态和版本,只提交一个可合并提案,等人批准后才应用。一次应用只增加一个版本,保留已有 thing ids,刷新后结果仍然存在。
批准边界必须由服务端执行,提示词只能表达意图。
状态修改必须携带 expected_version;版本不一致时返回 409 version_conflict,拒绝覆盖。它处理的是一个常见问题:用户审阅提案期间,对象可能已经被别人改过,批准旧方案不等于允许覆盖新状态。
作者还给生成结果设了体积上限:单次模型输出最多 8 KiB,对象状态最多 64 KiB,一次创建确认最多 12 KiB。这些限制试图让方案保持可审阅,也限制模型一次塞入大量内容。不过,小提案是否更好审,原文没有用户测试数据。
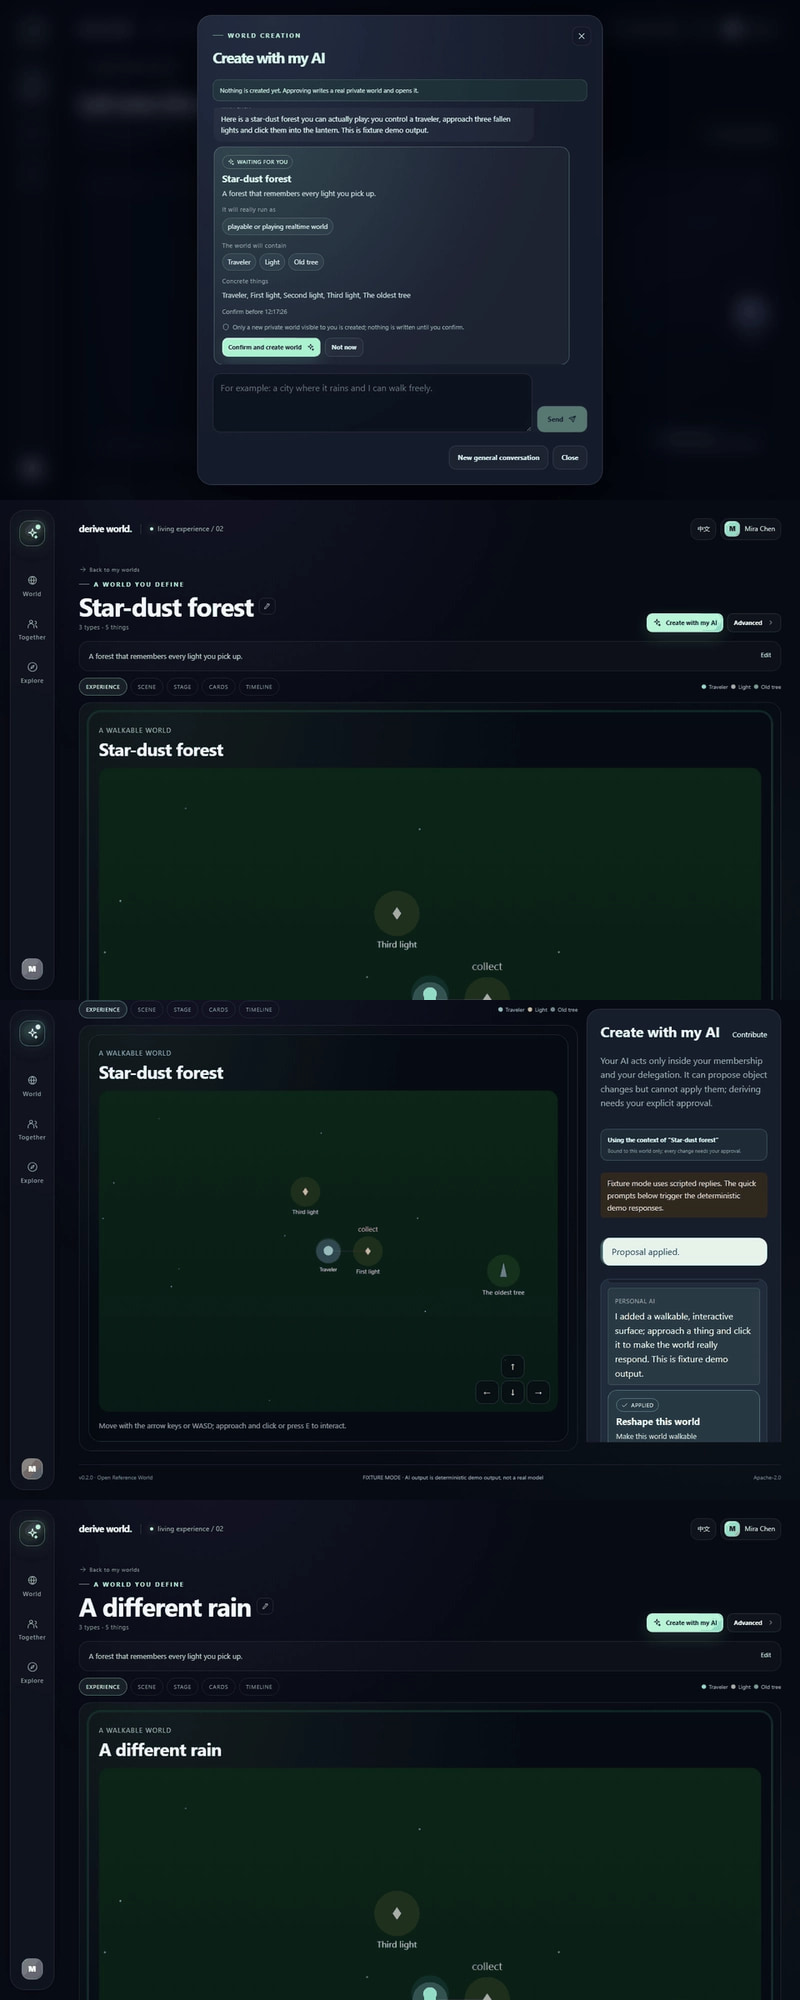
图中是真实产品的 Fixture 演示,但 Fixture 使用确定性数据,不调用模型,也不是真实 AI。真实模型证据另有范围:作者在候选提交 4962b9b 上记录了连续三次自然语言修改,验证了提案、人工批准、单次版本递增、thing ids 保留和刷新持久化。正式 v0.2.0 标签包含文档与发布修复,这些流程没有在该标签上重跑。
模型写简报,服务端为什么还要接手
创建世界时,模型先把用户描述整理成紧凑简报,再由服务端 composer 扩展为内容、状态和体验。提案先验证再存储,人批准后才创建,新世界默认私有。
这个分工限制了模型的权限。模型不能随意生成运行时代码或原始页面标记;世界内容是声明式数据,由服务端解释,不执行用户代码,不加载外部 URL、字体或脚本,也不开放网络访问。
它仍支持多种表现形式,包括按时间运行的 2D 场景、互动故事、可编辑工作区、视觉空间、上传的图片和视频、上传或程序化音频,以及带客户端重力和碰撞的 3D 场景。多个表面可以通过标签页组合,但共享同一套状态、权限和版本规则。
这让界面形态改变后,审计机制仍然成立。代价是每种新形态都要适应共同约束,扩展形式需要修改模块,不能给每个世界塞一个任意页面。
开发入口也围绕这个边界组织:五个冻结能力 object.read、object.context、object.propose_change、object.derive、content.structure 统一经过 Broker;capabilities.yaml 只允许配置式注册,不支持运行时注册或任意 provider URL。
参考部署是 Docker Compose,包含 Go 服务、PostgreSQL schema 11(36 张表)和构建后的 Web 客户端,默认只绑定回环地址。接口契约位于 api/openapi/openapi.yaml,使用 OpenAPI 3.1;sdk/typescript 提供零运行时依赖的类型化 TypeScript SDK。
权限同样在服务端执行。无读取权限返回 404,避免通过 403 暴露对象存在;公开版本是存储下来的脱敏副本,发布需要主动选择,涉及他人贡献时还需要贡献者同意。
模型提供方的传输也被纳入信任边界:响应签名、TLS 验证、HMAC 密钥轮换、单次调用模型上限、用户每日预算和部署级停止开关。被篡改或未签名的响应按未知结果处理,不能当成成功。
派生出来的世界,为什么不跟父版本同步
Derive 基于当前版本的不可变快照,创建一个独立子世界。父世界不变,之后的父级修改不会传播,子世界拥有自己的版本历史。
大白话解释:它保存的是分支起点当时的内容,不是持续指向父世界最新状态的引用。
血缘记录还会按权限裁剪,用户无权读取的对象不会出现在祖先信息里,防止追溯功能泄露私有对象。v0.2.0 只支持整个世界派生,不支持按单个实体派生。作者接受了这个取舍,因为整对象快照比局部合并更容易推理。
这里也有明确边界。系统只有单实例,发布、派生和社交功能不跨实例,没有联邦、公开导入或水平扩展。工作区没有同时协同编辑,而是使用经过认证的 SSE 刷新信号,并提供轮询回退;冲突发生时报告错误。
内容侧没有任意代码、网络访问、实时多人同步或任意视频生成。真实模型验证仅覆盖 DeepSeek deepseek-flash 的已记录流程,不代表其他提供方都已验证。
我的判断
我赞同作者把授权当作核心设计。对 AI 修改共享数据的产品,记录模型说过什么还不够,还要记录人批准了哪个版本上的哪项修改。版本校验、权限检查和批准流程结合起来,才有机会回答这个问题。
但人工批准也有成本。逐项确认适合需要审阅的共享对象,高频、低风险操作可能更适合预授权范围内执行,并配合日志和撤销。原文没有比较这些方案的效率或错误率,不能据此认定人工批准适合所有 AI 产品。
声明式内容也有取舍:执行边界更容易控制,表达能力则受到 composer 和模块能力限制。体积上限约束的是数据量,并不保证语义简单;8 KiB 的提案照样可能难以判断。
它值得借鉴的是权限与版本的组合设计,验证证据仍然很窄。
作者明确称它为可自托管的开源 MVP,并非生产平台。三次真实模型修改能证明特定流程跑通过,无法证明复杂并发、长期使用或多模型兼容性。
能拿来做什么
- 给 AI 编辑器或共享工作区设计修改接口时,可以让提案携带目标版本,批准后再由服务端校验
expected_version,并在前端明确呈现冲突。 - 做故事编辑器、场景配置工具时,可以借鉴「模型产出声明式简报,服务端负责解释」的分工,先定义允许生成什么,再实现生成入口。
- 评估派生功能时,先区分独立快照与持续同步视图。如果选择快照,就要向用户说明父级更新不会自动进入子分支,同时检查血缘信息是否泄露权限外对象。
- 想体验完整流程,可以按原文命令启动 Fixture 模式,无需模型账号:
git clone https://github.com/QiyanAI/derive-world.git
cd derive-world
cp .env.example .env
docker compose up --build -d
这里要留意 cp .env.example .env 这一行,它准备了本地配置。启动后在浏览器打开 http://127.0.0.1:8080,注册本地账号,依次体验创建、批准、进入、修改和派生;这条路径验证的是产品交互,真实模型能力需要另行配置和验证。