用缺陷 PR 检验 AI 审查器的可靠性
作者为自托管 CodeGuard AI 构造 GitHub PR,测试缺陷识别、误报控制和测试质量分析。场景涵盖测试超时、构建成功却未执行测试,以及测试通过但实现错误等容易误判的情况。
AI 深度解读
AI 审查机器人能找出几个 bug,不等于能判断一个 PR 是否可以合并。CodeGuard AI 的作者把验证重点放在真实 GitHub 流程里:主动创建带有缺陷、测试陷阱和边界情况的 PR,观察工具能否区分代码问题、测试问题与证据不足。
结果有成功,也有明显矛盾:它能发现被通过的测试掩盖的计算错误,却也出现过测试执行未经确认、合并结论仍然安全的情况。对准备接入 AI 审查的团队,这比演示里找出了多少问题更有参考价值。
测试通过之前,先确认测试真的跑过
CodeGuard AI 是一个可自托管的 GitHub PR 审查工具,使用 Java 21 和 Spring Boot 3 构建,接入 GitHub,并支持 AI provider。
作者没有只拿示例代码做演示,而是刻意创建不同类型的 GitHub PR,检查审查链路能否识别以下状态:
- 测试确实执行,并出现断言失败。
- 测试运行超时。
- 构建成功,但没有执行测试。
- 测试结果证据无法读取。
这些情况不能统称为「测试没问题」。构建成功可能只说明编译或打包完成;测试超时也无法证明业务逻辑正确。
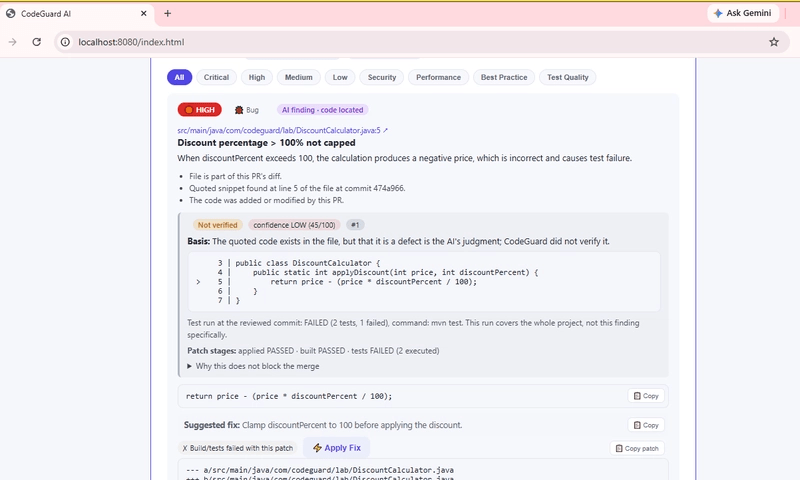
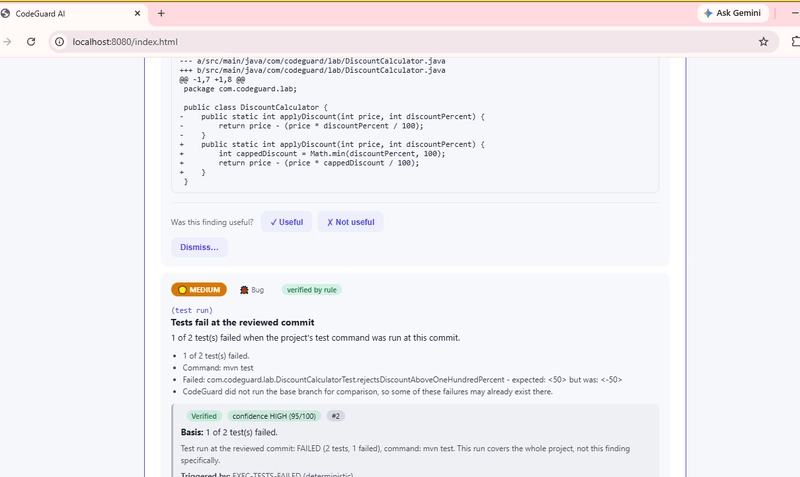
在已报告的案例中,工具识别出了一次真实断言失败,并展示了预期值与实际值;它也把一次超时正确归类为 TIMED_OUT。
但作者同时发现,有些失败测试只收到了警告,没有触发阻止合并的建议。另一个案例里,测试执行尚未验证,合并决策却仍被标记为安全。
审查结论必须受验证结果约束,不能让证据不足变成安全承诺。
测试是绿的,也可能没有验证改动
作者的另一组实验针对「测试通过,但实现有错」。
例如,一次折扣计算存在错误,现有测试仍然通过,CodeGuard 找出了计算问题。这里要检查的不是测试状态,而是断言是否真的覆盖了修改后的行为。
测试文件发生变化,不代表改动得到了验证。缺少边界值、遗漏回归场景,都可能让错误实现躲在绿色结果后面。
不过,缺测试和有 bug 仍然是两种结论。作者报告,工具曾指出缺少回归覆盖,同时没有把生产实现描述成已经确认存在缺陷。这种措辞区别很重要:前者要求补证据,后者要求修实现,处理方式不同。
误报也被纳入了测试。作者同时准备了不安全的 Optional.get()、安全的 Optional.orElse(),以及正确和错误的折扣计算、有效断言与无害代码。其中,工具没有误报有效的 Optional.orElse() 用法。
作者还提出,审查工具应避免给出削弱有效测试的修复建议。不过,原文没有展示具体补丁,也没有证明这一项已经验证通过,不能把目标当成现有能力。
我的判断
我认同作者把「合并建议是否可信」放在「发现数量」前面。相较于只让模型阅读 diff 并输出意见,这套验证思路还会追问:测试有没有执行,证据能不能读取,结论是否与证据一致。这些问题直接关系到工具能否进入日常开发流程。
但这仍是一份阶段性经验记录。所谓真实 GitHub PR,指的是作者主动创建的测试 PR,并非已经证明工具能稳定处理大量自然产生的业务 PR。
作者正在推进一个 100 场景验证计划,原文没有交代已完成多少项,也没有给出误报率、漏报率、重复运行的一致性或其他工具的对照数据。因此,几个成功案例可以说明验证方向有价值,不能证明产品已经可靠。
对于确定性的检查,现有 CI、测试框架和静态分析仍适合提供基础证据。AI 更适合补充判断断言是否覆盖改动、实现是否可能违背业务意图。原文没有提供两种做法的效果比较,这个分工是我的取舍。
作者接下来计划验证仓库上下文、回归检测、团队策略、建议补丁校验、审查一致性和合并决策。这些都还是后续重点,不能当成已经交付的能力。
能拿来做什么
- 给前端或 Node 项目接入 AI 审查时,先准备一组刻意构造的 PR,覆盖真实断言失败、测试超时、构建成功但未执行测试,以及测试报告无法读取的情况。
- 检查业务逻辑改动时,要求审查结果说明现有断言验证了什么行为,并分别表述「已确认的缺陷」「缺少覆盖」和「需要核实的推断」。
- 把无害代码、正确计算和有效断言也放进验证集,观察工具是否为了输出意见而制造问题。
- 在允许 AI 给出安全合并建议之前,检查失败、超时和未验证状态能否约束最终结论;对于建议补丁,重新执行相关测试,确认它没有靠削弱断言消除失败。