编程模型榜单分数为何难以直接比较
文章核查 Hugging Face 的 SWE-bench Multilingual 榜单,发现34条记录均未验证,15个分数无法按300道题的单次运行结果解释,且多数未说明评测框架。官方数据还显示,头部模型的小幅差距不足以支撑明确排名。
AI 深度解读
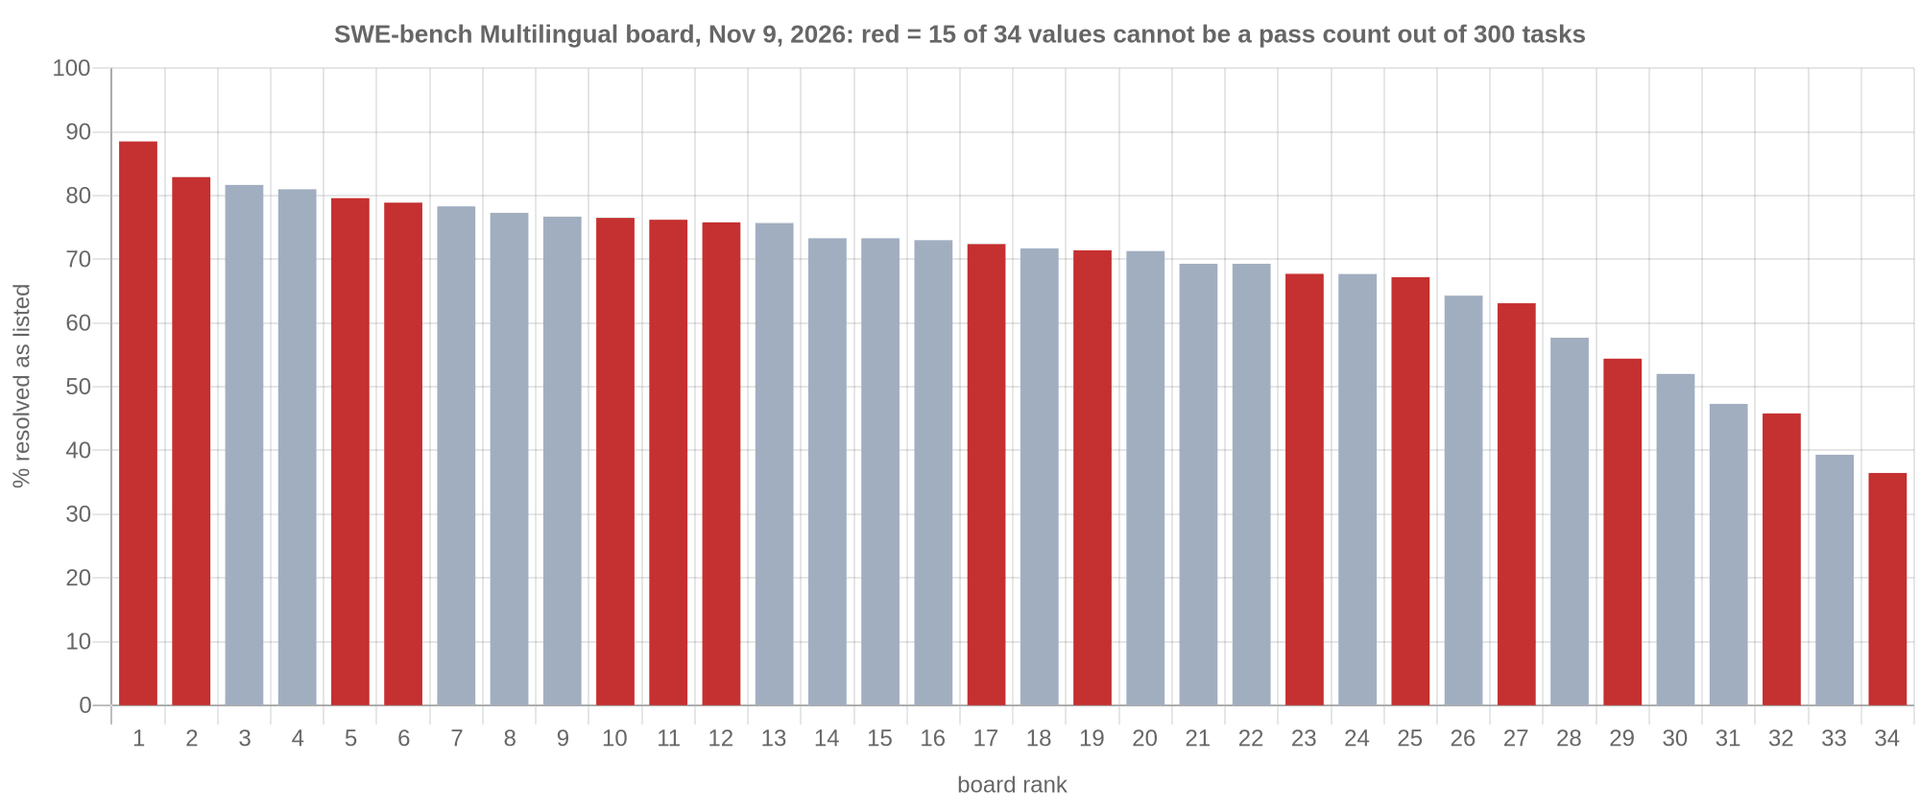
SWE-bench Multilingual 的排行榜上,88.5 分究竟代表什么?作者检查了 Hugging Face 页面截至 2026 年 11 月 9 日的 34 条记录,发现 15 个分数无法对应一次完整的 300 题测试,而且所有记录都未验证。
这不等于模型成绩造假。文章真正指出的是:运行次数、测试分母、Agent 和日期缺失时,一个按分数排序的表格,很容易被读成模型能力的精确排名。对准备挑选 AI 编程工具的程序员,这些缺失比名次更值得看。
34 个分数,未必来自同一种考试
SWE-bench Multilingual 收集了 41 个 GitHub 仓库、9 种语言的 300 组真实 issue 与修复 PR。系统拿到修复前的代码和问题描述,生成补丁,再通过仓库自身的测试判断任务是否解决。
它测的是代码修复系统的表现。模型之外,负责读取文件、调用工具、执行测试的评测框架(harness),也参与决定结果。
Hugging Face 数据集页面的榜单,从模型仓库的 .eval_results/ 目录读取 YAML。文件提供分数、来源链接,以及可选的日期和备注。公开接口是 /api/datasets/SWE-bench/SWE-bench_Multilingual/leaderboard。
作者沿着记录检查发现:
- 34 条记录全部是
verified: false。 - 30 条来自仍未合并的 PR,由两个账号分别提交了 23 条和 7 条;另外 4 条来自主分支,排名为 7、14、17、34。
- 32 条引用模型卡,2 条引用论文,后者排名为 3 和 26。
- 只有 2 条说明 harness:第 4 名注明
mini-SWE-agent、256K context,第 26 名注明OpenHands。 - 只有 9 条填写日期。15 家组织中,三家分别占 6、5、5 条,共占 16 条。
账号和组织集中本身不能证明成绩有问题,但它说明这个榜单更接近自报结果的汇集页面。PR 仍然开放,也不能当成维护者已经审核通过。
对照之下,基准官方表的 13 条记录统一使用 mini-SWE-agent,提供逐题结果,其中 12 条带维护者检查标记。不过,它最新的记录日期是 2026 年 2 月 20 日,覆盖范围也有明显时效限制。
为什么 88.5 分值得追问,却不能直接判错
300 道题,每题只有通过或失败。单次完整运行的百分比分数应当是 100 × k / 300,步长约为 0.333 个百分点。
作者检查了显示精度下是否存在对应的整数题数。34 条记录中有 15 条不满足,包括前两名 inclusionAI/Ling-3.1-flash 的 88.5 和 tencent/Hy4-preview 的 82.9;前 12 名中有 7 条,前 6 名中有 4 条。
下面这段原文代码解决的就是「四舍五入后,能否对应整数题数」的问题:
N = 300  # tasks in SWE-bench Multilingual

def counts_that_round_to(v):
    dec = max(1, len(repr(float(v)).split(".")[1]))  # 81 is stored as 81.0, one decimal
    half = 0.5 * 10 ** -dec
    return [k for k in range(N + 1) if abs(100 * k / N - v) <= half + 1e-9]
要看的是最后一行:它枚举所有可能的通过题数,并为显示精度留出舍入误差。单纯判断「分数乘 3 是否为整数」会误伤正常结果,例如 73.3 可以对应 220 道题。
不能对应单次题数,只能证明统计口径需要解释,不能证明成绩错误。
例如,5 次运行取平均,分数步长就约为 0.067 个百分点;排除环境启动失败的任务,也会改变分母。问题是这些记录没有交代具体采用哪一种方式。反过来,另外 19 条通过检查,也不能证明口径一致:一位小数的分数,碰巧落在合法位置的概率约为三成。
模型卡和官方表的交叉对照进一步说明了条件差异:
| 模型 | Hugging Face 榜单 | 官方表 |
|---|---|---|
| GLM-5 | 73.3,约 220/300 | 69.7,约 209/300 |
| Kimi-K2.5 | 73.0,219/300 | 67.3,约 202/300 |
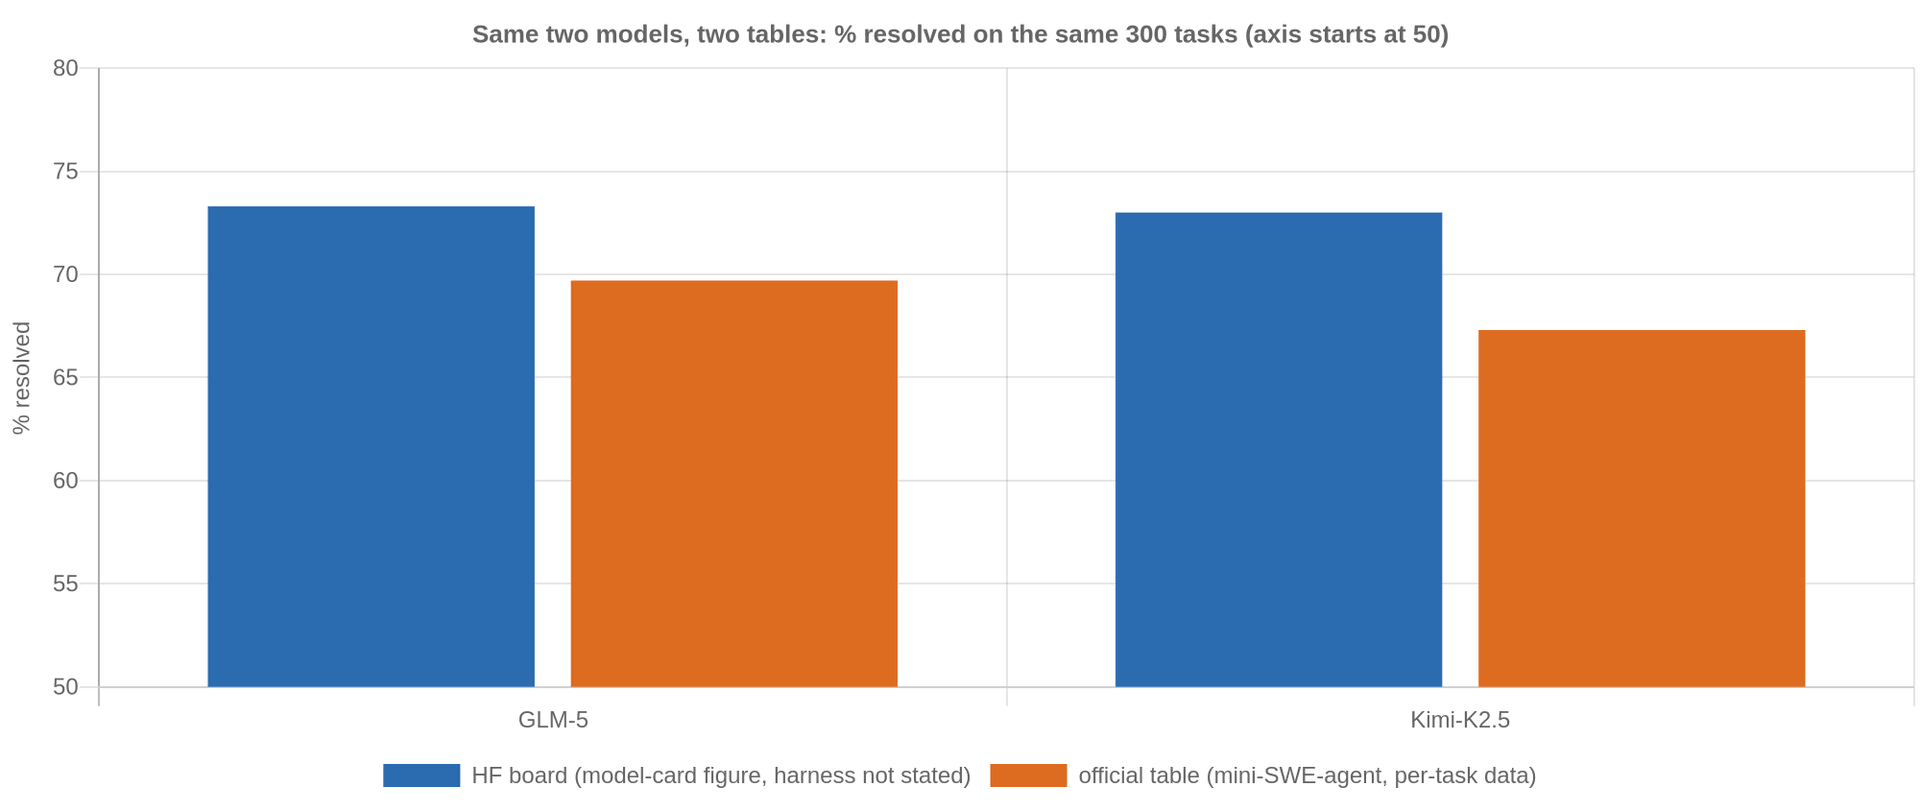
两者分别高出 3.6 和 5.7 个百分点,但榜单没有说明 harness。Agent、工具预算和提示词都可能改变成绩,不能把差值直接归因于模型。
同样,榜首 88.5 比官方最高的 72.7 高出 15.8 个百分点,也无法据此量化进步:模型代际、测试时间、执行方和 Agent 都不同。
差两道题的冠军,对前端可能没有那么重要
官方表前两名分别是 Gemini 3 Flash 和 Claude 4.6 Opus,通过 218、216 道题,只差 2 道。
逐题看,190 道双方都通过,28 道只有 Gemini 通过,26 道只有 Claude 通过。作者据此算出,0.67 个百分点差距的配对标准误为 2.45 个百分点。对这两个结果如此接近的系统,领先约 5 个百分点、也就是约 15 道题,才超过 1.96 倍标准误。
这不是所有模型都适用的固定门槛,关键取决于双方在哪些题上产生分歧。GLM-5 与 Kimi-K2.5 在官方表相差 7 道题,配对标准误为 2.47 个百分点,差距仍不足一个标准误。
不看逐题数据时,区间也会提醒读者放慢判断。榜单第 3 名按 245/300 计算,95% Wilson 区间为 76.9%~85.6%;第 13 名按 227/300 计算,为 70.5%~80.2%。相隔 10 个名次,区间仍重叠超过 3 个百分点。
语言分布还有另一层偏差:
| 语言 | 题数 | 语言 | 题数 |
|---|---|---|---|
| Ruby | 44 | Java | 43 |
| Rust | 43 | PHP | 43 |
| Go | 42 | C | 30 |
| JavaScript | 26 | TypeScript | 17 |
| C++ | 12 |
前五种语言占 215 道题。JavaScript 和 TypeScript 合计只有 43 道,前端读者关心的能力,在总分里权重有限。C++ 只有 12 道,其中 11 道来自同一个仓库,代表性也受限制。
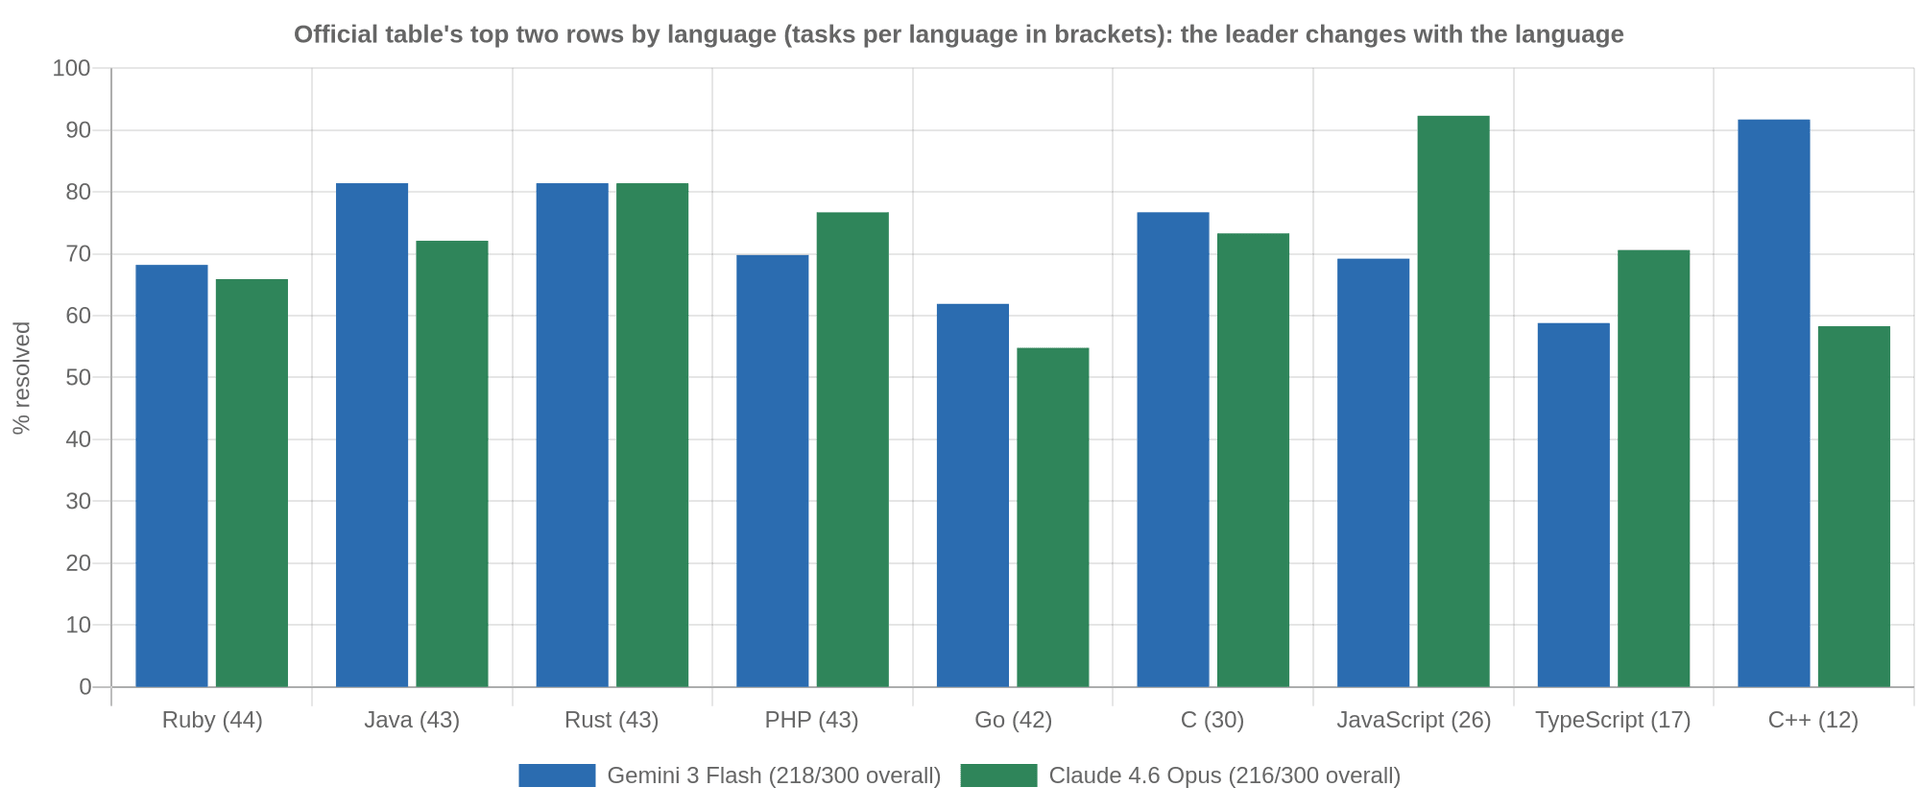
Claude 4.6 Opus 的 JavaScript 成绩是 24/26,即 92.3%;Gemini 3 Flash 是 18/26,即 69.2%。C++ 则反过来,Gemini 是 11/12、91.7%,Claude 是 7/12、58.3%。
这些语言内差距达到 4~6 道题,比总分的 2 道题差距还大。但也别立即宣布单项冠军:每多通过一道题,语言分数就会跳约 2~8 个百分点。官方 13 条记录中,Gemini 3 Flash、Claude 4.6 Opus、GLM 5、Kimi K2.5、GPT 5.2 Codex 都曾在至少一种语言上领先或并列领先。
我的判断
作者最有价值的工作,是把「分数的来源」和「分数能支持的结论」拆开检查。300 题的整数约束可以复算,逐题差异和语言分布也有明确依据,比盯着榜首讨论谁更强更有帮助。
但这里的统计区间和标准误,需要理解为对有限题集表现差异的估计,不能直接当成模型重复运行的波动范围。作者没有提供完整的多次重跑实验,也没有给出统一条件下覆盖全部模型的对照,因此无法据此解释每个分差的成因,更不能判定那 15 条成绩失实。
统一 Agent 的官方表更便于比较模型,代价是结果绑定了该 Agent,而且更新较早。模型卡可以展示各自系统的最佳配置,却需要公开配置才能公平解读。两种方式各有用途。
这个榜单适合筛选候选系统,现有信息不足以支撑精细的能力排序。
元数据也不能照单全收:相同的 73.3、69.3 分分别被排成不同名次;ornith-ai/Ornith-1.0-35B 和 ornith-ai/Ornith-1.0-9B 的 num_parameters 分别显示为 664,944 和 1,469,680,与名称暗示的规模明显不符。作者检查到 Hub 的 safetensors 元数据也是这些值,对应仓库有 16 和 4 个权重分片,但没有查明原因。尺寸列只能作为线索。
能拿来做什么
- 挑 AI 编程工具时,先确认成绩的运行次数、实际分母、harness 和日期。缺少这些信息,就把分数作为候选线索,别因为相差几个名次直接做决定。
- 比较接近的成绩时,先换算成题数,并考虑舍入精度;有逐题结果就检查各自独有的成功案例,看看差异是否落在你关心的修复任务上。
- 做前端或 Node 开发时,优先查看 JavaScript、TypeScript 的分项表现,再用自己的仓库验证。26 道和 17 道题的结果,可以提供方向,还不足以代表整个技术栈。
- 给团队整理内部评测表时,把运行次数、分母、Agent 配置和日期与分数一起保存,并保留逐题通过情况。这样后续更换模型或工具预算时,才能判断成绩为什么变化。