语义缓存高命中率可能掩盖错误答案
文章提供配套代码,以七组测试检验语义缓存误命中;示例中命中率为 79.2%,但命中结果有 6.4% 错误。测试覆盖阈值校准、否定表达和数字日期变化,并展示对应防护效果。
AI 深度解读
语义缓存能省下模型调用,但命中率高,不代表复用的答案正确。作者用 Actian VectorAI DB 做了七组测试:相似度阈值设为 0.80 时,命中率达到 79.2%,命中的答案却有 6.4% 不该返回,有些错误匹配的相似度甚至超过 0.95。
这组实验最有用的地方,是把「相似」和「可以共用答案」拆开验证。否定词、金额、租户边界和过期政策,分别需要不同的防线。对正在给 AI 应用加缓存的程序员来说,这比寻找一个通用阈值更值得看。
命中率为什么会掩盖错误
语义缓存先把问题转换成向量,再从缓存中找最接近的问题;余弦相似度达到阈值,就返回已有回答,否则调用模型。
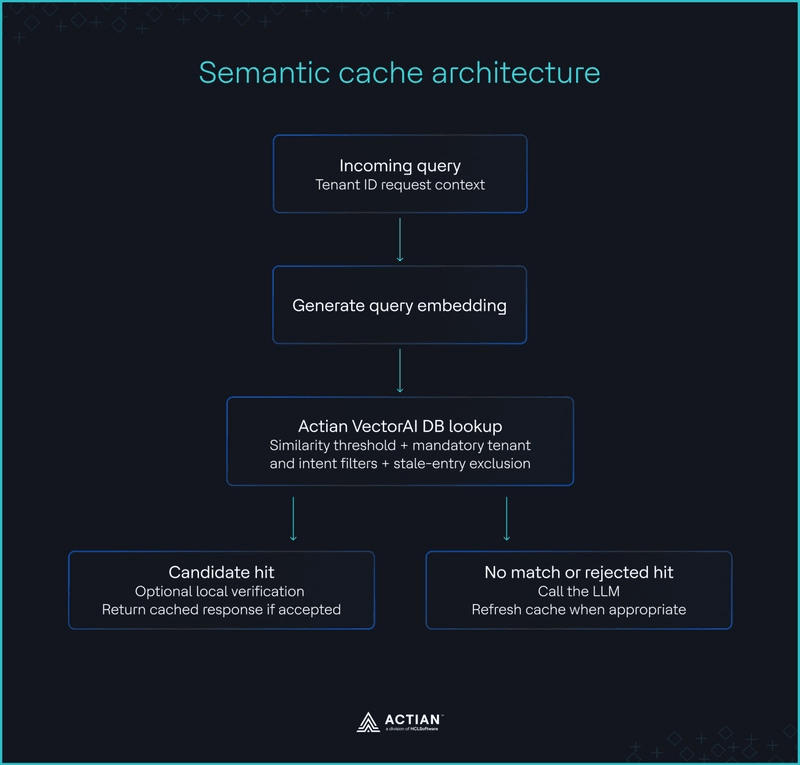
作者存入 Banking77 数据集中的 3,075 个问题,覆盖 77 类银行客服意图,没有超过 Community Edition 的 5,000 向量上限。查询使用同一数据集的另外 770 个问题,嵌入模型为 sentence-transformers/all-MiniLM-L6-v2。
实验把意图不同、跨模拟租户、引用已变化来源的命中算作错误。文中的 FPR 是「错误命中数 ÷ 全部命中数」,目标不超过 5%。这个口径必须记住,它衡量的是返回缓存后有多大概率出错。
扫描阈值的命令如下,用来观察命中率与错误比例怎样一起变化:
uv run python test1_threshold_sweep.py --threshold 0.80
要看的是 --threshold 0.80:后续实验统一使用这个值,以便复现文中的数字。扫描范围则是 0.50 到 0.99,阈值在一半查询上校准,再用另一半验证。
0.80 下共有 610 次命中,其中 39 次错误,FPR 为 6.4%。两个都在问转账没成功的问题,相似度达到 0.921,但数据集分别标成 declined_transfer 和 failed_transfer。提高到 0.83 后,留出查询上的 FPR 降至 4.8%,命中率也降至 70.1%。
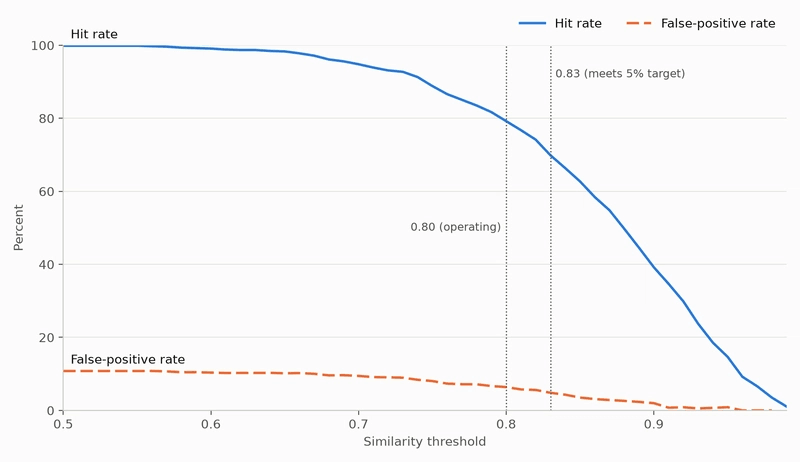
阈值应该服从正确率目标,而不能只追求更多命中。
否定词和金额,为什么不能靠提高阈值解决
向量擅长判断话题接近,却未必能守住决定答案的细小差异。「应该取消卡吗」和「不应该取消卡吗」,主题几乎一致,回答却可能相反。
作者用模板构造问题对:缓存其中一个,再拿另一个查询,同时用真正的同义改写检查正常复用有没有被破坏。对应测试可以一起运行:
uv run python test2_negation.py --threshold 0.80
uv run python test3_numbers_dates.py --threshold 0.80
这里仍需保持 --threshold 0.80,才能比较规则检查与单纯调高阈值的差别。
75 个否定问题中,74 个触发了缓存复用,占 98.7%。「Should I not cancel my card?」与「Should I cancel my card?」的相似度达到 0.990。否定问题对的相似度中位数是 0.946,甚至高于真正同义改写的 0.936;测试到 0.99,也没有哪个阈值能挡住 95% 的否定错误。
加入一条简单检查:只有一边含否定表达就拒绝匹配,错误复用占比降至 4.0%,同义改写复用率保留在 72.1%。
金额和日期也类似。38 个改变数值的问题全部命中,$2500 与 $250 的相似度为 0.962,21 June 与 21 July 为 0.964。阈值要升到 0.97,才能挡住 95% 的这类错误,但同义改写复用率会从 95.5% 跌至 13.6%。对数字和日期词做精确一致性检查,则挡住了全部变值问题,同时保留 95.5% 的改写复用率。
规则也有边界:否定词检查可能漏掉间接语义变化;数值检查无法把「fifty dollars」和「$50」识别为相等。原文没有证明这些简单规则能覆盖真实语言的全部变化。
哪些边界该交给过滤,哪些才需要模型复核
租户隔离首先是检索条件。三个模拟租户共用缓存时,610 次命中有 409 次跨租户;在 VectorAI DB 查询中加入 tenant 的 MUST 过滤后,跨租户命中全部消失。
意图过滤更难。轻量分类器的意图预测准确率为 88.4%;按意图分别校准阈值,FPR 仍有 9.6%。每类只有约五条校准问题,样本量限制了效果。
查询长度反而提供了一个便宜的分组依据。八词及以下的问题占查询量的 43%,却贡献了 39 次错误中的 27 次,FPR 为 9.4%;九到十一词为 2.9%,更长问题为 4.6%。短、中、长查询分别采用 0.87、0.80、0.83 后,留出集 FPR 降至 2.0%,命中率为 64.2%。
缓存还会过期。作者把 77 类意图当作来源,模拟其中 15 个来源变化,FPR 升至 24.9%,其中 113 次命中的意图正确,答案却已过时。一次带过滤条件的 set_payload 调用,把相关 600 条记录标记为 stale,再用 MUST NOT 排除它们,FPR 降至 11.4%,命中率为 67.4%。剩余错误来自相邻意图,说明失效处理还应配合缓存补充或意图过滤。
最后一道防线是复核模型。作者在 Apple Silicon M3 MacBook 上使用 Mapika/decider-0.8b,判断两个问题能否共用回答;原文称 decider-4b 等更大模型需要 GPU。测试先通过 --export-hits data/test5_lookups.json 导出,再使用 uv run --extra decider python test5_decider_verify.py,配合 --model Mapika/decider-0.8b、--max-hits 100、--hits-file data/test5_lookups.json 运行。
yes 概率截断值为 0.5 时,100 次命中里的六次错误抓住四次,却也拒绝了 94 次正确命中的 25 次,占 26.6%。batch size 为一时,延迟中位数为 106 ms,95 分位为 116 ms。截断值改成 0.3,只误拒两次正确命中,也只抓到一次错误。这个样本只能算初步结果。
我的判断
我认同作者把错误比例放在命中率旁边,也认同租户、来源版本、关键数值应有明确约束。相比不断提高相似度门槛,这些检查更贴近「答案是否还能用」的实际条件。
但这些数字不能直接成为生产配置。实验来自 Banking77 和一个嵌入模型;意图标签也不能完全代表两个问题能否共享回答。转账案例的标签不同,未必足以证明具体答案一定不能复用,因为实验没有逐条验证答案内容。否定、变值来自模板,租户和来源变化来自模拟,真实业务表现还需重新测量。
按英文词数设置的分组阈值,也不能直接搬到中文查询。原文没有提供中文结果,更没有给出完整的成本收益对照。模型复核增加百毫秒级延迟,并损失部分正确命中,是否划算取决于模型调用成本和错误代价。目前更适合把它看作退款、取消等敏感意图的候选措施,不能据此认定每次命中都值得复核。
能拿来做什么
- 给现有 AI 服务抽取一批真实查询,人工标注能否复用答案,在监控中同时展示命中率和错误命中占比,再按自己的目标扫描阈值。
- 在 Node 检索层为缓存记录保存 tenant、intent、source,把租户约束写进查询过滤;来源变化后标记 stale,并在搜索时排除。
- 为否定表达、金额和日期建立回归样本,单独统计这些问题的错误复用情况;先验证简单检查能挡住什么,再决定是否增加语言归一化。
- 复现实验需要 Docker、Python 3.11 或 3.12、uv。进入仓库的
developer-content/blog/semantic-cache-fp后运行docker-compose up -d、uv sync,用docker ps确认容器启动;首次运行会下载数据集和模型,测量结果写入results/,最后通过uv run python make_table.py汇总。