自部署推理引擎怎么选,先看缓存怎么复用
文章梳理 SGLang 和 vLLM 的共性,重点讨论 KV 缓存复用机制及如何控制评测变量。文中实测数据来自 RTX 4090 上的 vLLM,SGLang 部分依据项目说明。
AI 深度解读
自托管开源大模型时,SGLang 和 vLLM 都能接入 OpenAI 风格的客户端,也都支持前缀缓存。真正影响选型的是你的请求能复用多少计算,以及在实际负载下,哪套引擎能把首 token 延迟和吞吐稳定在目标范围内。
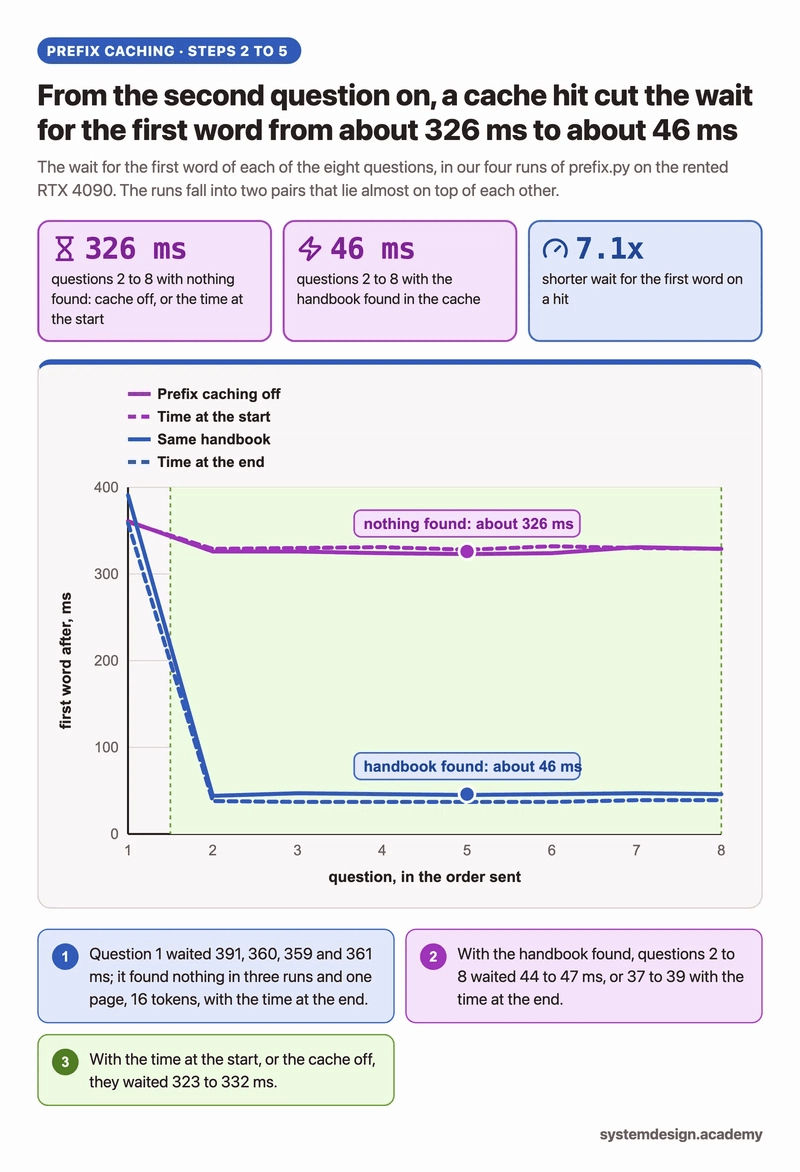
作者在一张租用的 RTX 4090 上测到,同一份长手册被缓存后,vLLM 的首词等待从约 326 ms 降到 46 ms。把时间戳挪到提示词开头,缓存命中率又从 87% 掉到 0%。这些数字都来自 vLLM,作者还没实测 SGLang。这个案例最有用的地方,是它告诉你怎样改提示词,以及怎样避免在压测里把缓存收益算成引擎优势。
两套服务能共用客户端,切换时要核对服务端
SGLang 和 vLLM 都是开源模型服务器。它们把模型加载到一张或多张 GPU 上,同时处理多条请求。vLLM 源自加州大学伯克利分校,2023 年的论文提出了 PagedAttention。SGLang 来自 LMSYS,提出了用来复用请求前缀的 RadixAttention。作者在 2026 年 11 月 12 日核对的课程版本是 vLLM 0.33 和 SGLang 0.5.23。
两套引擎都支持连续批处理,让请求在每轮生成时加入或离开批次。它们也都支持分块预填充(chunked prefill),把长输入拆开处理,减轻它对其他请求的阻塞。张量并行、量化、推测解码、按 JSON Schema 或语法约束生成,以及将模型输出解析成 OpenAI 格式的工具调用,也都在两者的能力范围内。
业务端通常可以保留 OpenAI SDK 和 /v1/chat/completions,主要调整服务地址和模型名。作者用 OpenAI Python SDK 请求 RTX 4090 上的 Qwen3-0.6B,首次收到输出用了 0.167 秒,token 计数仍在 usage 字段里。真实切换还要检查启动命令、配置名和引擎额外接受的请求字段,并用业务请求验一遍结构化输出与工具调用。
前缀缓存命中多少,取决于提示词从哪里开始变
模型读取输入时,会为每个 token 计算注意力所需的键和值,并把它们存在 KV cache 里。后续请求如果从开头逐 token 匹配,就能直接用已经算好的那一段,省掉重复的预填充工作。
vLLM 默认每页存 16 个 token,用块表记录每段会话用了哪些页。每个完整页的哈希由本页 token 和前一页哈希共同决定。第一页有变化,后面即使有一整页文字完全相同,它的哈希也会变。SGLang 则在共享内存池里存放缓存,用基数树(radix tree)索引前缀。相同开头的请求共用一段路径,查找时沿树走到最长的匹配前缀。
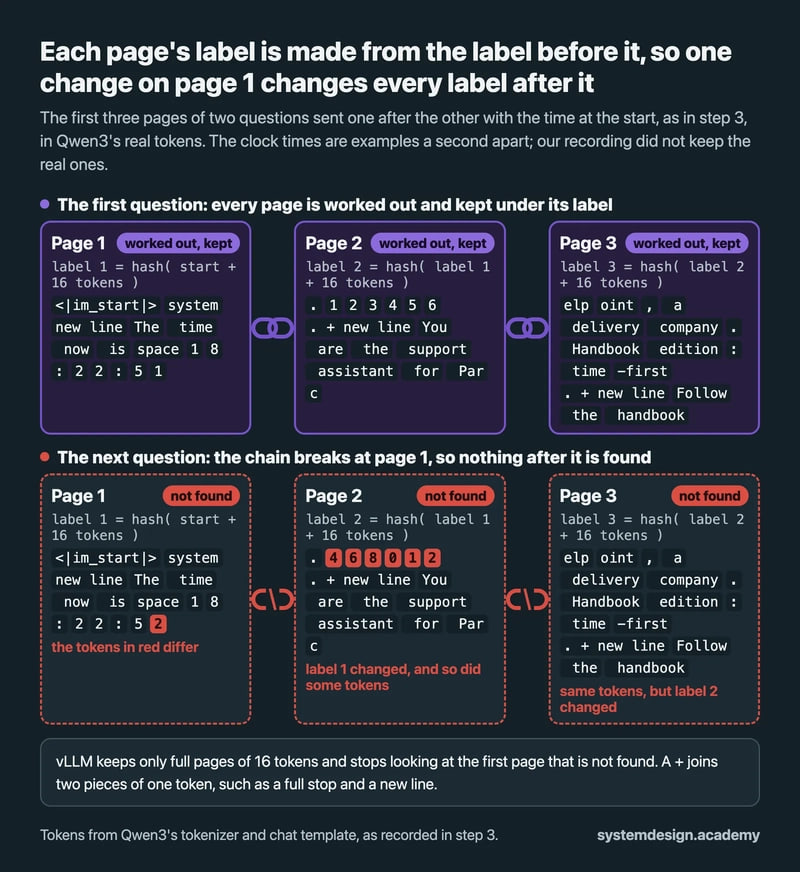
作者在 vLLM 上把 8 个问题接在同一份 2,958 token 的手册后面,输入前缀缓存命中率为 87%,首词等待从约 326 ms 降到 46 ms,等待时间约为原来的七分之一。时间戳放在系统消息开头,命中率降到 0%。同一行挪到系统消息末尾,命中率回到 86%,图里的首词等待约为 37 ms。请求编号、用户名和顺序不稳定的工具列表,也可能在开头提前截断可复用的前缀。
分页本身也能省显存。同一张卡跑 Qwen3-8B 时,vLLM 分出了 2,076 页。64 条各约 340 token 的会话同时占用其中 66.8%。如果按每条会话预留 32,768 token 的方式算,同样的缓存空间只够放一条。
对比引擎时,要把缓存状态也算进实验条件
先固定模型文件、数值精度、GPU、驱动和显存分配比例,再从启动日志核对两边实际拿到了多少 KV cache 空间。调度策略的默认值也可能随版本变化。作者用相同配置启动 Qwen3-8B,第一次拿到 33,216 token 的缓存容量,第二次拿到 38,000。用两边各自的第二次启动做对比,并在正式计时前预热,可以减少首次编译和工作空间测量造成的干扰。
测无缓存性能时,每轮生成新的问题,把输入输出长度、并发数或到达率以及采样设置对齐。在 vLLM 上可以检查 vllm:prefix_cache_hits_total 在测试期间是否保持为 0。vLLM 0.33 的 vllm bench serve 默认也不会发送 temperature,需要这个参数时要显式加上。要测前缀复用,就另跑一组,按业务里的共享前缀和变化位置组织请求。
每个负载档位用数百条请求,记录样本数,确认失败请求数为 0,并重复几轮。作者那组只有 48 条回答,测出来的 p99 就是最慢的一条。对比时把首 token 等待和相邻输出 token 的间隔都报出中位数、p99,再加上总吞吐量和多轮波动。推测解码也要按实际负载测。vLLM 0.33 支持 n-gram 匹配、草稿模型、EAGLE-3 和多 token 预测,SGLang 也支持 EAGLE 类方法。作者认为低负载更容易获得收益,服务器忙时,额外的校验工作可能拖慢生成。
我的判断
最能直接采用的是调整提示词顺序。它有同一套 vLLM 环境下的实测支撑,而且对于反复发送长系统指令或文档的应用,改动通常集中在提示词组装层。具体能省多少,要看生产请求共享的前缀长度、请求是否集中到有缓存的实例,以及这些前缀能在显存里保留多久。课程实验给出了固定手册下的结果,生产流量和多实例路由仍需单独验证。
作者把 vLLM 当作更稳妥的默认起点,依据是模型支持、配置、集成和学习资料的覆盖面,还举了 Kubernetes 上的 llm-d 使用 vLLM 的例子。SGLang 的基数树和自带的编程前端,则让多分支、连续结构化调用这类负载值得实测。由于没有同卡、同模型、同流量的对照,选型建议仍是经验之谈。团队已经跑着 vLLM 时,可以先调整前缀布局,再把优化后的现有服务作为换引擎的基线。
能拿来做什么
- 在 Node 服务里集中管理系统消息模板。把长规则、固定文档和顺序稳定的工具定义放在前面,把当前时间、用户信息和本轮问题放在后面,并检查调整后的回答是否仍符合预期。
- 用同一组业务请求验证两个 OpenAI 兼容端点。除了普通流式回答,也检查首 token 等待、
usage、工具调用字段和 JSON Schema 输出,确认客户端所依赖的行为。 - 为上线压测各准备一组全新前缀和一组高复用前缀,在典型并发和高峰并发下多跑几轮。把缓存命中、延迟分位数、吞吐和失败数一起记录,再决定是否切换引擎或开启推测解码。