客服 Agent 如何跨会话保留客户知识
RecallCare 将会话记录与客户长期记忆分开管理,使用 React、FastAPI、SQLAlchemy 和 Hindsight 构建客服应用。文章讨论这种划分如何影响上下文检索、提示词、故障处理与界面展示。
AI 深度解读
让客服 AI 记住用户的电脑型号,并不等于它能接着上次的问题聊。新建会话后,旧记录去哪里找、偏好变更听哪条、记忆服务故障时还能不能回答,都需要应用自己定义规则。
作者开发的 RecallCare 给出了一种拆分:聊天记录跟着会话走,长期知识跟着客户走。Hindsight 负责跨会话记忆,关系数据库保留每条线程的对话。值得借鉴的不是「加上记忆」这个功能,而是两种上下文如何配合,以及系统怎样处理过期信息和不确定性。
跨会话连续性,靠的是客户身份
RecallCare 的前端使用 React,提供仪表盘和对话页面;后端采用 FastAPI,通过 SQLAlchemy 保存客户、会话和消息,由 LLM 生成回复,Hindsight 保存和检索跨线程的客户信息。
两类数据回答的问题不同。聊天记录回答「这次对话刚才说了什么」,长期记忆回答「回复这个客户前,有哪些历史事实值得参考」。把所有历史消息塞进每次请求,既浪费上下文,也会让无关内容干扰当前问题。
作者把每位客户映射到一个稳定的 Hindsight bank,可以理解为客户专属的记忆空间。下面这段代码解决的是:同一客户开启多少条会话,都能找到同一个空间。
def get_customer_bank_id(customer_id):
    customer_hash = hashlib.sha256(
        str(customer_id).encode("utf-8")
    ).hexdigest()[:24]

    return f"recallcare-{customer_hash}"
要看的是 [:24]:客户 ID 经过 SHA-256 后,取前 24 个十六进制字符,再加上 recallcare- 前缀。这里的输入是客户 ID,因此新会话不会切断旧记忆。它避免在 bank 名称中直接暴露数据库 ID,但访问隔离仍要由鉴权和权限校验完成。
请求进入后,后端先确认客户身份及其对目标会话的访问权限,再检索相关记忆、读取当前线程的近期消息,把两者交给回复生成器。随后保存用户和助手消息,再将客户原话写入 Hindsight。
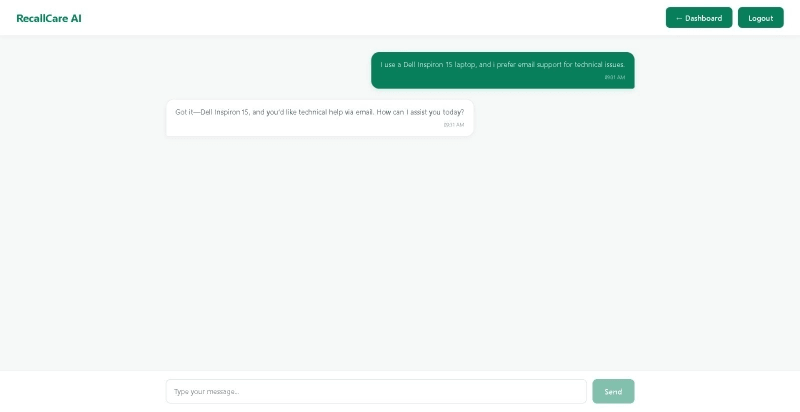
例如,客户此前提供过 Dell Inspiron 15 型号,并报告充电异常。另开会话后只说「更新后又充不上电了」,系统就有机会从客户记忆里找回设备和旧问题,减少重复询问。换成另一位客户,则应进入另一套记忆空间。
长期记忆补历史,最近 20 条消息接住当前对话
只有长期记忆也不够。用户回复「试过了,还是不行」时,助手需要知道刚才建议了哪一步。设备型号和历史偏好无法替代这段即时语境。
RecallCare 读取当前会话最近 20 条消息,按时间顺序排列,并给两类上下文分别添加 LONG-TERM CUSTOMER MEMORY: 和 CURRENT CONVERSATION CONTEXT: 标签。标签让模型知道信息来自哪里、适用于哪个范围,但它仍然需要明确的使用规则。
历史检索也不能只是「把这个客户的记忆都拿来」。下面的查询把当前问题和客服常用信息类型放在一起,帮助检索贴近这次请求。
customer_memories = await recall_memory(
    customer_id,
    (
        f"{message}. Retrieve relevant information about this "
        "customer from all previous conversations, including "
        "devices, preferences, contact methods, reported issues, "
        "previous support interactions and resolutions."
    )
)
要留意 f"{message} 所在的那一行:当前消息是检索依据;后面的设备、偏好、联系方式、历史问题和解决方案,则提示检索关注哪些事实。作者认为这样能减少遗漏,但没有给出召回率或与其他查询方式的对照数据。
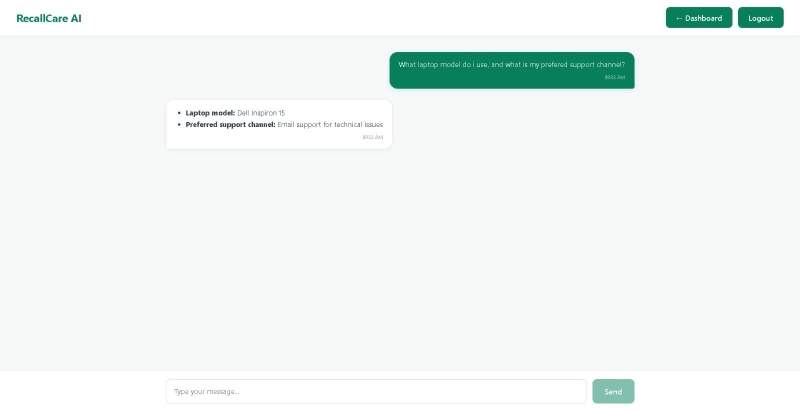
工程上,作者把 Hindsight 客户端封装在独立模块中,集中处理环境配置、bank 创建、retain、recall 和有效记忆列表,并通过 FastAPI 的 lifespan 初始化和关闭连接。回复生成器只接收准备好的上下文字符串,不需要知道 bank 如何命名、SQL 如何查询。
记忆检索失败时,聊天接口记录错误,然后带着空的长期记忆继续生成回复。当前消息和近期对话仍然可用,代价是回答可能少一些历史依据。作者提出,生产环境应通过运行遥测明确暴露这种降级;原文没有展示这部分已经落地的监控方案。
存下用户原话,不代表已经得到可靠事实
客户上次说「发邮件」,这次说「请改成电话联系」,两条都存下来很容易。下一次应该用哪条,才是记忆系统真正要解决的问题。
RecallCare 在助手回复保存后,将客户消息连同时间戳写入 Hindsight。提示词要求模型关注日期:有明确日期的较新更正,应优先于旧信息;如果无法判断先后,就向客户确认。
时间戳能帮助排列陈述,却不能证明陈述为真。
原文也承认,系统保存的是客户消息,还不是经过验证、具有权威来源和完整纠错流程的客户档案。两条措辞不同的记录是否指向同一种偏好,也未必能可靠判断。
仪表盘承担了另一部分工作:清理格式残留,去除完全重复和近似重复的记录,再按设备信息、支持偏好、历史支持活动及其他信息分组。遇到较新的明确偏好更新,可以在默认视图隐藏旧冲突项;无法判断邮件和电话哪个有效时,则直接显示冲突,并允许展开全部记录。
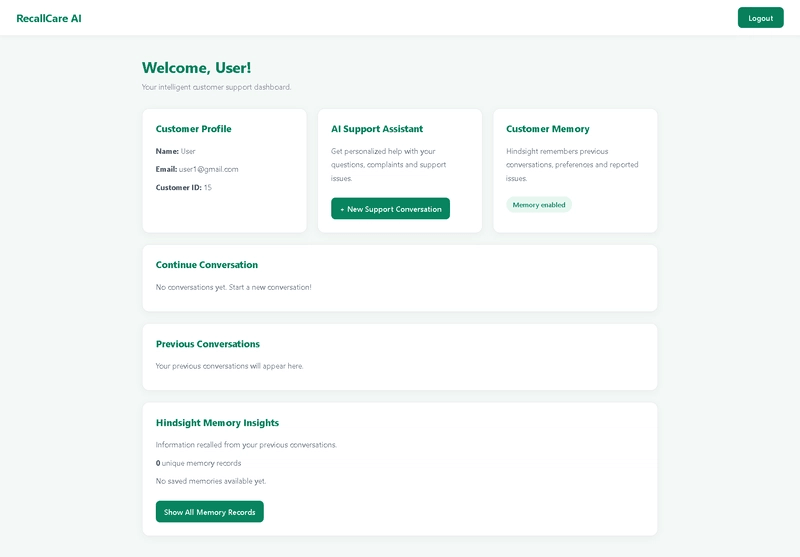
这里要区分「界面隐藏旧记录」和「底层记忆已经修正」。作者描述的是读取时的展示整理,不能据此认定 Hindsight 内部的冲突也被消除了。
提示词还约束助手:不能编造客户详情,不能在已有记忆时声称信息缺失,也不能在应用未确认时声称记忆已保存。最后一条尤其影响用户信任,因为保存发生在回复之后,模型不能预先替一次尚未完成的写入作保证。
我的判断
我认同这套职责拆分。相较于把旧聊天全部拼进 prompt,它让数据归属和失败边界更清楚:数据库保留有序对话,Hindsight 提供相关历史,生成器决定如何组织回答。React 页面再把记忆及冲突展示出来,方便人检查。
但这仍是一份实现经验,不能当成效果评测。原文展示了跨会话取回设备和偏好的交互,没有提供检索准确率、响应延迟、成本或冲突处理成功率。最近 20 条消息也是作者的选择,未必适合排障过程更长的团队。
客户级 bank 是否适用,还取决于身份体系。共享账号、组织账号和多人代办场景里,账号与实际使用者可能并非一一对应。稳定映射只能保证数据总能找到,不能保证找对了人。
也不是所有偏好都需要靠自由文本记忆推断。已经确认的首选联系方式,更适合放进有明确更新规则的结构化字段;历史故障描述和零散上下文,则更适合选择性检索。原文没有比较这两种做法,不能据此判断专用记忆服务一定优于普通数据库方案。
能拿来做什么
- 给现有客服聊天增加跨会话能力时,先明确客户 ID 与会话 ID 的职责,再集中封装客户到记忆空间的映射。不要让每个接口自行拼接记忆标识。
- 在 React 对话页之外增加可检查的记忆视图,展示来源记录、时间和冲突。默认视图可以简化,但应让用户有办法看到判断依据。
- 无论后端采用 FastAPI 还是 Node,都可以把记忆检索与回复生成拆开,并定义检索失败后的降级行为。日志或监控需要区分「没有相关记忆」与「记忆服务请求失败」。
- 编写 AI 客服提示词时,明确规定日期冲突、信息缺失和保存确认的处理方式;对已经确认且需要准确执行的联系方式等字段,另行设计确定性的更新流程。