视觉模型双引擎部署的显存与输出差异
作者用相同的 14 个请求对比 WeVisOne-VL-4B 的 vLLM 与 Transformers 部署,观察内存、延迟及输出差异。分割依赖模型内部状态,而 vLLM 路径还需加载 Transformers 模型,带来额外权重开销。
AI 深度解读
WeVisOne-VL-4B 能把检测、计数、分割和抠图放进同一个模型,但部署时,真正左右显存、速度甚至答案的,还有推理引擎。作者把相同的 14 个请求分别交给 vLLM 和 Transformers,发现快的一条路需要装下两份权重,同一张棋盘也能少数一枚棋子。
对准备把视觉模型接进 API 的开发者,这篇最有用的不是跑分,而是一组部署边界:24 GB 显卡为什么启动失败,确定性解码为什么仍会给出不同答案,以及模型跑通之后,接口还会在哪些地方出问题。
为什么用 vLLM,反而要装两份模型
WeVisOne-VL-4B 来自腾讯 WeChat Vision 团队,底座是阿里巴巴的 Qwen3-VL-4B-Instruct。一个 4B 检查点支持按名称找物体、计数、点选、带位置的文字识别,以及轮廓分割和抠图。
这些任务并不全靠生成文字完成。模型用四个位置 token 表示一个框,两个表示一个点;做分割和抠图时,还会在框后生成标记 token。另一个拥有 960 万参数的 mask_decoder.pt 读取标记位置的内部状态,再生成像素掩码。
问题出在引擎接口上:vLLM 返回文本,却没有交出这个解码器需要的内部状态。因此,使用 backend="vllm" 时,软件包还会加载完整的 Transformers 模型,把答案重新过一遍,取出内部状态。
在这套实现里,vLLM 的速度收益,需要用第二份模型权重换取。
半精度权重约 10 GB。RTX 4090 上,双模型路径的峰值显存达到 23.0 GiB,而 Transformers 单独运行是 12.3 GiB。分割解码器本身不大,却让整条推理链路变重了。
24 GB 显存为什么还要反复调参数
软件包默认给每个提示预留十张图片、十段视频的空间,4090 因而没有余量分配 KV cache。它是模型保存已处理 token 状态的缓存,也要占显存。
下面这段启动日志能直接定位问题:
Encoder cache will be initialized with a budget of 16384 tokens
Available KV cache memory: -0.87 GiB
ValueError: No available memory for the cache blocks
关键是第二行:可用缓存空间已经是负数,失败发生在服务启动阶段。
作者编写的自定义 Python 后端封装了 vllm.LLM,限制每次请求一张图片、不接收视频、最多四个在途请求,并缩短上下文。参数也经过几轮试错:给 vLLM 分配显卡的 0.5,大尺寸人像抠图会耗尽显存;降到 0.465、上下文设为 4096 token,缓存又不够;最终使用 0.465 和 3072 token,14 个请求全部通过。
这只是窄余量下的一组可用配置。作者逐个发送请求,没有验证并发,配置允许四个在途请求不能当成四并发压测结果。
任务类型也必须分开算。分割解码器一次约需 0.8 GB,与照片尺寸无关。把 4090 限制成严格的 12 GB 后,框选、计数、点选、文字识别仍能通过,轮廓和抠图却全部失败,连 640 像素图片也不例外。
贪心解码为什么还会数出不同答案
原始棋盘照片有 16 枚白棋。vLLM 用 1.35 秒数出 15 枚,漏掉 g5 的白马;Transformers 用 3.87 秒得到 16 枚。
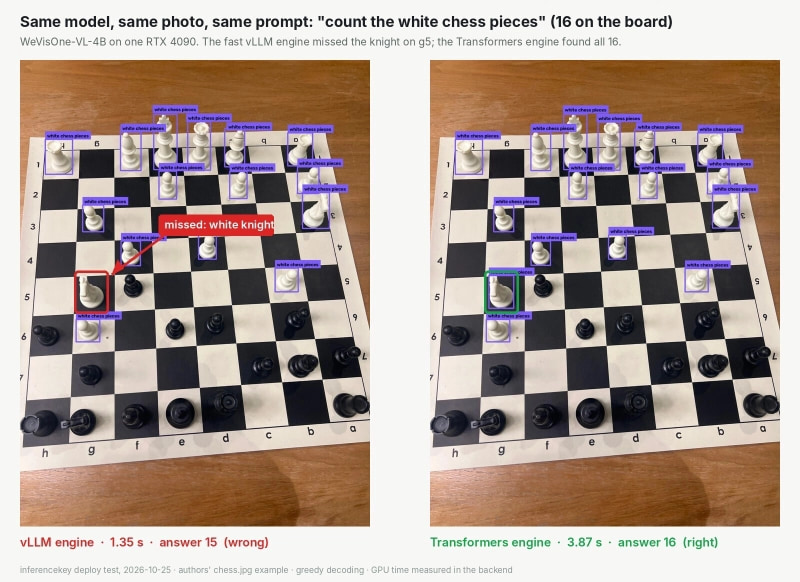
两边都使用贪心解码,每一步选择概率最高的 token,没有随机抽样。作者推测,不同实现的数值舍入差异让一个临界候选框落到了不同结果。这是合理解释,但原文没有给出定位证据。
另外两组输出也不同:街道路牌识别出 29 个词和 21 个词,悬挂花盆数出 19 个和 20 个。样本不足以计算可靠的错误率,却足以提醒部署者:
评测必须覆盖最终上线的推理引擎。
接口层还有两笔账。一次预热后约 1.9 秒的检测,冷启动首次请求需要 14.5 至 15.5 秒,因此作者建议启动时发送预热请求。平台还会丢弃超过 8 MB 的响应,让调用方一直等到 HTTP 504。后端随后把结果控制在 5.2 MB 内,使用 JPEG 叠加图和 1280 px 抠图;平台侧等待完整超时的问题仍未解决。
我的判断
我赞同先用 Transformers 建立参考结果。作者实际测过、通过全部 14 个请求的最小显卡,是 16 GB 的 RTX 5080,峰值为 12.8 GiB。它处理 1620 × 1080 人像抠图耗时 2.1 秒,4090 的 vLLM 路径是 1.0 秒;物体类任务最多慢到四倍。不过,这组比较同时更换了显卡和引擎,不能全部归因于引擎。
目前后端在总显存至少 22 GiB 时选择 vLLM,否则选择 Transformers。这适合作为作者环境下的起点,不能直接当成通用分界线。
还有几处证据边界:0.1.3 把测试参数设成默认值,但该版本自身尚未经过 GPU 运行;实测的是手动传参的 0.1.0 至 0.1.2。12 GB、8 GB 数据来自限制 4090 显存,并非真实小显卡;完整报告还涉及 8 GB 限额下的 2B 模型,当前原文没有展开结果。
模型团队宣称在超过 30 项基准上领先,其中按名称寻找物体的得分为 55.3,GroundingDINO 为 38.8。作者没有复跑这些基准,只做了目视检查和棋盘手工计数。因此,这份文章能支持部署经验,不能替代系统性的准确率评测。
能拿来做什么
- 接入视觉 API 前,先按文字输出、框选、分割和抠图建立任务样本,分别记录峰值显存,并覆盖业务实际使用的图片尺寸。
- 更换 Transformers 或 vLLM 时,用相同图片重新检查数量、框和文字结果,同时记录耗时,别把贪心解码当成跨引擎结果一致的保证。
- 用 Node 或其他服务封装接口时,把预热和响应体积纳入联调;前端需要展示的叠加图、抠图,应提前约定格式与尺寸。
- 复用作者参数时,连同软件版本和上下文长度一起固定,并补做真实并发测试,再决定实例容量。