Qwen 小模型权重微调能缓解推理循环吗
研究人员无需训练便修改了 Qwen3.5-0.8B 两层的部分权重,涉及全模型约 0.016% 的参数。作者用 vLLM 在一张 RTX 4090 上对比原版和修改版,复测 MATH-500 的前 50 题,并讨论如何衡量推理循环、在服务端固定采样参数。
AI 深度解读
小模型在推理里反复打转,先吃掉的是 GPU 容量。每条跑满 token 上限的请求都会一直占着推理槽位,最后还可能没有可解析的答案。MIT CSAIL 的研究者没重新训练 Qwen3.5-0.8B,只改了 0.016% 的权重,就减少了这类循环。
原文作者用同一张 RTX 4090 跑了原版和修改版,在前 50 道 MATH-500 题上,修改版答对更多,生成的 token 也更少。对要把模型接进应用的程序员,这次实测还有两个直接收获:采样参数可能被网关丢掉,流式响应也可能悄无声息地中断。
每道题能不能收尾,比只看正确率多告诉你什么
Qwen3.5-0.8B 会先生成一段推理过程,再给出答案。Qwen 的模型卡提醒,这个尺寸的模型更容易陷入思考循环。MIT CSAIL 的研究者让他们称为 GPT-6 Astra 的大模型读取模型内部结构,在两个层里各修改 64 列权重,共改动 131,072 个数值,占模型的 0.016%。Hugging Face 用户 akhaliq 和 ML Intern 用 HF Jobs 重建并校验了权重文件,也重跑了 MATH-500。
原文作者通过 vLLM 在一张 RTX 4090 上部署两个版本,取 MATH-500 的前 50 题对测。修改版共生成 102 万 token,原版生成 159 万。按总生成量除以答对题数,修改版每答对一题约花 3.3 万 token,原版约花 39.8 万。原版只答对 4 题,分母很小,倍数只能粗看。配套测试报告的标题还给出一个更直观的变化,思考循环比例从 93% 降到约 32%。
修改版在这 50 题上拿到 62%。MIT CSAIL 作者在全部 500 题上报告 48.1%,akhaliq 的全量复跑是 51.0%,取同样 50 题则是 54%。原文作者倾向于把差距归因于样本量。另一组结果也提示了方法的适用范围:Gemma 3 270M 原本只有 8.5% 的回答触顶,应用同一方法后,MATH-500 成绩落在 6.8% 到 7.7% 之间。
采样参数为什么要固定在服务端
采样参数决定模型每一步怎么选下一个 token。论文结果使用开启思考模式、temperature 为 0.6、top_p 为 0.95、top_k 为 20、presence_penalty 为 1.5 的组合。其中 presence_penalty 会降低已经出现过的 token 再被选中的倾向。
他们的平台 API 会转发 temperature、top_p 和 presence_penalty,却会丢掉 top_k 和开启思考模式的聊天模板开关。下面两行把这组设置固定到 vLLM 服务端。
--default-chat-template-kwargs '{"enable_thinking": true}' \
--override-generation-config '{"temperature": 0.6, "top_p": 0.95, "top_k": 20, "presence_penalty": 1.5}'
第二行里的覆盖配置会出现在 vLLM 启动日志中。对照跑分前先核对这行,尤其是请求经过网关后容易丢失的 top_k。
同卡跑两个引擎,吞吐量为什么没法直接比
两套引擎各配置使用 24 GB 显卡的 0.45,实测显存峰值为 16.9 GiB。因为两套引擎同时启动,在同一时刻检查可用显存,原版拿到了 6.48 GiB 的 KV cache,修改版只拿到 3.32 GiB。KV cache 保存正在生成的请求所需的中间状态。修改版更早开始排队,这次的吞吐量因此无法直接对比。原文建议依次启动引擎。
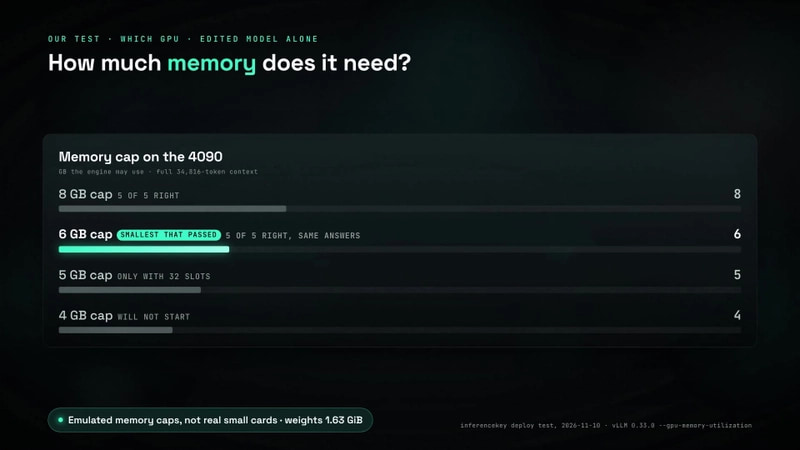
他们还让修改版单独跑,在 34,816 token 的上下文配置下,用 4090 限显存,复跑 5 道已经答对的题。8 GB 和 6 GB 都答对 5 道。限到 5 GB 时,得把 --max-num-seqs 从 256 降到 32 才能启动,4 GB 则始终起不来。
流式连接结束时,客户端还得检查什么
一条原版回答在第 152 秒突然停住,客户端既没收到错误,也没收到结束标记。作者怀疑触发了平台的两分钟静默超时,而示例脚本漏读了携带错误的数据块。这个原因尚未确认,问题仍未关闭。
流式客户端应逐块检查 error,并用 finish_reason 判断生成是否正常结束。连接已经断开但始终没收到 finish_reason 时,应把结果视为不完整。收到 finish_reason 后,也要区分正常结束和达到长度上限。
我的判断
这次实测最扎实的是在同一批题上同时看答对数和生成量。分数告诉你模型解决了多少题,触顶率和 token 用量让你看清有多少资源耗在没收尾的请求上。62% 来自前 50 题,测试只覆盖开启思考模式的数学任务。聊天、指令遵循、关闭思考模式和图像输入都没测。显存阶梯也来自 4090 上的五道已解题,真实小显存卡的启动情况和速度仍需实测。
工程上还有两条更省事的路。降低输出上限能限制单次请求的开销,也可能截断原本能解出来的题。检测流里的重复并提前停止,可以沿用原版权重,但效果取决于应用怎样识别循环。作者没把这两条路拉进同一轮对测。AI Search 视频提到原版换一组设置可到约 44%,也没交代数据来源,作者未核实。现有结果支持修改版在这次对测中的表现,几种方案之间的成本和效果排序还没有数据。
能拿来做什么
- 给 Node 跑分脚本加上答对数、触顶率和生成 token 总量。记录每题的结束原因,方便回查高开销请求到底卡在哪里。
- 用同一批输入对测两个模型时,从 vLLM 启动日志核对实际采样配置。同卡部署再记下各引擎的 KV cache 容量,确认是否具备比较吞吐量的条件。
- 给前端流式界面保留「生成中断」状态。逐块读取
error,连接结束时检查finish_reason,把不完整的回答留在可重试状态,避免交给下游当作完整结果解析。