单卡跑 256K 上下文,显存余量有多紧
作者称使用 vLLM 0.32.0,在单张 RTX 5090 上部署 20.9GB 的 Groot-19B-A3B FP8 版本,成功启动 262,144 token 上下文并完成约 20.6 万 token 输入测试。文章解释权重与 KV 缓存的显存开销,并提醒 MoE 激活参数少不代表全部权重无需驻留。
AI 深度解读
Groot-19B-A3B 能不能在一张 RTX 5090 上跑满 256K 上下文?作者用 vLLM 0.32.0 实测,答案是能:262,144-token 窗口成功启动,205,525-token 输入也拿到了正确回答。但显存余量很薄,而且模型默认先思考,输出预算可能在正式答案出现前就耗尽。
这次测试最有用的,是把「装得下权重」「撑得起长上下文」和「能稳定提供服务」拆开验证。准备部署本地模型的程序员,可以从中拿走一套更具体的验收方法。
19B 模型为什么能塞下 256K 上下文
Groot 是从 Qwen3.6-35B-A3B 裁剪而来的混合专家模型(MoE),总参数约 190 亿,每个 token 只激活约 30 亿参数。激活参数少有利于生成速度,但 GPU 仍然需要容纳全部权重。
它继承了基础模型的混合架构:40 层中,只有 10 层为每个 token 保存完整的注意力缓存,其余 30 层维护较短的运行状态。理解这点很关键:长上下文的显存开销,不能只根据参数总量判断。
显存主要花在两处:固定占用的权重,以及随上下文增长的 KV cache。后者可以理解为模型处理前文时留下的工作笔记。
作者使用体积为 20.9 GB 的 FP8 构建,实际权重占用为 19.7 GiB。设置 --gpu-memory-utilization 0.92 后,vLLM 给缓存留下了 6.8 GiB,可容纳 307,024 个 token,比完整窗口多约 45,000 个。
启动日志给出的最大并发为 1.17x,指的是相当于 1.17 个满窗口请求的缓存容量。
能跑满 256K,不代表还能同时承接多个满窗口请求。
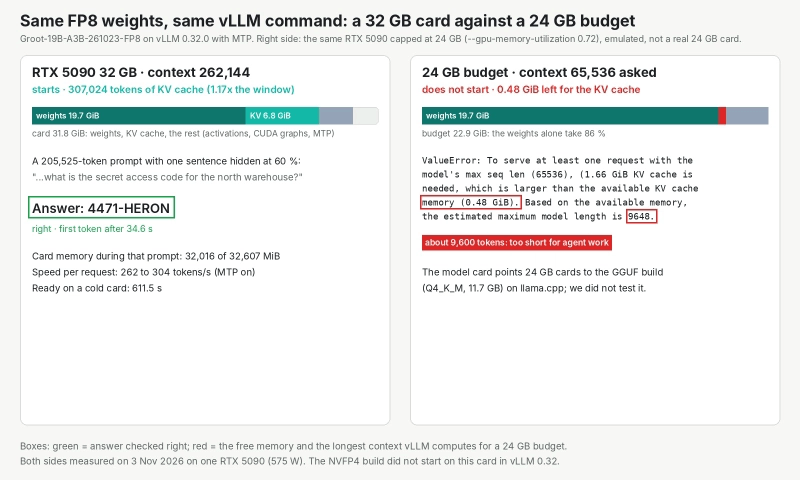
买卡之前,先看服务框架算出的缓存余额
作者没有更小显存的显卡,而是限制 RTX 5090 可用的显存预算。这能模拟容量约束,但不能代替真实的小显存显卡测试。
在 24 GB 预算下,权重已经吃掉约 86% 的空间。请求启动 65,536-token 上下文时,vLLM 报错。下面这段日志直接解释了失败原因:
ValueError: ... (1.66 GiB KV cache is needed, which is larger than the
available KV cache memory (0.48 GiB). Based on the available memory,
the estimated maximum model length is 9648.
重点看最后的 9648:剩余缓存只有 0.48 GiB,估算最多支持 9,648 个 token,远低于模型作者建议的 128K 最低上下文。针对这个 FP8 构建,测试作者建议按 32 GB 显存准备。
24 GB 显卡还有模型作者推荐的 11.7 GB GGUF 构建,可供 llama.cpp 使用,但这次没有测试。另一份 13.5 GB、以 4-bit 权重为主的 NVFP4 构建,在 16 GB 预算下也没启动成功,原因却是 GPU kernel 编译失败。
因此,不能把 NVFP4 的失败记成显存不足。它到底能不能装下,原文没有结论。
回答只有一个词,为什么也会耗掉上百个 token
Groot 默认在每次回复前推理,而推理也计入输出 token。
作者让它用一个词回答澳大利亚首都,模型在输出 Canberra 之前,就消耗了 111 到 131 个 token。要求写一篇 300 词短文,四次运行的总输出介于 2,383 到 7,156 个 token;其中两次统计到的思考部分分别为 2,043 和 6,785 个 token。
对 API 调用方来说,这直接影响 max_tokens:预算设得过紧,模型可能还没给出正文就被截断。
模型作者支持通过 chat_template_kwargs 按请求关闭思考,但测试方自己的 API 当时会丢弃这个字段,所以思考始终开启。这是测试平台的接入缺口,不能归为模型不支持关闭。作者建议暂时在服务启动时默认关闭思考,不过所给原文没有列出那条启动参数,不能据此补写命令。
性能数据也需要连同条件一起看:
- 205,525-token 输入的首 token 延迟为 34.6 秒,完整回答在 40.3 秒完成;显存峰值达到 32,016 / 32,607 MiB,作者因此建议同卡不要运行其他任务。
- 开启额外的加速层后,生成速度为每秒 262 到 304 token;关闭时为 170 到 211。该层会提前草拟两个 token,再交给主模型校验。
- 冷启动耗时 611.5 秒,主要用于引擎预热;相关工作缓存在磁盘后,重启预热缩短为 87 秒。
- 比较 Lisbon 和 Oslo 天气时,模型在一轮中并行发出两次
get_weather调用,端到端耗时 1.81 秒。
我的判断
这份测试支持一个明确结论:在作者的软件配置和单请求条件下,一张 RTX 5090 可以承载该 FP8 构建的完整窗口,并完成一次超长输入问答。它也证明,采购判断应该看权重加载后的缓存余额,单看模型文件大小不够。
但它没有证明长文推理质量。隐藏句子被成功找出,只说明模型能在该次测试中访问相关内容。多份文档之间的矛盾处理、复杂约束推理、持续多轮交互,都没有被充分验证。
速度结论同样要收窄。原文称加速收益约 25%,同时承认两组数据经过不同请求路径,因此不能把这个比例当成严格对照结果。此前 Sage-A1.5 单卡测试中的 API 开销结果,也没有在这次重新测量。
Terminal-Bench 2.1 的 52.1 分,以及 Qwen3.6-35B-A3B 的 43.8 分,来自模型作者。测试团队除两次工具调用外,没有运行多步骤 agent 会话。
这是一份部署可行性记录,还不足以成为生产容量和 agent 能力的保证。
与换用 GGUF 或更低位宽构建相比,FP8 方案在这里有更直接的实测依据;其他格式是否适合自己的卡,还需要把兼容性、缓存容量和实际输出一起验证。
能拿来做什么
- 部署时记录 vLLM 启动日志里的可用缓存 token 数,再用自己的最长输入测显存峰值;不要只检查权重能否加载成功。
- 在 Node 或其他 API 接入层确认
chat_template_kwargs能否透传,并分别检查思考开启、关闭时的输出,避免max_tokens截断正式答案。 - 为长文问答和 AI 编程任务分别测首 token 延迟、完整响应时间与并发请求;这次单请求成绩不能直接用于估算团队共享服务的容量。
- 验证工具调用时,既检查是否生成并行调用,也检查后续多步执行能否完成;一次天气查询不足以替代真实 agent 任务验收。