
8.0
热点
AI SCORE
工具产品2026-08-22 07:19
Cloudflare推出AI爬虫策略同步工具
Cloudflare Blog#Cloudflare#AI爬虫#SEO
Editor brief · 编辑速览
Cloudflare发布Bot Preference Sync功能,自动将robots.txt与AI爬虫访问策略同步,支持Search、Agent和Training三类机器人的权限管理。
我们始终在为客户的不同目标进行构建。有的客户想优化内容发现,有的客户想用最严格的安全策略保护内容。在这些不同的策略中,消减机器人流量有多种方式。有些机制只是声明你的偏好,假设爬虫出于善意;而另一些方式则通过 Bot Management 解决方案直接屏蔽来真正锁定内容。
我们认识到,在网站上维护多层保护是繁琐的。例如,有些情况下,你的 robots.txt 声明某个爬虫"禁止"访问你的网站,但你的执行规则实际上并没有屏蔽那个爬虫。当你声明的偏好和执行的规则不一致时,有些爬虫会将其作为忽略你偏好的依据,或者尝试绕过你的执行规则。
几年前,Cloudflare 宣布了一种更简单的方式来禁止 AI 在你的网站上进行训练,方法是解决其中两层问题:一个托管的 robots.txt 值,告诉固定的主要训练爬虫列表不要在你的内容上训练,以及针对训练爬虫的边缘执行屏蔽。2026 年 7 月 1 日,我们推出了更便捷的选项来管理不同类型的 AI 流量用例。你可以对网站上的 Search、Agent 和 Training 流量表达你想要的做法。
我们宣布推出 Bot Preference Sync,向所有客户开放,从 Free tier到 Enterprise 都可以使用。Bot Preference Sync 会反映你在 AI bot 配置中的设置,通过更新 robots.txt 中的相应偏好,并且可以随时开启或关闭。不再需要为一个用例维护一个静态文件:我们将帮助你定制 robots.txt,使其反映你已经为不同 AI bot 类别配置的内容。
多年来,这个领域最紧迫的问题是:"我的内容是否在未经许可的情况下被用于训练 AI 模型?"这是一个重要的问题,而且不会消失。与此同时,我们越来越多听到的问题是关于可发现性和参与度的。当有人向 AI 助手询问我的网站能回答的问题时,如何让我的内容出现?我的流量中有多少来自 AI 爬虫,多少来自真实的人?哪些内容实际上在带来推荐流量,它们的价值是什么?
答案因商业模式而异。可发现性和参与度是任何试图在现代网络上蓬勃发展的企业的关键和首要问题,但这两者的路径不同:电商商店可能希望一切都被爬取和训练,这样当购物者向聊天机器人询问"小户型最佳沙发"时,它的产品就会出现在结果中。依靠广告变现内容的发布者可能想要相反的效果:保留引导读者访问页面的搜索引擎索引,但将文章排除在模型训练之外,而且至关重要的是,能够验证其内容确实没有被未经许可使用。
没有单一的正确答案,这正是关键所在。你的控制措施应该反映你的策略,这就是为什么我们一直在构建工具,让你在每一层都能获得可见性和选择。Bot Preference Sync 将这些整合在一起,所以你设置的偏好就是你发布的偏好。
2026 年 7 月 1 日,我们提出了这样的观点:混合用途爬虫,或者说"将搜索、Agent 使用和训练合并在单一 User-Agent 后的爬虫",恰恰因为它们让人难以区分你想要什么和不想要什么,而使网站所有者处于不利地位。这一点仍然成立,我们对网站所有者透明度的立场没有改变。
但实现透明度有不止一种方式。我们希望奖励那些清楚表明自己身份以及如何使用他们爬取数据的运营商。为了爬虫验证的目的,同时执行搜索和训练的爬虫所有者需要提供额外信息,以便在设置"Disallow Training"时不会被屏蔽。这些要求是:
符合这些标准的领先 AI 模型和服务提供商的爬虫会公开追踪在 Cloudflare Radar 的 AI bot 透明度部分,其中包括实践被遵守的示例,以及未被遵守的示例。不提供透明度的爬虫不会得到宽待——当你在设置中禁止训练时,它们仍然会被屏蔽。换句话说,这是一种让透明度成为准入门槛的方式。
Bot Preference Sync 是一项新功能,它让你的 robots.txt 反映你已经在 Cloudflare zone 级仪表板上为 Search、Agent 和 Training 设置的 AI bot 偏好。如果网站所有者已经有 robots.txt 文件,Bot Preference Sync 添加的内容会被前置到现有内容之前,因此任何现有的 Disallow 指令都会保留。
网站所有者不再需要维护一个单独的静态文件,Cloudflare 根据你的配置生成或更新你的 robots.txt,这样你对世界说的话和你在边缘执行的内容保持同步。
对于 Search 和 Agent,我们在 7 月 1 日宣布的三个选项保持不变:Allow、在投放广告的页面上 Block,或在所有地方 Block。对于 Training,我们正在优化选项,以阻止你的内容被用于训练模型,使用 Disallow 选项:
Disallow:向你的 robots.txt 写入"no training"偏好,这样合作的混合用途爬虫——那些采取了额外透明度步骤的爬虫——仍然可以访问你的内容进行搜索索引,因为他们允许网站所有者直接验证他们的数据是如何被使用的。合作的爬虫会遵守 robots.txt 中的偏好,对于合作爬虫来说,你的搜索可见性不会受到影响。
让我们以下面的例子为例,其中有人配置了他们的 AI bot 策略,设置为"Allow Search、Allow Agents、Disallow Training"。
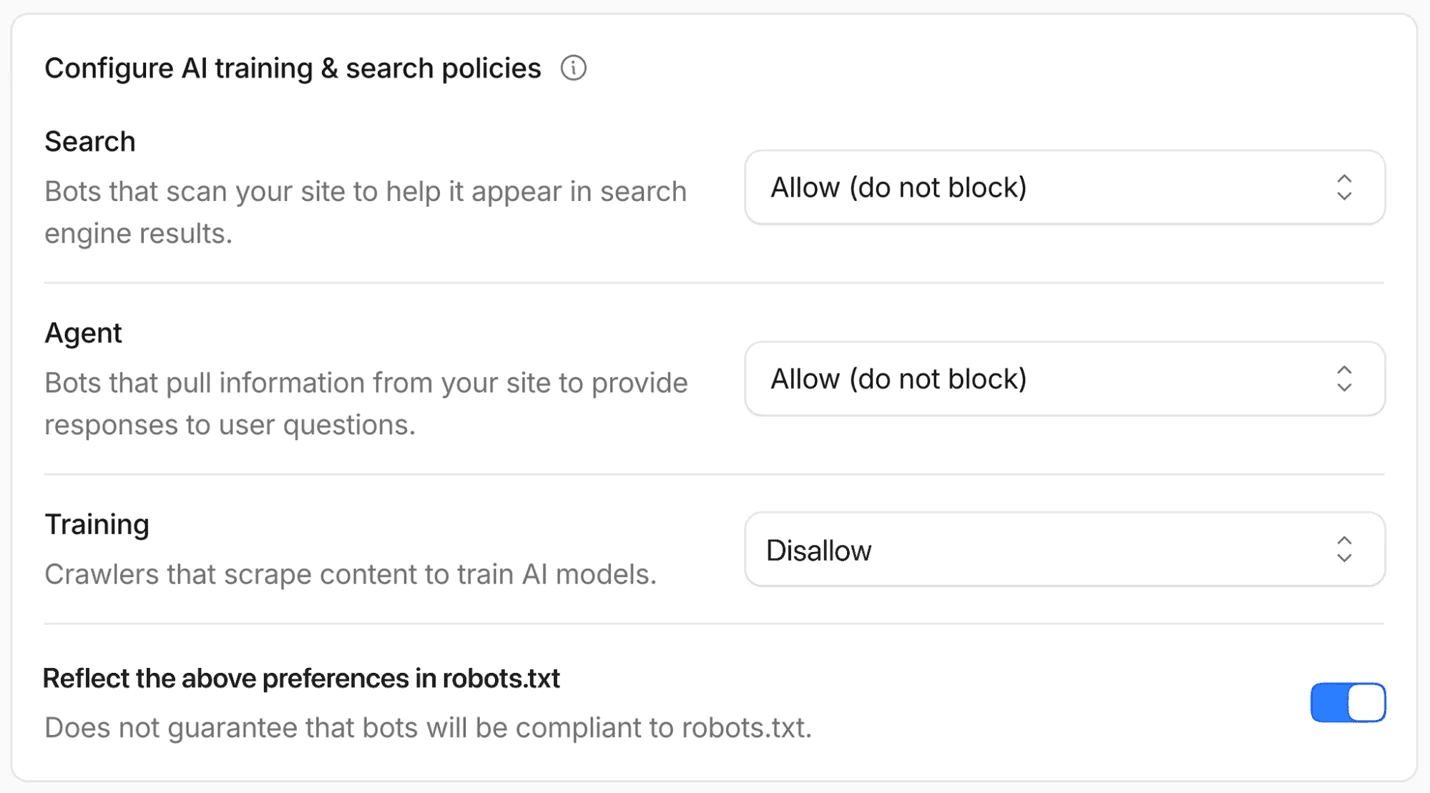
由于这个示例网站开启了 Bot Preference Sync,他们的 robots.txt 会前置类似以下内容(为示例目的已缩短和匿名化):
# BEGIN Cloudflare Bot Preference Sync

User-agent: TrainingBot1
User-agent: TrainingBot2
User-agent: TrainingBot3
User-agent: MixedUseBot-Extended
Disallow: /

...

# END Cloudflare Bot Preference Sync
我们将使用在 BotBase 中追踪的爬虫来定期更新当你选择 Block 或 Disallow 某个类别时添加到 robots.txt 的爬虫列表。在我们公开的爬虫目录中,可以随时查看被归类为 Search、Agent 和 Training 的已验证爬虫。
对于所有新客户,Bot Preference Sync 将默认开启,以便更容易管理反映相同策略的屏蔽和偏好。对于使用旧版托管 robots.txt 功能的现有客户,我们会在新功能上线时提示你审查并确认你的偏好,以过渡到新的 Bot Preference Sync。
有些客户可能希望或需要更主动地表达他们的偏好,例如,如果他们与某家公司有特殊安排,想要授予例外。由于 Bot Preference Sync 旨在处理按类别而非逐个案例做出的策略决策,它不会直接从具有更复杂逻辑的单个自定义规则中读取。具有更精细安全策略的客户始终可以选择关闭设置组策略的同步,并定制他们的文件以匹配其自定义策略。
我们还在做一个改变,允许发布商或广告支持的网站与其他网站所有者有不同的默认值。我们为依赖广告并预期广告为人类访问者保留的发布网站创建了一个默认值。在注册时,此类客户可以选择选项"我从此域名上的广告页面获取收入",这将把 Training 设置为默认 Disallow。(客户可以随时选择更改此设置。)这样,你既保留在搜索中,又将你的内容排除在模型训练之外。
对于非发布商的情况,新客户在注册域名时不会默认添加任何屏蔽或 disallow:选择权在客户手中。你可以选择在任何时候 Block Search 或 Agent 或 Training,但起点不会代表你添加任何屏蔽。
Bot Preference Sync 将在未来一周内向所有客户开放,在所有计划中都可用。请关注我们的变更日志以了解可用性,并关注你的仪表板(和收件箱)中的提示,以确认你的偏好!
这是更长努力的其中一步。我们将继续与大型爬虫运营商合作,确保我们不会在熟悉的挑战(如未经同意的训练)以及新兴问题(如可发现性和参与度)上妥协。这一切的背后是我们推动为网站所有者提供更大透明度和控制权的努力。