仅用 CPU 跑四款模型,推理体验如何
作者在 8 核 16 线程 AMD EPYC、32 GB 内存的服务器上,通过 Ollama 比较 Gemma、Qwen、Spark 与 MiniCPM。测试关注生成速度及俄语回答的主观质量,未重点衡量提示词处理耗时。
AI 深度解读
没有独立显卡,服务器还能跑本地大模型吗?作者用一台 8 核 AMD EPYC、32 GB 内存的服务器测试了四款模型,结果从 6.71 到 52.63 tok/s 不等。CPU 推理确实能用,但速度快、回答好、整段回复等待短,是三件不同的事。
这组测试的价值,在于展示了普通服务器可以承担哪些本地 AI 任务。它的局限也很明显:质量评价围绕俄语展开,输入和输出长度不一致,部分输入还命中了缓存。国内开发者可以借它缩小试用范围,但不能直接照搬排名。
CPU 能跑多快,先把计时口径看清楚
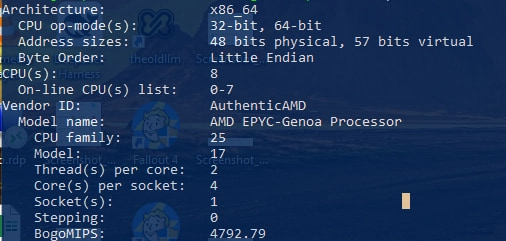
作者的机器使用 AMD EPYC-Genoa Processor,8 核,通过 SMT 提供 16 线程,配备 32 GB RAM,系统为 Ubuntu 24.04。运行时选择 Ollama,方便切换模型和使用量化版本。
四款模型的规模与量化配置并不统一:Qwen3.5:9b 有 9B 参数;SparkLLM/Spark-X2.6-1.7B:q8_0 有 1.7B 参数,采用 8 位量化;Gemma3:4b-it-q4_K_M 有 4B 参数,采用 4 位量化;MiniCPM-V 4.7 1B 则是 1B 参数的多模态模型。
量化可以理解为用更低精度保存模型权重,以减少资源占用。不过,这次同时改变了模型、参数量和量化配置,无法单独判断哪个因素贡献最大。
| 模型 | 生成速度 | 输入 token | 输出 token | 总耗时 |
|---|---|---|---|---|
| Qwen3.5:9b | 6.71 tok/s | 19 | 467 | 70.46 s |
| Spark-X2.6-1.7B:q8_0 | 16.72 tok/s | 88 | 4,008 | 240.47 s |
| Gemma3:4b-it-q4_K_M | 13.29 tok/s | 27 | 296 | 22.73 s |
| MiniCPM-V 4.7 1B | 52.63 tok/s | 806 | 277 | 5.94 s |
作者主要关注生成速度,也就是开始输出后,每秒产生多少 token。提示词处理是另一个阶段:模型需要先读完输入,才能接着生成。
生成速度决定文字冒出来有多快,总耗时还取决于输入处理和回答长度。
Spark 就是典型例子。它的生成速度高于 Gemma,但输出了 4,008 个 token,整段回复用了约 4 分钟。若产品只需要一个简短结论,这种长回答依然会拖慢体验。
MiniCPM 的生成速度约为 Qwen 的 7.8 倍、Gemma 的 4 倍。不过,它的 806 个输入 token 中有 577 个已经缓存,因此作者提到的 345 tok/s 提示词处理速度,不能与从头处理输入的模型直接比较。52.63 tok/s 的生成速度是另一项指标,不能因缓存问题一起否定,也不能拿来代表完整请求速度。
为什么作者最终选了速度居中的 Gemma
作者最终将 Gemma3:4b 作为日常模型,原因是俄语回答质量与速度的组合。
在作者的主观评价中,Gemma 的俄语表达自然,没有明显的机器腔,也没有出现让作者指出的虚构事实。原文还以支持 140+ 种语言作为多语言能力的依据。但支持语言多,不等于每种语言都有相同表现,这里仍然要以实际任务验证。
MiniCPM-V 4.7 1B 则走向另一端:输出很快,俄语质量却最弱。作者认为它偏向图像、视频和英语任务,1B 参数也限制了复杂文本任务的表现。这是作者对结果的解释,文中没有实验去拆分语言训练、模型规模和任务类型各自的影响。
Qwen3.5:9b 被作者保留为复杂分析的备选,但措辞是「可能更适合复杂推理」。原文没有提供推理题结果,不能据此认定它的推理能力已经胜出。
Spark 有速度记录,却缺少对应的语言质量分析,因此也无法判断它在完整选型中的位置。
这组结果真正支持的是:作者在自己的俄语使用场景里,更喜欢 Gemma 的平衡。它尚不足以推出中文问答、代码生成或前端开发任务的最佳模型。
我的判断
我认同作者先用现有 CPU 验证需求的思路。对于内部聊天、短文本摘要和数据留在本机的助手,先确认现有机器能否满足体验,比直接把独立显卡当作前置条件更务实。
但「CPU 能完成推理」与「CPU 能承接团队业务」之间,还缺不少证据。原文没有给出完整提示词、重复测试次数、并发量、模型实际内存占用,也没有完整列出各模型的量化配置。质量评价没有标准答案或对照评分,因此属于经验之谈。
作者实际遇到了长时间生成导致 CPU 升温降频,以及多模型同时运行时内存不足、触发磁盘交换的问题;输入上下文越长,处理也越慢。这些因素会影响持续使用时的稳定性。
相比只选一个模型包办所有请求,作者按日常聊天、快速响应、复杂分析分配模型,有一定参考价值。但多个模型同时驻留又会增加内存压力。相比 GPU 或云端 API,这篇也没有成本、吞吐量和质量对照,不能据此判断哪条路线更划算。
能拿来做什么
- 如果你在做内部问答或摘要工具,可以先用 Ollama 在现有服务器试跑,使用真实中文材料记录输入处理时间、首次输出等待、生成速度和完整耗时,再决定是否需要增加硬件。
- 如果你准备给前端聊天界面接入本地模型,应同时检查流式输出体验和回答长度。Spark 的结果说明,每秒输出更快,也可能因为回答过长让用户等得更久。
- 如果你要通过 Node 服务封装本地推理,可以先验证单模型、单请求的资源占用,再增加并发和模型数量,并观察长时间运行后的降频与磁盘交换。
- 如果目标涉及图片处理,可以把 MiniCPM-V 4.7 1B 列入候选,但应单独测试图像任务。原文的文本生成速度表,没有证明它处理图片时同样快。