为 Mobilerun 手机自动化选择低成本模型
手机代理每执行一步都要调用模型,大规模测试会放大调用成本。文章给出 Ollama 加通义千问的本地配置,以及 DeepSeek 和 OpenRouter 的托管配置,并介绍如何用自己的任务评测。
AI 深度解读
用 Mobilerun 操作 Android,打开深色模式这样的简单任务也可能调用模型 10 次,一整套测试则可能调用数千次。作者给了两条压低推理开支的路线:用 Ollama 在本机跑 Qwen,省去模型 API 的逐次费用,或接入 DeepSeek、OpenRouter,把推理交给托管服务。
原文没有按供应商划分的跑分,也没有给出每项任务的实际成本。对维护移动端回归测试的人,更有用的是弄清三个变量:模型能看到什么、动作指令能否被框架解析,以及完成同一个任务实际要花多少时间和钱。
手机由谁控制,模型又在哪里跑?
开源 Mobilerun 框架运行在自己的机器上,通过 ADB 和 Portal 控制开启了 USB 调试的 Android 设备。模型负责读界面、选动作,框架负责把动作落到手机上。设备接通以后,换推理服务可以只改 CLI 参数或配置,手机这边无需重新接入。
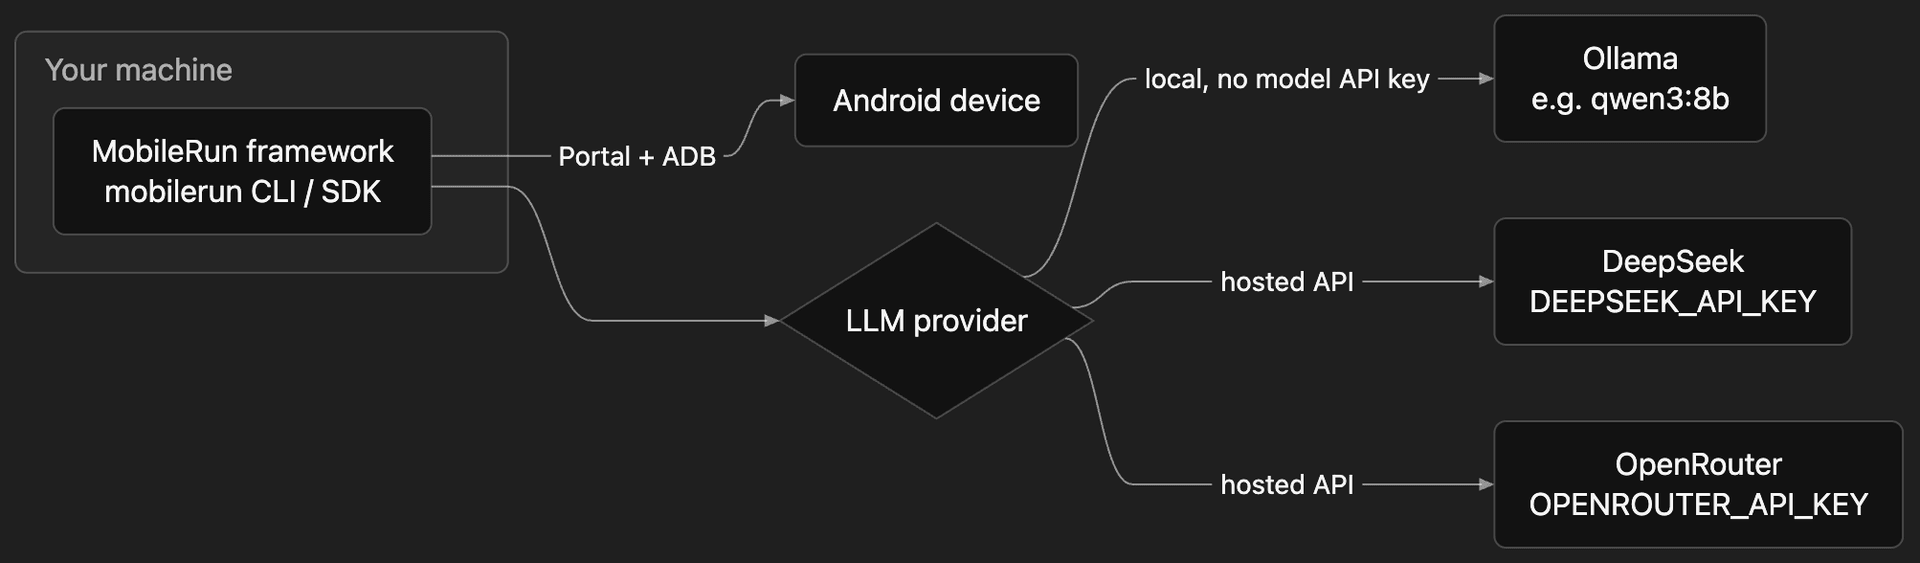
本地方案要求 Python 3.11 至 3.13。原文提醒,Python 3.14 尚未受支持,安装时可能悄悄回退到旧版 Mobilerun。原文没有给出框架安装命令。装好框架和 Ollama、接上手机后,先执行 mobilerun setup 配置 Portal,再执行 mobilerun ping。看到 Portal is installed and accessible. You're good to go!,就可以开始跑任务。
原文下面这段用于拉取模型,并让手机打开深色模式。
ollama pull qwen3:8bmobilerun run "Turn on dark mode" --provider Ollama --model qwen3:8b --base_url http://localhost:11434Copy
这行保留了原文粘连的排版。实际执行时,先运行 ollama pull qwen3:8b,再从 mobilerun run 开始执行后半段,去掉末尾的 Copy。--provider 和 --model 得一起传,漏掉任意一个,Agent 启动前就会报错。--base_url 指向 http://localhost:11434 时,推理请求留在本机,无需模型 API Key。
Qwen 是模型家族。除了经 Ollama 本地运行,也可以通过 OpenRouter 调用托管版。原文的托管示例用 DEEPSEEK_API_KEY 配 --provider DeepSeek --model deepseek-flash,用 OPENROUTER_API_KEY 配 --provider OpenRouter --model qwen/qwen3.8-flash。这些是原文的模型 ID,作者提醒实际使用前查服务商列表。原文所述的 mobilerun configure 向导列出 gemini、openai、anthropic、xai、ollama、openai_like、minimax 和 zai。DeepSeek 和 OpenRouter 要用 CLI 参数,或保存在 YAML 的 llm_profiles 下,原文示例名为 fast_agent。
默认配置目录沿用 droidrun。Linux 是 ~/.config/droidrun/config.yaml,macOS 是 ~/Library/Application Support/droidrun/config.yaml,Windows 是 %LOCALAPPDATA%\droidrun\droidrun\config.yaml。也可以通过 MOBILERUN_CONFIG 或 --config 指定文件。
为什么换了模型,任务反而跑不完?
默认模式读取 Android 无障碍树,也就是系统提供的一份界面元素清单,里面有文本和位置范围。控件信息足够时,qwen3:8b 这类纯文本模型就能选动作。如果任务需要看图,再开 --vision,每一步会同时收到截图和无障碍树,模型也必须支持图片。--vision-only 则只看截图。原文还提到,有些本地视觉模型会缩小图片,框架如果识别不到缩放,点击位置就可能偏掉。文档给出的做法是在 agent 下将 model_screenshot_max_side 设为 1280。
模型选对动作之后,还得用框架读得懂的格式发出来。按原文所述,Mobilerun v0.7.4 对 DeepSeek、OpenAI 和 xAI 等提供商使用原生工具调用,Ollama 和 OpenRouter 走文本回退协议,由模型输出 XML,框架再解析。连续三次输出有问题,运行就会停止。作者观察到小模型更容易写坏格式,界面一复杂更容易出问题,但没有给出不同模型的失败率。
本地速度还取决于 GPU、内存和模型大小。Mobilerun 给 Ollama 设置的 context_window 默认是 32,768。改成 -1 会请求模型的完整上下文,并预分配整块 KV cache,也就是存放上下文计算结果的缓存。显存吃紧时,部分计算可能落到 CPU。调大上下文前,先看卡住的那一步到底缺信息,还是仅仅跑得慢。
怎么比出哪种方案更省?
把同一组任务放在同一台设备上跑,记录 mobilerun --version,统一 --steps 上限和视觉模式。默认步数是 15,复杂任务可能要更多。比如测试打开深色模式,可以在每次运行前把手机恢复到浅色,再用同一个判定条件确认是否成功。这样,初始状态和步数限制就不会混进模型比较。
--tracing 可以看每步用了多少 token,--debug 和 --save-trajectory action 可以帮助定位跑偏的步骤。报价最终要落到完成的任务上。托管模型要把失败尝试的调用费用算进去,本地 Ollama 则要考虑 GPU、电费和机器被占用的时间。若团队连手机也不想维护,原文给出的另一条路线是 Mobilerun Cloud,由它通过 API 提供托管设备和 Agent。
我的判断
我认同按任务完成数算账。对前端和全栈团队,一条回归用例如果经常卡在 XML 解析,低单价很快就会被重跑和排查吃掉。原文给了可复现的配置和排查办法,但没有交代对照实验的设备、任务样本、成功率和耗时。小模型更容易跑偏属于经验之谈,文中也没有数据能判定 Ollama、DeepSeek 和 OpenRouter 谁更划算。
如果关键回归已有稳定的元素定位和明确的断言,固定脚本更容易重复执行,也更容易定位失败。Mobilerun 适合先试那些需要读界面、根据当前状态决定下一步的任务。比较时还要留意工具调用路径:直接换提供商,可能同时换了模型和动作协议。出现差异时,先看失败发生在哪一步,再判断该换哪个环节。
能拿来做什么
- 从现有 Android 回归里挑一条无障碍树能覆盖的短流程,用
qwen3:8b和默认模式跑通,事先写清任务成功时手机应处于什么状态。 - 比较本地和托管方案时,固定设备、起始状态、视觉模式和步数上限,把成功次数、耗时和失败重跑的开销记在一起。
- 遇到失败先看轨迹。界面元素信息不够时,试支持图片的模型和
--vision。连续出现 XML 格式错误时,优先检查模型走的是哪条工具调用路径。