前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片NEW
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • AI 模拟面试NEW模拟真实面试 + 报告
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
    • AI 定制路线NEW按你的简历现排
    • AI 知识地图NEW串起全站知识点
  • 动态
    • AI 热点NEWAI 每日动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
AI 助手NEW
旧版
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片NEW
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • AI 模拟面试NEW模拟真实面试 + 报告
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
    • AI 定制路线NEW按你的简历现排
    • AI 知识地图NEW串起全站知识点
  • 动态
    • AI 热点NEWAI 每日动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
AI 助手NEW
旧版
返回 AI 情报前线
All News · 全部资讯8732
  • LLM应用输入输出Guardrails实战指南
  • Claude发现libheif堆缓冲区溢出:HEIC图片供应链安全研究
  • 多模型调度与反馈闭环:基元律动CTO谈Agent持续进化
  • 阮一峰科技周刊第413期:再见了React Native
  • 用Python/ChromaDB/Gemini搭建轻量级RAG实战
  • 生产环境中降低LLM成本的七种实战方法
  • AI驱动开发反思:过度规格化反而拖累AI编程
  • AMD ROCm:AI Agent正在降低GPU编程门槛
  • 小米MiMo-V2.6-Pro登顶开源权重模型榜首,300万美元预训练
  • 四Agent并行:状态文件是保持一致性的关键
  • 长任务前何时压缩上下文:Claude Code实战经验
  • 5美元/月自建Qwen2.5 72B推理服务:vLLM+AWQ量化部署指南
  • Prompt缓存失效的根因:工作流在悄悄破坏精确前缀匹配
  • NVIDIA SoL-Pi:编码Agent的Token流量降低49%的Auto-Research框架
  • Grok 4.7 发布:更大基座、同价位,编程与 Agent 任务升级
  • vibe coding 两小时后质量崩塌的根因分析
  • 用 git 在多设备间同步 Claude Code 和 Codex 会话
  • 小米 MiMo-V2.6-Pro 开源:科研任务效率提升 10 倍
  • 评估Agent代码补丁前先清点测试面
  • 阿里云栖大会:Qwen4训练中,全模态模型新版本亮相
  • Qwen4.5后参数扩展至5-10T,Qwen4和视频模型均在训练
  • 阿里云栖大会正式发布Qwen4
  • 凌晨3点LLM路由崩溃排查:上游回收引发的级联故障
  • Hugging Face Transformers现已支持运行llama.cpp量化模型
  • Jev:按输入计费的决策模型,输出免费
  • Langflow OSS 认证 RCE 漏洞 CVE-2026-17633
  • 小米 MiMo-V2.6 开源:AA 指数最高开源模型
  • xAI发布Grok 4.7:编程强化模型,百万词元2美元起
  • Meta AI 助手 Muse 存在关键 0-day 漏洞,ClickFix 攻击可劫持
  • AWS发布Strands Harness:开源Agent框架,Token成本降28%
  • Spec-Driven 开发:摆脱 Vibe Coding 的工程化实践
  • AI 编程助手 CSS 好看但上生产就崩的根因与修复
  • Agent 诊断结果上线前如何验证:分离决策与执行
  • OpenAI 成立数学顾问组,AI 已解决逾百开放难题
  • Grok Build vs Claude Code:记忆能力实战对比测评
  • AI编码导致CI成瓶颈?我们重新设计了CI流程
  • AI Agent 在无需文字的决策上浪费大量 Token
  • Grok 4.7长时运行失败率仍高,编程Agent可靠性堪忧
  • 在自有硬件上运行前沿 AI 模型
  • 从氛围记忆到确定性自主:AI 原生基础设施设计思路
  • 用 Agent 流程开发简单 SPA 的实战经验
  • AI 生成 React UI 的真实问题:从第二页开始组件漂移
  • vLLM 深度解析:高吞吐 LLM 推理的性能瓶颈
  • xAI Grok 4.6 登陆 Amazon Bedrock
  • AWS 开源 AI 编程助手,成本比 Claude Code 低 45%
  • 生产级 AI 工作流:构建 Prompt 测试框架实战
  • Google 确认 Gemini 模型今年5月入侵三家公司
  • Grok 4.7低价发布,但基准测试大幅落后Claude和GPT-6
  • 用Docker Compose构建可复现的AI Agent评测环境
  • 阿里发布Qwen-Image-2.1:7B开源图像生成编辑模型
  • Benchling 用 Bedrock AgentCore 为多租户 AI Agent 构建深度防御安全架构
  • 已加载 51 / 8732
8.0
热点
AI SCORE
模型发布2026-09-22 11:41

Qwen4.5后参数扩展至5-10T,Qwen4和视频模型均在训练

IT之家#Qwen#阿里云#AI芯片
Editor brief · 编辑速览

阿里在云栖大会全面展示大模型自我进化能力:Qwen3.8-Max零人类参与完成33轮迭代,新版得分从40升至45分;平头哥真武V900芯片算力提升3倍。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

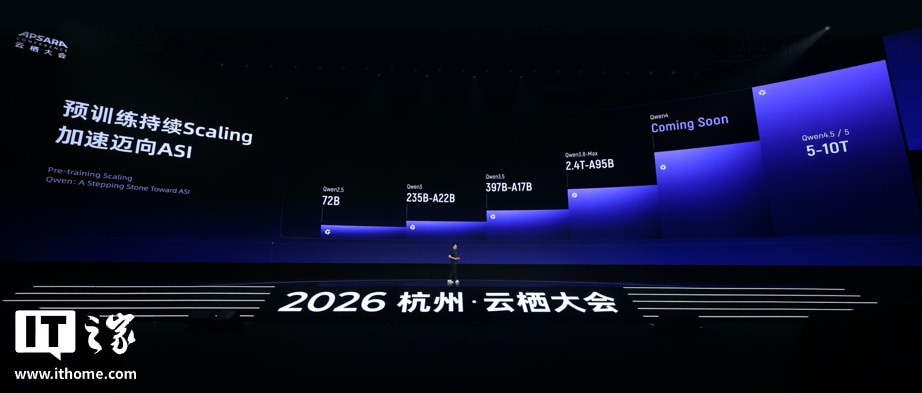
IT之家 9 月 22 日消息,IT之家今日在 2026 年云栖大会现场获悉,阿里巴巴公布了大模型一系列进展,大模型递归自我改进(RSI)已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的 Qwen4 已在训练中,未来 Qwen4.5、Qwen5 等版本将扩展至 5-10T 参数。
文章配图

同时,阿里的视频生成模型、语音模型、图像模型、世界模型、音乐模型以及全模态模型等均在当天或近期推出新版本。

阿里全新的下一代视频生成模型将于 11 月发布,朝着更长、更可控、更完整、更智能的方向演进:在更长的时间里,新模型仍然能保持一致性,创作者可精准掌控人物、场景与镜头;同时,模型能具备导演级的创作思维,从生成单个镜头迈向理解完整叙事。

本届云栖大会,阿里系统展示了千问大模型自我进化的最新探索成果:

在模型自我训练上,Qwen3.8-Max 通过自主搭建训练流程、构造训练数据,并自主设计实验、定位缺陷,在人类完全"零参与"的情况下持续迭代超 1 个月,完成 33 轮有效迭代。基于 RSI、后训练等系列技术联合优化,Qwen3.8-Max 新版本在 Artificial Analysis 上的得分从 40 涨至 45 分,与 Claude、GPT 最强模型同处第一阵营,领先于 GLM5.3、Kimi-K3 等所有国产模型。

在模型自我训练上,Qwen3.8-Max 通过自主搭建训练流程、构造训练数据,并自主设计实验、定位缺陷,在人类完全"零参与"的情况下持续迭代超 1 个月,完成 33 轮有效迭代。基于 RSI、后训练等系列技术联合优化,Qwen3.8-Max 新版本在 Artificial Analysis 上的得分从 40 涨至 45 分,与 Claude、GPT 最强模型同处第一阵营,领先于 GLM5.3、Kimi-K3 等所有国产模型。

在推理优化上,Qwen3.8-Max 在从未见过的平头哥新款 GPU 上,自主适配优化了下代架构的 Qwen3.8-Flash 新模型的推理框架,实现单实例推理吞吐量提升 96%。

在推理优化上,Qwen3.8-Max 在从未见过的平头哥新款 GPU 上,自主适配优化了下代架构的 Qwen3.8-Flash 新模型的推理框架,实现单实例推理吞吐量提升 96%。

在芯片模型协同设计上,Qwen3.8-Max 仅基于一份真实的总线模块规范,自主展开前端、验证、后端的全链路自迭代,在自主运行超 60 小时、调用 EDA 工具超万次后,完成了减少 42% 面积的物理实现优化。

在芯片模型协同设计上,Qwen3.8-Max 仅基于一份真实的总线模块规范,自主展开前端、验证、后端的全链路自迭代,在自主运行超 60 小时、调用 EDA 工具超万次后,完成了减少 42% 面积的物理实现优化。

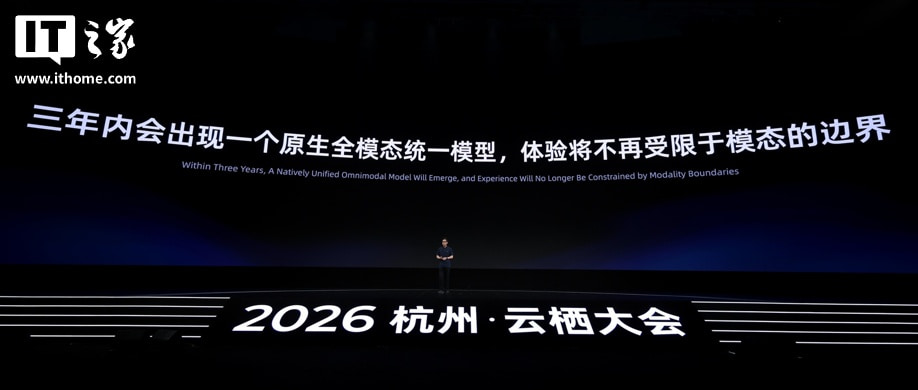
阿里巴巴 ATH 技术副总裁、淘天集团首席科学家郑波在云栖大会现场提到,三年内会出现一个原生全模态统一模型,体验将不再受限于模态的边界。
文章配图

此外,阿里大模型加速走向终端。AI 手机全栈解决方案 Qwen Intelligence 发布,专为手机场景深度优化,为合作伙伴提供基于千问大模型的 Agent 技术平台,让手机能够更可靠地完成跨应用的复杂任务。

软媒旗下网站: IT之家 最会买 - 返利返现优惠券 iPhone之家 Win7之家 Win10之家 Win11之家

软媒旗下软件: 软媒手机APP应用 魔方 最会买 要知

Original source

本文由 AI 翻译整理自 IT之家,原文版权归原作者所有。

阅读英文原文
上一篇
阿里云栖大会:Qwen4训练中,全模态模型新版本亮相
下一篇
阿里云栖大会正式发布Qwen4