Mac本地编程模型测评暴露哪些变量
作者在128GB Mac Studio上运行4位量化Qwen3.8-Flash-Next,最佳编程基准得分略高于OpenRouter托管版,但优势小于本地两次运行的波动。文章同时披露评分器版本、推理强度和工具调用解析问题,结果不足以证明本地部署更强。
AI 深度解读
一台 128 GB 的 Mac Studio,能把开源模型跑到云端托管服务附近吗?作者用自制的 4-bit Qwen3.8-Flash-Next 完成了一次复杂编程任务,最高得分 0.6932,略高于 OpenRouter 上的 0.6846。但作者也明确承认:这点差距不足以证明本地更强。
更有价值的是分数背后的工程过程:大模型怎样塞进内存,长上下文怎样提速,工具调用解析和浏览器截图评分又怎样扭曲结果。它既是一份本地推理记录,也是一堂评测排错课。
本地追平云端,为什么还不能叫领先
Gauntlet sb-7.2 给 Agent 150 次模型调用,要求搭建支付控制台,包括两个 Python 服务、供应商 webhook、实时事件流和支付 3D 视图,再用真实浏览器执行 13 层检查。
作者的两次本地成绩分别是 0.6606、0.6932。最高分在作者 11 月 4 日查看的榜单上排名第 15,共 51 个条目,位于 Grok 4.7 和 Gemini 3.8 Flash 之间。
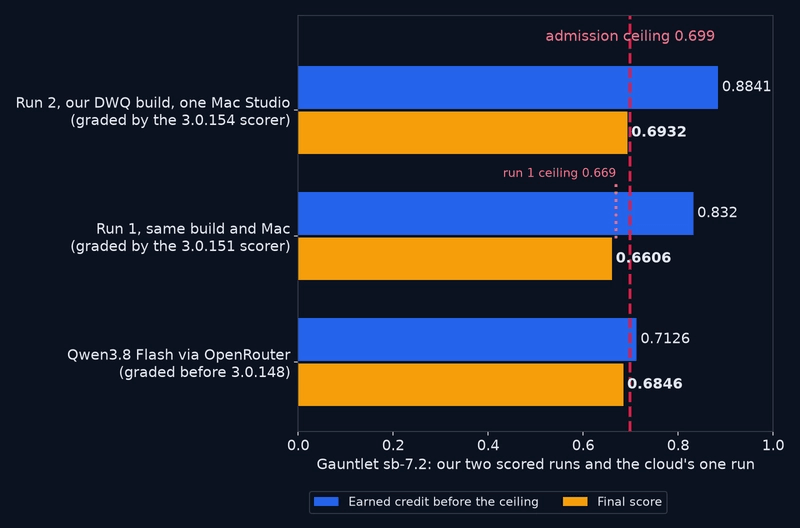
问题在于,这套评分存在硬检查上限。触发封顶后,最终分数按下面的公式计算:
min(raw, cap - 0.05 × (1 - raw))
原始得分的影响被压缩到二十分之一。约 0.17 的原始差距,最后只剩 0.0086;一个 3D 检查的成败,就可能盖过它。同一本地构建两次相差 0.0326,已经接近所谓领先幅度的四倍。
比较条件也不齐。云端成绩来自 10 月 5 日,使用旧评分器,构建文件没有保留,无法重评。本地两次有调用预算即将耗尽时的收尾提示,云端没有;本地第二次用了 138 次调用,但作者没确认提示是否触发。
推理强度同样没有固定。基准要求 medium,应用直到 10 月 16 日才开始向 OpenRouter 上的 Qwen 传这个设置;本地虽然发送了 medium,引擎是否应用也未验证。
这组结果支持本地方案在该任务上达到相近水平,无法证明它超过云端。
100.3 GiB 的模型,怎样装进一台 Mac
Qwen3.8-Flash-Next 的规格是 125B 参数、每次激活 6B,另有 51B n-gram embedding 和 4B MTP。它包含 48 层、512 个专家,每个 token 路由到 10 个专家和 1 个共享专家,还带视觉编码器。BF16 权重装不进这台机器,作者的 4-bit 构建落盘仍有 100.3 GiB。
他们先沿用 oMLX 的 oQ4e 混合精度分配,再加入重要性加权舍入和 DWQ。后者可以理解为:保留压缩后的整数权重,只调整每组 64 个权重对应的缩放与偏移,让输出更接近 BF16 教师。
完整教师和学生无法同时驻留,团队便逐层读取官方权重,只训练路由专家的量化参数。校准用了 384 条、每条 1,024 tokens 的序列,Adam 学习率为 1e-5,训练 3 epochs,耗时 5 小时 22 分钟。最终 35 层采用新参数,13 层保留原结果。
验证过程也有返工。最初宣称的改善幅度 -13.3% 无效,因为测试数据参与了调参,且 21.5% 的位置与训练文本重叠。重建的测试集包含 64 条序列、65,472 个计分 tokens,并检查与训练材料没有 32-token 重叠。
排除收益最大的一条后,KL divergence 仍降低 7.8%,工具文本降低 10.8%。KL 衡量量化模型的下一 token 概率分布离教师多远,越低越接近。但工具文本的困惑度反而变差,作者尚未解释原因,因此不能把这些指标直接等同于编程能力提升。
硬件是 M5 Max、40 核 GPU、128 GB 内存,标称带宽 614GB/s。作者称这是容纳该构建的最低 Mac 内存档位,64 GB 和 96 GB 都不够。应用通过本地 OpenAI-compatible endpoint 接入引擎;原文当时普通 mlx-lm 安装仍不能直接加载,模型支持尚在开放的 pull request 中。
52 万上下文能读进去,不代表等待可以忽略
模型原生支持 262,144 tokens,模型卡称借助 YaRN 可扩展至 1,000,000。团队用 factor 4.0 配置了 524,288-token 窗口。
一次冷启动检索测试读入 522,913 tokens,成功找出隐藏事实,并概括了其中的代码库。但首 token 等了 970.8 秒,随后生成速度为 28.0 tokens/s,Metal 内存峰值 93.0 GiB。正式第二次运行增长到 315,143 tokens,全程没有压缩历史。
这个结果证明了容量,却不能证明任意长文本任务都能稳定完成。作者还承认,模型卡建议约 524,288 的典型上下文使用 factor 2.0,他们没有测过;静态 YaRN 也可能损伤短文本表现。
速度优化集中在三处:
- Split-K decode 让共享 KV 的查询头复用读取。该模型有 24 个 query heads、2 个 KV heads,head dimension 为 256。
- 解开 QSA 的版本限制。旧代码只放行 MLX 0.32.2,机器上的 MLX 0.32.4 因而退回稠密注意力。
- Block-sparse prefill 只计算 QSA 索引器选中的块,减少读入提示词时的工作量。
旧构建在 lz.24 上的 A/B 显示,400k 上下文开启前两项后,生成速度达到关闭时的 2.6 倍;加入 6,000 tokens 时,块稀疏预填充把速度从 86 提到 120 tokens/s。但这不是正式评分使用的 lz.27 加 DWQ 构建,400k 数据也只有单次 256-token 样本,不能照搬为稳定收益。
团队还发现 lz.27 自己引入了内存分配退化:缓存预算过低,导致每个分块重复释放、分配 3 到 17 GB 缓冲区。未发布修复把同构建约 522k 提示词的首 token 时间从 968.6 秒降到 880.7 秒。作者给收益幅度的信心只有中等,原文末尾也在短上下文结果处截断,没有完整后续。
模型失败,可能是解析器和评分器出了错
第一次运行中,模型把 shell 工具声明的 timeout_secs 写成了 timeout:
<parameter=command>
... | head -c 800
</parameter>
<parameter=timeout>
40
这段说明了参数边界为什么重要。要看的是 <parameter=timeout>:旧解析器只识别 schema 声明过的名字,竟把未知参数标签和数值并入 shell 命令,导致 Bash 返回 exit code 2。53 次 shell 调用里有 38 次受影响。
lz.28 修复了边界识别,但没有擅自把 timeout 映射成 timeout_secs。回放修复了全部 38 次问题调用,268 次干净调用保持字节一致。不过原始模型文本没保存,回放输入经过重建,作者只给了中等置信度。正式第二次运行用的是 lz.27,42 次 shell 调用均正确,因此修复没有贡献那次成绩。
评分器的问题更直接。第二次原本只有 0.5909:截图检查采样 120 个点,要求至少 114 个颜色正确,实际只有 113 个。直接读 GPU framebuffer,却是 120 个全对。
原因是 canvas 宽 1209.21875 像素,横坐标 x = 35.39。小数布局触发浏览器重采样,正确画面中的部分像素被混色。团队在副本上将 canvas 对齐整数边界,成绩从 0.5908 升至 0.6933,随后修评分器,并对保留的原构建重评。
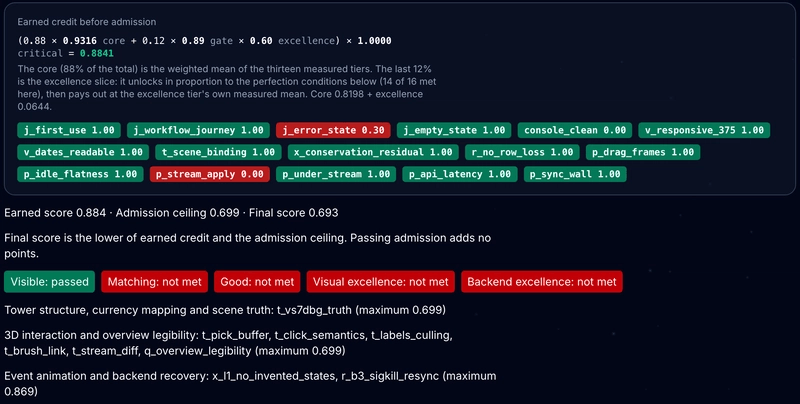
修复随应用 3.0.154 发布,重评为 0.6932;排除两项普通评分波动则为 0.6924。其他四份可重评构建变化最多 0.0003,16 个控制样例全部通过。但云端构建已经丢失,无法接受同样修正,比较仍不对称。
我的判断
我认同作者把模型、量化、推理引擎、工具协议和评分器放在一起检查。Agent 的成绩来自整条链路,任何一环出错,都可能被误记成模型能力不足。
但它首先是特定硬件、特定构建、特定支付控制台任务的工程案例。两次运行不足以支撑模型排名;KL 改善也没有对应的量化前后 Agent 对照成绩。早期构建约 8k 上下文的 48 tokens/s,不能当成 DWQ 构建的短上下文实测。
与直接使用云端相比,本地方案展示了大内存机器上的可行性,同时增加了量化、内核和协议适配工作。原文没有成本、能耗或长期稳定性对照,不能据此判断哪种更划算。LeanZero Agent 也只是准备重新推出的名称,当时尚未以该名称交付。
能拿来做什么
- 给 AI 编程流程做评测时,保留生成项目、运行配置和工具调用原始记录,让后续评分器修复能够覆盖全部比较对象。
- 接入本地 OpenAI-compatible endpoint 时,把未知参数边界、异常工具调用和合法调用不变性纳入验证,避免协议问题污染执行结果。
- 为前端页面编写截图检查时,覆盖小数尺寸 canvas、浏览器重采样和文字抗锯齿,避免把像素差异直接判成渲染错误。
- 评估长上下文模型时,分别记录冷启动首 token 时间、持续生成速度和实际任务完成情况,再决定更大窗口是否值得等待。