Poltergit 用提交证据解释代码来历
开源工具 Poltergit 通过 git log -L 追踪指定代码行的修改历史,可选关联 GitHub PR、评审和议题。工具在本地运行模型,为解释附上引用与原文,并在记录不足时明确说明。
AI 深度解读
代码里最难处理的,往往是那些看着多余、又没人敢删的东西:一次固定等待、一个奇怪的重试次数,或者一条提交说明只有「update」的常量修改。Poltergit 想回答的,就是这些代码为什么还在这里。
作者的办法是让本地模型读取 Git 历史,用代码的口吻解释自身来历,并为回答附上可核对的原话。它最有价值的设计不是拟人化表达,而是设定了退出条件:证据对不上就丢弃回答,历史没写清就承认不知道。对维护老项目的程序员来说,这比一段流畅的猜测更有用。
找到改动,不等于找到改动的原因
git blame 能告诉你谁在什么时候改过某一行,却未必能解释为什么。Poltergit 从命令 poltergit why src/client.py:13 开始,通过 git log -L 追踪这一行经历过的修改,收集 diff 和提交说明;即使行号发生变化,也能继续追踪。用户主动启用后,它还会补充相关 GitHub PR、review 和 issue。
工具只读取已提交的 HEAD,遇到未提交改动会提醒。作者还提到,裁剪模型输入时会保留这行代码最早的历史,但没有展开具体裁剪策略。
演示里的第 13 行是 time.sleep(3)。相关提交说明写道,网关会为已关闭的会话保留两秒,所以重新连接前需要等待三秒,避免重连风暴。模型据此解释等待的用途,界面显示本次使用 1,503 tokens,推理费用为 $0,引用全部匹配。
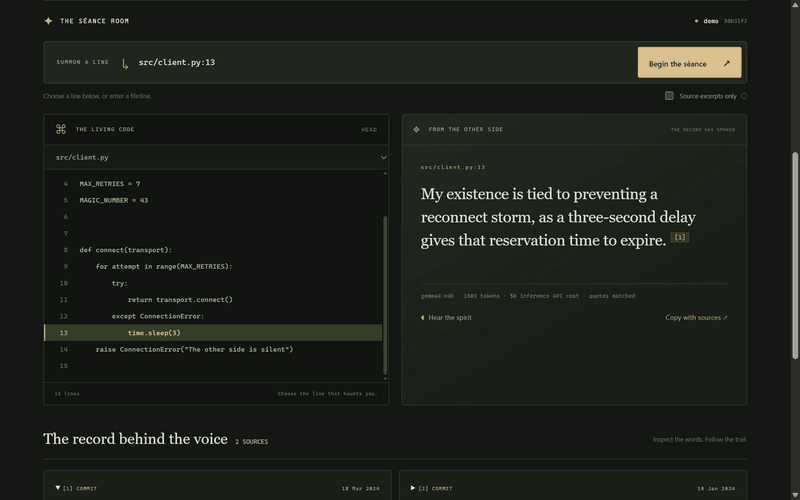
这套演示仓库是虚构的,作者明确标注了这一点。运行 poltergit demo 会生成包含六次真实 Git 提交的演示仓库,让别人能够复现结果。44 秒演示视频剪掉了 CPU 推理的等待过程,也对此作了说明。
不过,只沿着一行向前追溯仍然会漏掉原因。演示中第 9 行的重试循环,只在创建客户端时被直接修改过;真正解释重试次数的记录,却在另一条把 MAX_RETRIES 从 3 调到 7 的提交里。
因此,poltergit index 会用本地 EmbeddingGemma 将仓库历史转换成 768 维向量,存入带 pgvector 的 Postgres,作者使用的是免费 Tiger Cloud 服务。一条 SQL 同时执行两路检索:基于 HNSW cosine 索引的向量相似度搜索,以及 Postgres 全文搜索的关键词排名,再用倒数排名融合(Reciprocal Rank Fusion)合并结果。
可以把它理解为:既找意思接近的历史,也找字面命中的历史,再综合两边的名次。搜索还按仓库、revision 和 embedding model 限定范围,避免混入其他历史记录。
模型可以解释,但必须交出能核对的证据
Poltergit 通过 Ollama 在本地运行 Gemma 4 E4B。模型拿到目标行、周围代码和历史后,必须输出结构化 JSON:要么列出带 source ID 和原文引用的 claims,要么返回 silent: true。
这里有两条写进程序的规则:每段引用至少包含 12 个字符,而且必须逐字存在于对应来源中;回答必须以代码自身的身份发言,不能冒充代码作者。违反任意一条,整个回答都会被丢弃,界面改为展示带标签的来源摘录。
引用校验能证明原话存在,不能证明模型对原话的理解正确。
作者也承认这个边界。提交里确实出现过某句话,不代表它一定能支持模型给出的因果解释。不过,这至少把问题从「凭空编故事」推进到了「解释是否符合证据」,程序员有东西可查了。
作者报告过一次实际拦截:第 5 行 MAGIC_NUMBER = 43 来自一条标题为「update」的提交,记录没有说明原因。Gemma 在现场测试中仍尝试解释,还给出了一段与来源不匹配的引用。校验器丢弃了回答,展示提交文本。
另一次尝试发生在真实的 npm 库 request 上。README 第 3 行写着该库于 2020 年 2 月 11 日完全弃用,对应提交是 doc: note full deprecation (#3267),PR 描述只有「It's time.」。证据不足,工具没有继续解释。
但在 package.json 第 49 行的 uuid 依赖上,它找到了一条 2016 年的提交,说明使用 defunctzombie 的 uuid fork,是因为 node-uuid 已被开发者放弃。这里历史写下了原因,模型才有材料作答。
本地推理省了调用费,也把等待留给了电脑
作者给出的一条 Sentry trace 很直观:整次调用约 2.90 分钟,其中 git.history 为 677 ms,evidence.validate 为 0.12 ms,gen_ai.chat 占了 2.89 分钟;模型输入 728 tokens,输出 834 tokens。
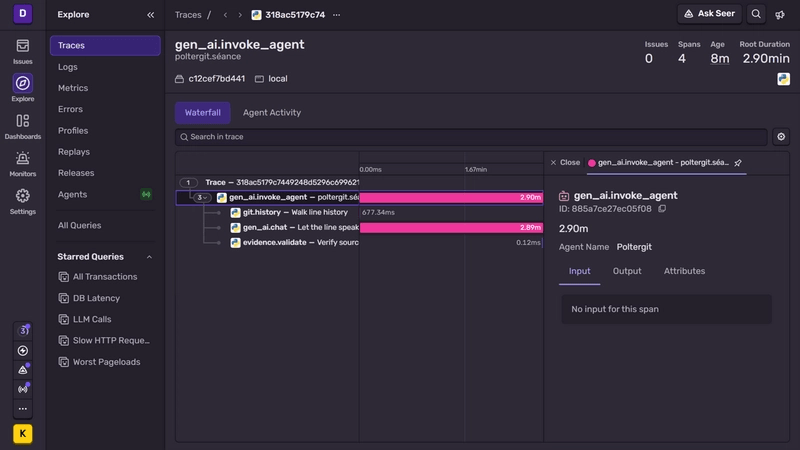
他的纯 CPU 笔记本每秒生成约 6 到 11 tokens。首次冷启动在 181 秒时报错,看着像模型坏了,实际是撞上了 180 秒超时。作者据此把超时改为可配置,并在安装说明中提示 CPU 用户调高限制。
每次调用对应一个 gen_ai.invoke_agent transaction,agent name 为 Poltergit。追踪还帮助作者发现 AI 子 span 被 SDK 默认单独流式发送,以及 CLI 退出太快导致数据来不及上报的问题,后者通过退出前显式调用 flush() 修复。
作者称,Sentry 不接收 prompt 和源码,send_default_pii 关闭,只记录耗时、模型和 token 数量。这里仍要区分计算与存储:Gemma、EmbeddingGemma 和语音模型都在本地运行,但选用 Tiger Cloud 后,历史的向量表示会离开电脑,追踪数据也会发往 Sentry。
项目还有一层偏展示性的包装:82M 参数的 Kokoro 经 ONNX 运行,放慢语速并添加轻微回声,朗读代码的回答。FastAPI、Typer 和 Jinja2 分别支撑本地网页、CLI 与静态导出,服务只监听 localhost,并使用 anti-CSRF token。
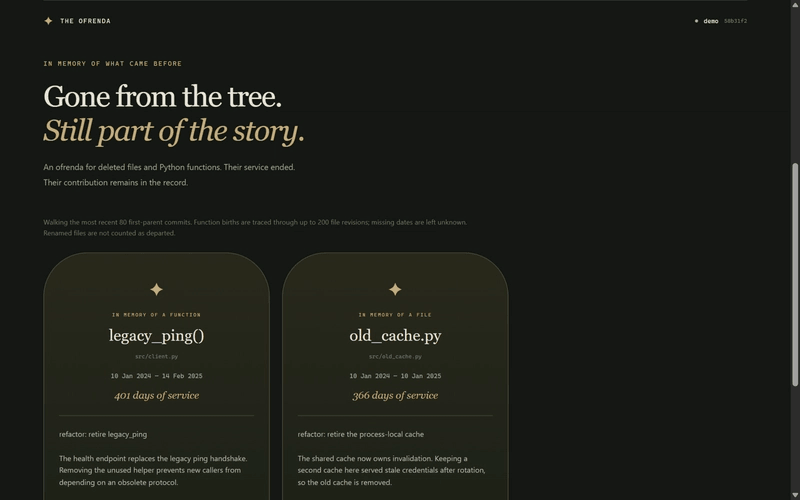
poltergit ofrenda 则为删除的文件和 Python 函数生成纪念页。函数出生时间通过比较一个文件最多 200 个 revision 的 Python 语法树确定。示例里,legacy_ping() 存续了 401 天,old_cache.py 存续了 366 天。
我的判断
我更认同这套证据处理流程,而不是代码开口说话的形式。把结构化输出、逐字校验、失败回退和明确沉默串起来,是一个可以迁移到日常 AI 编程工具里的设计。
但原文没有给出大规模仓库上的准确率、误判率,也没有提供混合检索与单独使用 git log -L 的对照数据。六次提交的演示仓库、一次错误引用拦截,以及 request 上的案例,能说明方案如何工作,还不足以证明它在一般团队里稳定可靠。
它也很依赖团队留下的记录。提交说明长期只有「update」,讨论散落在未接入的地方,模型就无法恢复当年没有写下来的动机。至少 12 个字符的真实引用,也可能被错误地套在另一段解释上。
至于每次推理 $0,准确理解是没有云模型按次调用费。CPU 等待、设备资源,以及数据库服务的长期安排,仍然需要考虑。MIT 许可、Ubuntu 和 Windows CI,以及连接真实 Postgres 的 pgvector 集成测试,提供了可检查的工程基础,但没有替代效果评估。
能拿来做什么
- 接手前端或 Node 老项目时,可以先拿固定延迟、重试次数、特殊依赖这些难以解释的代码试用,沿引用回到提交和 PR 核查,再决定是否修改。
- 给团队的 AI 编程助手增加历史解释能力时,可以借鉴
silent: true和引用失败回退机制,让证据不足成为一种正常输出。 - 遇到原因藏在其他文件或配置中的问题,可以考虑结合关键词与向量检索,同时按仓库和 revision 隔离结果,并在真实任务中比较它是否比直接查 Git 更有效。
- 在纯 CPU 环境部署本地模型时,可以先记录模型耗时、token 数量和退出前的数据上报情况,再设定超时;不要仅凭一次超时报错判断模型不可用。