Perplexity新API支持定时搜索与变更推送
Perplexity推出Monitor API,按计划执行网页搜索,并通过Webhook向Agent推送相关变化。服务使用自身的判断模型过滤不重要的结果,将一次性查询扩展为持续监测。
AI 深度解读
Perplexity 的 Monitor API 想把「定期搜一下网页」变成持续运行的监控服务:开发者写清关注什么、多久检查一次,服务发现符合条件的新信息后,再通过 webhook 通知应用或 AI Agent。
它的价值不只在定时搜索,还在于把去重、变化检测和结果筛选一起接走。对维护竞品价格、产品更新或行业动态监控的程序员来说,这能省下一批胶水代码。不过,省多少维护成本、筛选是否可靠,还得拆开看。
它接走了哪些定时任务代码
常见的网页监控流程是:定时执行搜索或抓取,保存上次结果,比较差异,再决定是否通知。关注对象变多以后,去重记录、页面快照和通知状态都会成为维护负担。Perplexity 认为,这套自建流程扩展到数百个主题和页面时会很难维护。
Monitor API 把这些步骤封装成一个监控对象。开发者通过 api.perplexity.ai/v1/monitors 设置搜索条件、目标、执行计划和 webhook URL,即可创建监控。
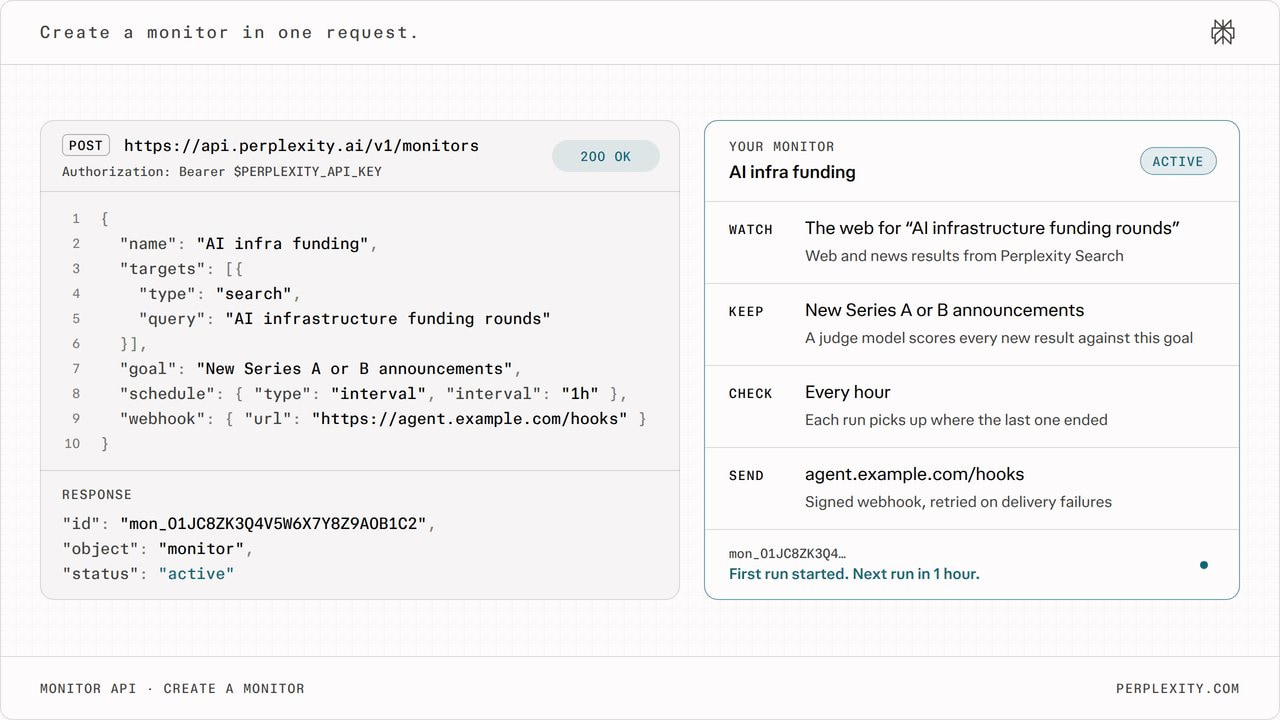
它提供两种模式,适合不同的信息来源:
- Web monitors 定期调用 Perplexity 的网页与新闻搜索,寻找符合条件的新内容,例如 AI 基础设施公司的融资消息。
- Page monitors 最多跟踪 10 个指定页面,适合价格页、更新日志或政策页。首次运行保存基线,之后返回文本差异。
这里有个实际区别:搜索监控负责发现「哪里出现了新消息」,页面监控负责检查「这些固定地址改了什么」。如果只关心某个产品的价格页,直接监控页面通常更贴近需求。
执行频率支持每 15 分钟到每周,也可以配置自定义 cron。各次运行会衔接此前的进度,并过滤重复结果;开发者还能通过 API 或 API console 暂停、恢复和手动触发监控。
因此,标题里的持续看守不应理解为实时监听。它依然按计划检查,更新速度受执行间隔影响。
真正决定通知质量的是筛选目标
发现变化只是第一步。页面换了一句宣传语,与价格套餐发生调整,对业务的意义完全不同。
Monitor API 允许开发者用自然语言定义目标,再由 Perplexity 自有的决策模型判断结果是否值得推送。网页搜索结果需要通过相关性、来源可信度、新颖性和时效性检查;页面变化则根据它是否影响目标来判断。
开发者交出去的不只是定时执行,还有「什么值得通知」的判断。
原文以融资监控为例:预告、传闻和旧消息回顾会被过滤,真正新增的 Series A、Series B 融资公告才进入通知流程。
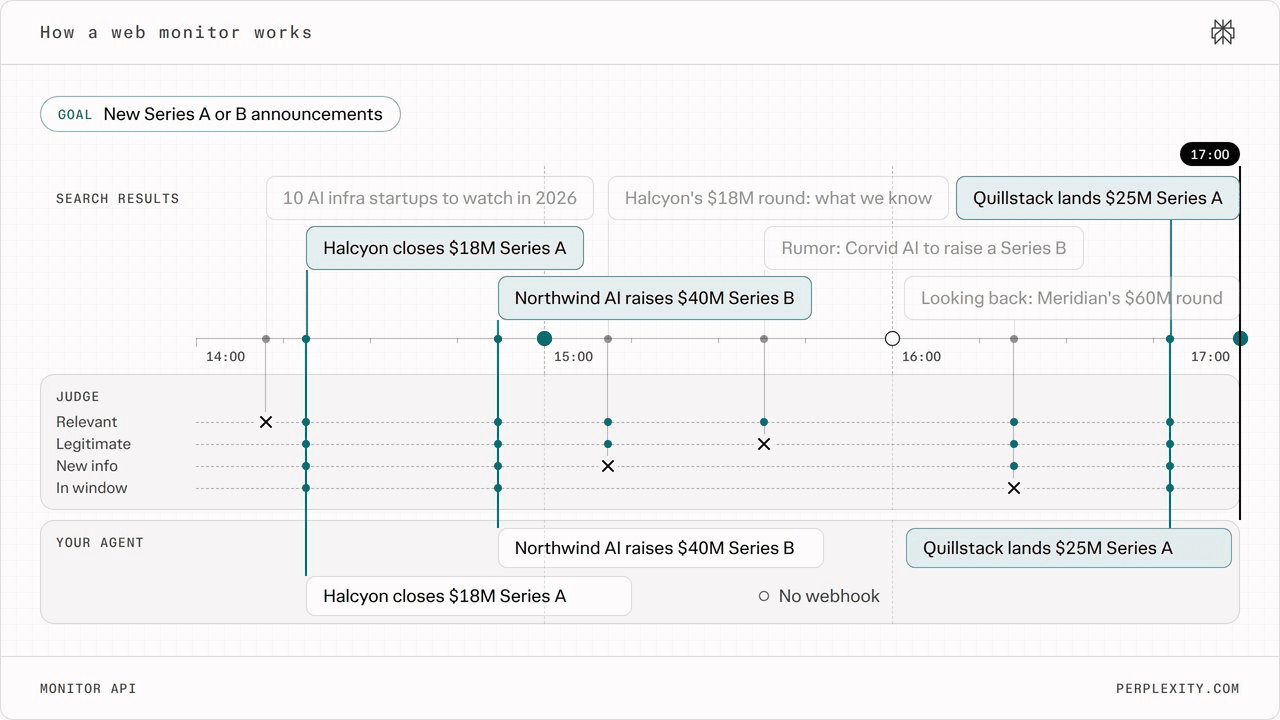
所有检查达到阈值后,服务才发送更新,并附带置信度分数。各项检查的阈值可以单独调整,目标也能直接修改,无须重新创建监控。
这给了开发者调整噪声水平的入口,但原文没有说明分数怎样校准,也没有提供漏报率。置信度可以作为参考,不能直接当成事实正确率。
通知链路也包含一些工程能力:webhook 带签名,临时投递失败会自动重试。对于 Node 接收端,这提供了验证来源的基础;不过原文没有交代重试次数、间隔或重复投递语义,接入时仍需查清这些约定。
63 条对 20 条,能说明它领先吗
Perplexity 用来自真实 Search API 查询的 60 个主题进行了内部测试,覆盖公司新闻、技术发布和监管信息。各家服务使用各自的执行计划与设置,再由一个独立于检索流程的模型评价结果的相关性和新近程度。
前 8 小时的结果是:
| 服务 | 新鲜且相关的页面数 |
|---|---|
| Perplexity | 63 |
| Firecrawl | 20 |
| Exa | 15 |
| Parallel Core | 10 |
| Parallel Lite | 10 |
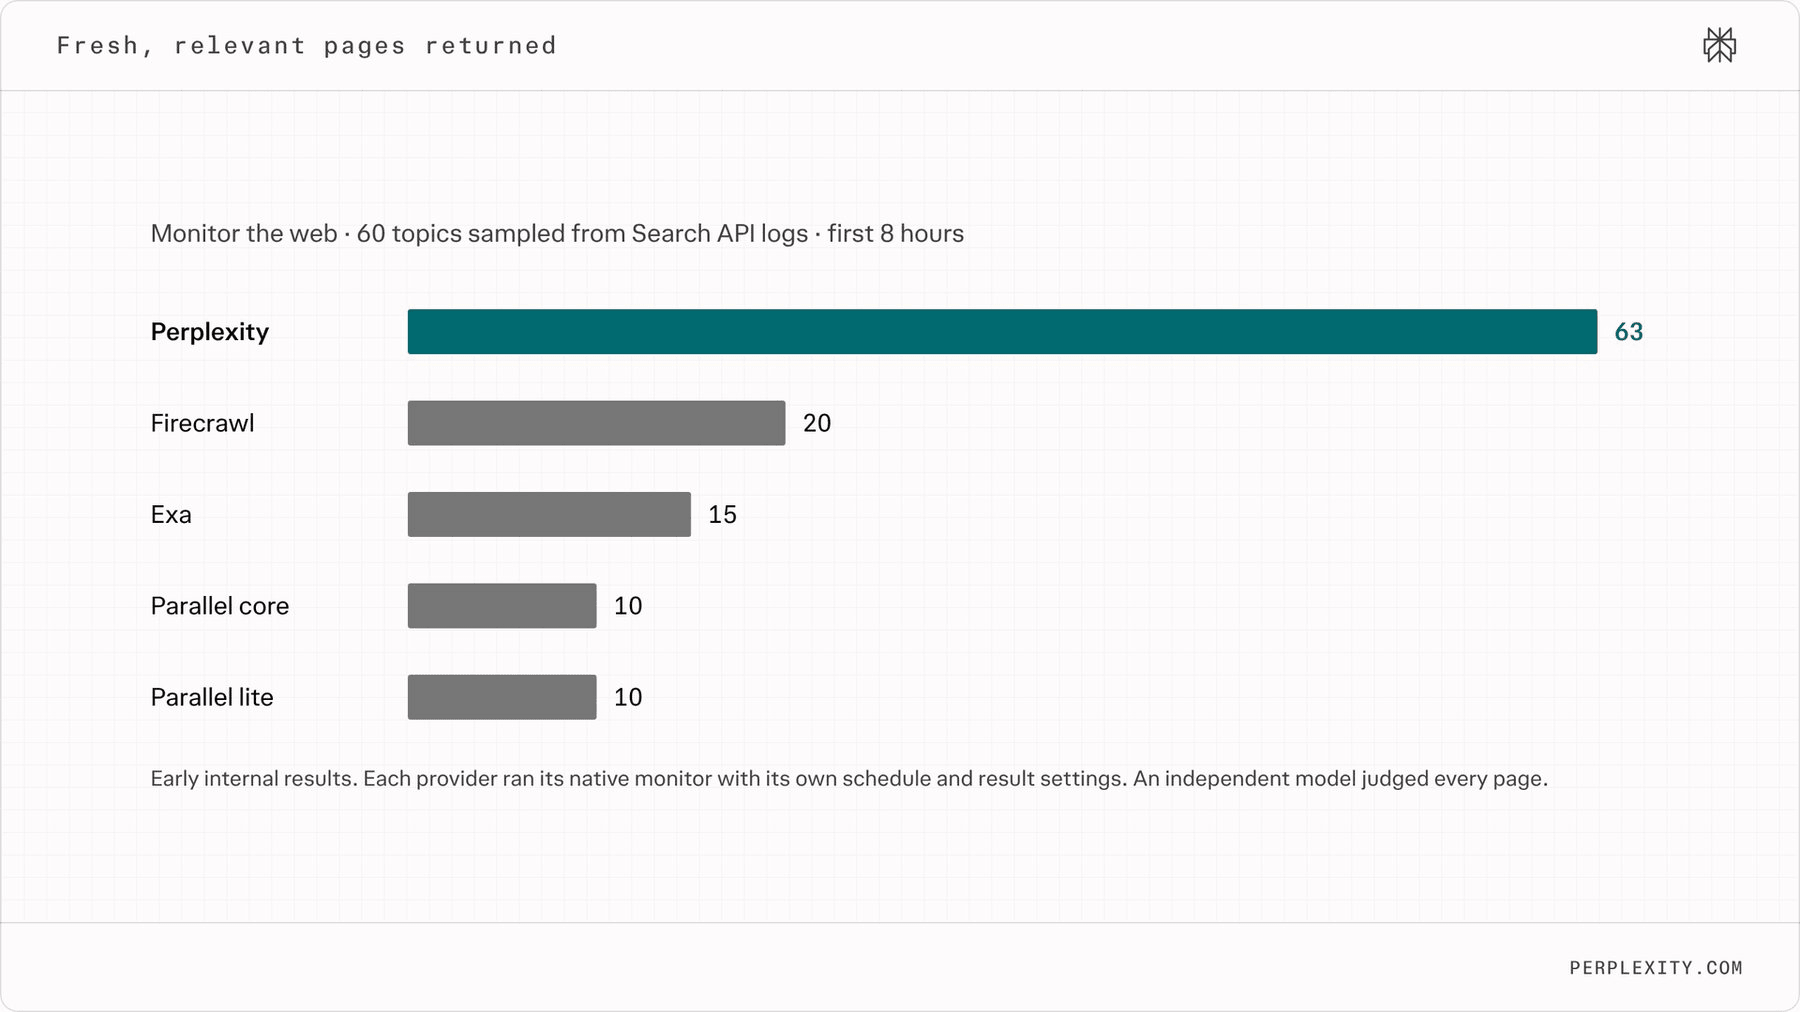
这个结果支持一个有限结论:在他们这次测试的配置和评价方法下,Perplexity 找到了更多符合标准的页面。
它还不能证明通知更准确或整体成本更低。各家执行计划和设置并不一致,原文也没给出总抓取量、误报率、漏报率以及完整成本。「63 条」衡量的是检出的有效页面数量,不能单独代表监控质量。
原文还提到,Firecrawl、Exa 和 Parallel 曾在 8 月的 Artificial Analysis 传统搜索 API 基准中领先,但 Perplexity 没有参与。传统搜索与持续监控的任务不同,两组结果无法直接拼成一张排名。
价格方面,Web monitors 每 1,000 次成功运行收费 1 美元;Page monitors 每抓取 1,000 个 URL 收费 1 美元。两种模式计费单位不同,估算预算时要分别计算运行次数与 URL 抓取量。
服务已通过 API 和 API console 提供,复用 Search、Context、Agent APIs 的密钥。
我的判断
我认可它把搜索结果处理成可触发后续流程的事件。对 AI Agent 来说,先筛选再唤醒,有机会减少无效输入;对开发者来说,少维护一套快照、去重和调度状态,也有直接价值。
但「数百个主题就难以维护」是厂商的判断,原文没有给出团队工时或成本对照。只盯几个固定页面、规则又很明确时,定时任务加文本 diff 仍然容易理解,也方便排查。目标复杂、来源分散时,托管筛选才更有吸引力。
这项服务值得验证的是通知质量和维护成本,内部榜单只能作为试用线索。
此外,文本差异不一定覆盖页面的全部有效变化。动态内容怎样处理、抓取失败如何反馈,原文没说清。若监控承担关键业务职责,这些问题比多找到几条消息更重要。
能拿来做什么
- 如果你维护产品更新或价格变动通知,可以先选少量固定页面测试 Page monitors,检查文本差异能否覆盖真正关心的字段。
- 如果你用 AI Agent 汇总技术动态,可以把目标写得具体,例如只接收正式发布的版本更新,再抽查被推送和被过滤的内容,调整阈值。
- 如果你用 Node 接收 webhook,应依据接口文档完成签名校验和重复事件处理,并确认临时失败后的重试行为。
- 如果你准备替换已有监控脚本,可以让两套流程并行运行,比较有效通知、漏报、费用和维护投入,再决定迁移范围。