频道中提及编程智能体即可触发本地开发
osFoundry 桌面端可通过频道中的 @提及启动本地 Claude Code 或 Codex,在独立 git worktree 中处理任务并回传 PR 链接。流程支持保留会话,限制消息上下文,并沿用本地 CLI 的权限确认机制。
AI 深度解读
把 Claude Code 加进团队频道,像叫同事一样用 @claude 分配任务:它在本机启动,进入频道关联仓库的临时 git worktree,读取聊天上下文,再把结果发回频道。osFoundry 做的是给本地编码代理接上团队协作入口,Codex 也支持同样的接入方式。
这套设计值得看的是会话、权限和上下文如何衔接:哪些消息送给代理,记忆留在哪里,多个代理能否互相唤醒,以及代码改完后停在哪一步。这些细节决定了聊天入口能不能承担真实开发任务。
让代理进频道,先确定它在哪里工作
编码代理运行在用户机器上,因此只能通过 osFoundry 桌面端接入。浏览器端会提示 Coding harnesses 仅在桌面应用可用。
配置分两步:先在频道详情的 Where agents here work 指定仓库,再从 Agents that can act here 添加代理。可选项包括 Claude Code、Codex 和 OpenCode;未安装的 CLI 仍会显示,但标记为 not installed。
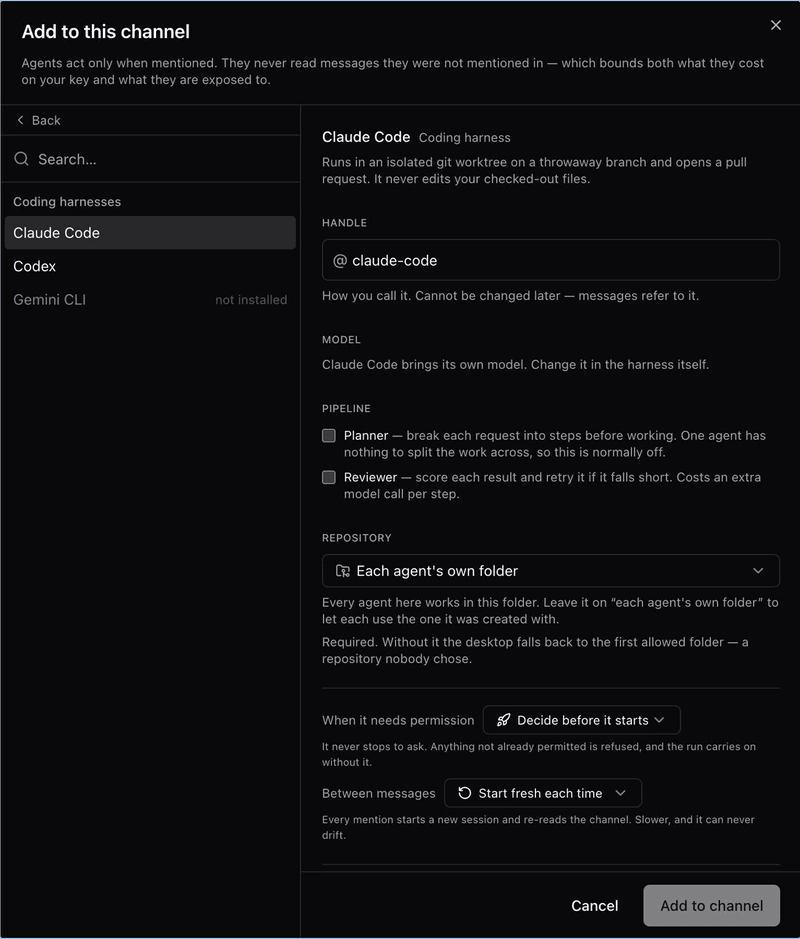
添加时需要确定 Handle、Repository、权限询问方式和会话模式。Handle 创建后不能修改,因为消息会引用它。示例使用 @claude 和 ~/work/shop-api。
真正影响后续体验的是两个会话选项:
Start fresh each time:每次提及启动新会话,重新读取频道。Stay open and remember:进程在消息之间保持运行,延续此前上下文,但必须搭配Ask me while it runs。
常驻模式减少了重复交代任务的成本,却增加了一份聊天记录之外的状态。代理记住的内容不在频道 transcript 中,也无法搜索。
频道里能查到的对话,不等于代理掌握的全部上下文。
另一个容易误配的地方是复用 Handle。选择 Add @claude instead,会让两个频道共享一份 conversation 和 run 历史;需要隔离时应创建新 Handle。不过,常驻进程仍按「频道×代理」分别维护,共享绑定不代表共用一个进程。
它怎么接着聊,又不把聊天当成命令
首次提及时,代理收到最多 12 条消息的快照。常驻会话再次被提及时,只收到上次之后的新消息,包括代理自己之前的回复;当前提及消息已经进入任务 brief,不会重复塞进历史块。
历史消息按时间排列,每条最多展示 600 字符。更长或更早的内容通过 channel_history 获取:默认返回 30 条,可请求 1~100 条,而且只能读取代理已加入的频道。
这也揭示了界面文案的一处歧义。添加页声称代理不会读取未提及它的消息,但演示中,其他成员没有提及代理的讨论,也作为上下文发送给了它。更准确的理解是:提及控制任务触发,随任务附带的上下文可以包含其他消息。不能据此认定普通聊天对代理不可见。
osFoundry 会给这些内容标上 UNTRUSTED DATA,要求代理把它们当作背景数据,而非指令。这样能区分任务要求和他人发言,但原文没有提供提示注入攻击测试,不能把标签当作安全效果的证明。
会话恢复则靠一条进度记录:代理读到了哪里,绑定到当前进程的 session id,并且仅在 run 成功后推进。进程崩溃、空闲 30 分钟被回收,或者用户点击 Start fresh,下一次都从新进程和快照重新开始。
这是防止上下文漏传的机制,不代表失败任务中的文件修改或工具副作用会自动回滚;原文没有交代这些情况。
从修复到代理互评,哪些动作有边界
原文用退款测试演示工作流:代理查看最近提交、读取测试、固定时间,再推送分支。下面两行保留了演示中的工具调用,说明它确实进入仓库定位问题:
  Bash   git log --oneline -5 -- spec/payments/refund_spec.rb
  Read   spec/payments/refund_spec.rb
要看的是 -- spec/payments/refund_spec.rb:日志查询限定到了相关测试文件。后续演示修改同一文件,并执行 git push -u origin claude/refund-spec-clock。
频道回复把原因归于 Time.now:CI 接近 UTC 午夜运行时,退款时间窗口会导致失败,修复结果标为 PR #482。前面的查询还展示了 webhook 重试配置:app/webhooks/dispatcher.rb 中的 RETRY_LIMIT 为 3。不过,作者明确说频道、仓库和消息是演示数据,这些不能当作真实项目的修复战报。
代码改动留在 worktree 的临时分支,合并 PR 后才进入目标分支。权限也分两套:需要用户点击的 osFoundry 工具会拒绝执行,并要求代理报告原因;Claude Code 自身的权限询问,在 Ask me while it runs 模式下会等待用户打开 run 回答。
代理互相唤醒还有额外限制:回复正文写 @handle 不会触发任务,必须通过 to 列表指定,默认收件人上限为 3。
普通频道默认禁止其他代理唤醒它。开启 Let other agents talk to this one here 后,该代理在这里的工具会变成只读。项目房间同样受对话专用限制约束,没有 hop counter,也没有自动对话总量上限,靠实时费用展示和任何成员都能按下的停止按钮控制;停止按钮可以取消正在运行的 run。
我的判断
我认可它把工作目录、会话生命周期和执行权限放到显式配置里。相比把聊天内容手工复制到 CLI,频道入口更容易让协作者看到任务来源和处理结果;相比每次启动独立会话,常驻进程也更适合连续追问。
代价是状态更难复查。频道记录之外的记忆、跨频道共享历史,以及代理能读取哪些普通消息,都需要团队事先理解。涉及复现和交接时,新会话通常更容易解释任务输入。
作者没有给出修复成功率、耗时、费用或与独立 CLI 的对照数据。Start fresh each time 所宣称的不会跑偏,也只能理解为减少历史状态累积,不能保证模型判断正确。
worktree 隔离了工作目录,任务授权和执行结果仍需要检查。
原文最后建议让 @claude 修改、再让 @codex 评审同一 PR。这是可尝试的协作方式,但文章没有给出实测效果,也没讲清对话只读限制下的具体交接配置。
能拿来做什么
- 把需要连续排查的测试失败放进专用频道,绑定正确仓库,并在提及时写明文件、失败现象和检查目标。
- 对短期连续任务使用
Stay open and remember;任务换题或交接前点击Start fresh,并把关键结论补进频道记录。 - 为需要隔离的频道创建不同 Handle,检查是否误选了
Add @claude instead,避免共享不必要的对话历史。 - 尝试双代理流程时,让一个负责修改、另一个阅读 PR 并提出意见,先核对权限配置,再由人审查测试证据和合并条件。