Origin 自动派发 Issue 给编程 Agent 并生成 PR
Origin Orchestrator 定期检查仓库任务队列,按就绪状态和优先级选择 Issue,再分配给 Claude Code 或 Codex,在独立 Git worktree 中执行并生成 PR,最终合并由人工负责。团队自报首个实际运行日完成 43 次运行,产出 21 个待合并 PR。
AI 深度解读
Origin 的 Orchestrator 想自动化的,是程序员在两次写代码之间反复做的协调工作:挑选 Issue、分配 Agent、启动任务、安排审查,再把修改意见送回去。它把流程推进到「可以合并」,最后是否合并仍由人决定。
作者团队首日启动了 43 次运行,得到 21 个等待合并的 PR。不过,这次实验更有参考价值的发现是:不少任务根本没准备好交给 Agent。理解这套流程,既能看到自动编程如何接入日常开发,也能看清它对任务质量和审查机制的要求。
Agent 能写代码以后,谁来决定下一件事?
此前,Origin 已经给每个 Issue 加上了 Start with 按钮。用户选择 Claude Code 或 Codex,Agent 就能在本机无界面运行,使用独立的 Git worktree 完成任务并创建 PR。Git worktree 可以理解为同一个仓库的另一份工作目录,让并行任务各自修改文件。
但下一项任务仍要等人挑选、分配和启动。Orchestrator 接管了这部分工作。
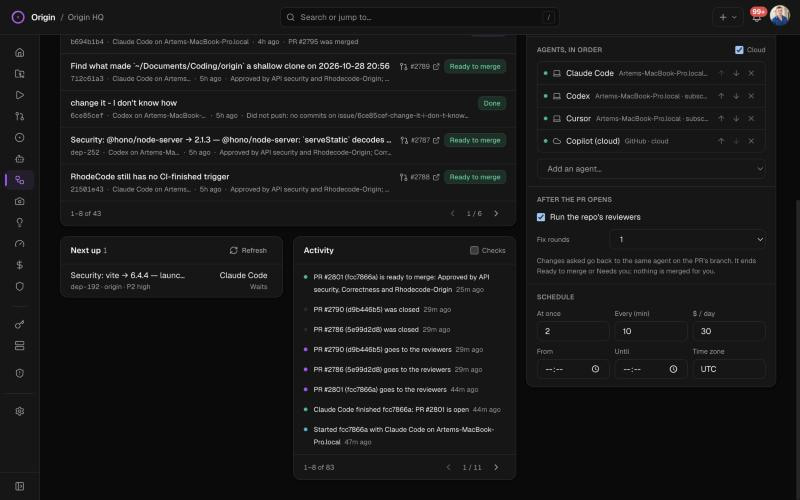
默认情况下,它每隔 10 分钟检查选定仓库。进入队列的 Issue 必须无人认领、所有依赖已经关闭,并符合任务类型、标签、最高优先级等过滤条件,再按优先级填满可用执行槽位。
调度之前,先判断任务是否真的能动手做。
这个规则来自一次碰壁。首日,它选中了 3 个以「Verify」开头的任务,以及 1 个写着等待 replay benchmark 的任务。它们各占用了约 15 分钟,最后在启动前检查中请求澄清。现在,这类任务和标记为 [Postponed] 的任务会被排除。
用户可以设置并发数、每日预算和执行时间窗口,例如只在夜间启动新任务。作者团队使用两个并发槽位。另外,同一次检查不会给同一个 Agent 启动超过一个新 Issue,避免表现较好的 Agent 一次拿走全部任务。
这能控制资源分配,但过滤仍依赖任务描述。单靠标题和标签,未必能判断一个任务是否具备明确的验收条件。
Agent 怎么选,失败以后怎么办?
Origin 先检查 Agent 是否可用。本地 Agent 需要安装并登录对应 CLI;Copilot、Cursor、Devin 等云端 Agent 则需要相应凭据。然后按三个信号评分:
- 历史完成率占 60%。优先使用 bug fix、feature、refactor、chore 等同类任务的记录。
- 用户设定的 Agent 顺序占 25%,保留团队偏好的影响。
- 计费模式占 15%,已有订阅的 Agent 比按 token 计费的 Agent 更有优势。
同类任务至少有 3 次运行记录,才使用该类别的完成率;不足时退回总体完成率。如果总运行数也不足 3 次,就给中性分,避免凭空生成成功率。
分配理由可以查看。例如,Claude Code 的一次分配依据是:10 次 bug fix 全部完成、用户排序第 1、使用 max 订阅,并运行在 Artems-MacBook-Pro.local 上。历史记录更新后,后续分配也会变化。
自动执行前可以先用 Dry run。它采用同一套调度与选人逻辑,只把计划和理由写进活动流,不启动任务。观察几轮后再切换到 Live,团队就能先检查规则是否符合预期。
Live 模式下,本地任务由现有的 origin review runner 领取,调用与手动启动相同的命令:
origin issue start --agent claude --background --force
要关注的是:原文虽然包含 --force,但没有解释它具体跳过哪些确认,不能仅凭参数名推断它取消了所有检查。
作者表示,运行仍包含独立 worktree、登录检查、任务清晰度预检查、时间限制,以及产出 PR 的要求。本地 Agent 的代码留在用户机器上,使用现有 Agent 账号;云端 Agent 经供应商启动,接收与手动启动相同的提示词。
失败处理也有节奏限制:排队后 30 分钟无人领取,任务过期;启动后失败,相关 Issue 在 6 小时内退出编排计划,避免每隔 10 分钟重复撞上同一个问题。跨两个 Origin 工作区共享仓库时,也会阻止重复启动。
自动审查能闭环,但首日数据该怎么读?
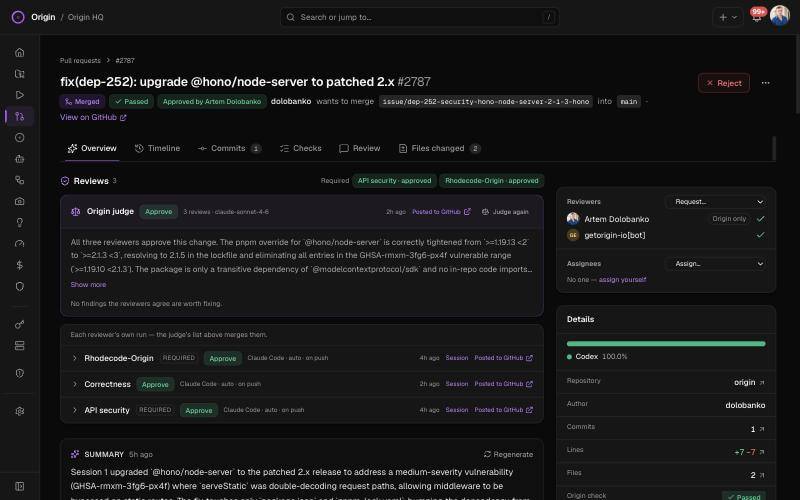
创建 PR 后,运行进入 In review,仓库配置的 reviewer agents 开始审查。所有必需审查者通过,才进入 Ready to merge 并通知人;自动化到这里停止。
如果审查要求修改,Origin 会把发现的问题汇总成一个修复 Issue,交回同一个编码 Agent,在同一分支继续修改。提交新代码后,必须重新审查。
只有针对最新 commit 的审查才有效,旧版本的批准不能沿用。
自动修复默认 1 轮,最多 3 轮。轮次用完仍有修改意见、修复失败或审查未完成,运行进入 Needs you,由人接手。
作者团队在 10 月 29 日开启 Live,配置是一台 MacBook、Claude Code 和 Codex、两个并发任务、每日 $30 预算。这里的 $30 是预算设置,原文没有给出实际支出。
当天 43 次运行中,Claude Code 承担 20 次,Codex 承担 23 次。结果分成三类:
- 25 次创建了 PR:21 个等待合并,2 个已经合并,另有 2 个被团队主动关闭。
- 14 次没有产生 commit:部分任务已被先前的 PR 完成,部分描述过于含糊,甚至有任务标题直言不知道怎么改。
- 4 次停在启动前检查,就是前面的验证与等待类任务。
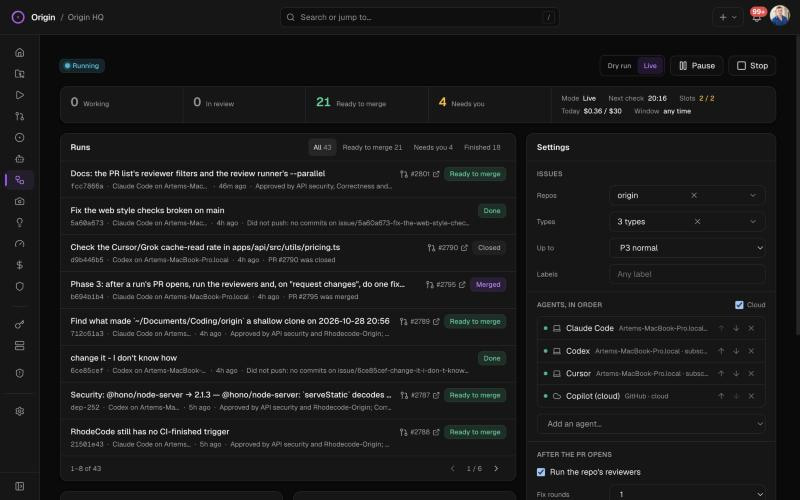
这里不能把「等待合并」直接理解为「已经正确交付」。它代表当前 commit 通过了配置的 Agent 审查,最终仍需人判断。
试运行还暴露了编排系统自身的问题:一次任务先结束、PR 后进入 Origin,导致审查被跳过;另一次由于 runner 优先处理必需审查者,3 个 PR 因可选审查者的问题滞留约 1 小时。作者称两项问题当天已修复。
他们据此判断,队列中大约三分之一的 Issue 并非可直接执行的编码任务。自动化把过期、重复、含糊和受阻任务集中暴露了出来。
我的判断
我更认可它对流程边界的处理:从可执行 Issue 推进到经过审查的 PR,失败有冷却时间,修复有轮次,最后保留人工合并。这比单纯让 Agent 连续领取任务,多考虑了实际开发中的状态变化。
但效果仍是作者团队的单日经验。原文没有人工调度对照组,没有任务规模、测试覆盖、后续缺陷和人工审查耗时,也没有解释「历史完成」如何定义。因此,43 次运行和 21 个待合并 PR 能说明流程跑通了,不能证明团队整体交付效率提高了多少。
60% / 25% / 15% 的路由权重同样缺少对照数据。至少 3 次同类记录就开始使用分类完成率,样本仍然很少;任务难度不同,完成率也未必可比。相较于固定让一个 Agent 执行全部任务,这种路由更容易解释和调整,但是否选得更准,原文尚未证明。
多个 Agent 审查也不等于多个独立的人类判断。它们可能遗漏相似问题,原文没有给出审查质量评估。对需要浏览器操作、视觉验收或外部系统联调的前端任务,仍要把对应验证写进验收条件,不能只看批准数量。
能拿来做什么
- 在前端或 Node 项目里先整理候选 Issue,补齐复现步骤、目标行为、验收方式和依赖,把已完成、等待条件和描述含糊的任务移出自动执行队列。
- 试用时先准备 Origin CLI、已登录的受支持 Agent CLI 和 Origin runner,再从 Dry run 观察几轮分配;检查它挑中的任务和理由,确认合理后切换 Live。
- 从少量并发开始,明确每日预算和执行窗口,并观察没有 commit、启动失败和反复修复的任务。这些记录能帮助判断问题出在任务描述、环境还是 Agent 执行。
- 把最新 commit 审查、有限修复轮次和人工合并设为明确流程;前端项目同时保留必要的构建、测试与页面验收,让
Ready to merge成为人工检查入口。