智能体记忆如何避免读到过期事实
正文提出将持久化记忆作为权威数据,摘要、向量和缓存均关联原始记录及其版本。根据陈旧数据的代价选择事务同步、定时更新或惰性重建,并用能否独立重建派生层检验架构边界。
AI 深度解读
Agent 已经把纠正后的事实存进数据库,回答时却还在引用旧数字,问题可能出在检索链路:事实更新了,向量和摘要没有跟着更新。原文讨论的就是这种安静发生的记忆漂移,以及如何用「权威记录 + 派生上下文」两层结构控制它。
对正在做知识库、RAG 或带长期记忆的编程助手的团队,这个设计值得检查。它能把一个模糊的回答质量问题,拆成可追踪的版本、同步策略和重建流程。
数据库已经改对了,Agent 为什么还答错
原文用一个假设场景解释问题:研究助手比较两个检索模型,检索到 Helios-RAG 在 BEIR 上的成绩为 0.92 nDCG@10,于是给出答案。但论文作者六周前已因数据污染问题把成绩更正为 0.78,系统当天就收录了更正。
错在哪里?旧摘要生成的 embedding 仍在检索路径上,没人把它标记为过期。新事实存在,Agent 却没读到。
这里的数字是说明架构问题的案例,不能当成真实模型测评。
事实有有效期,embedding 则是某一刻计算出来的表示。事实从 v1 更新到 v2,不会自动让旧向量失效。摘要也一样:语言依然通顺,内容却可能过时。
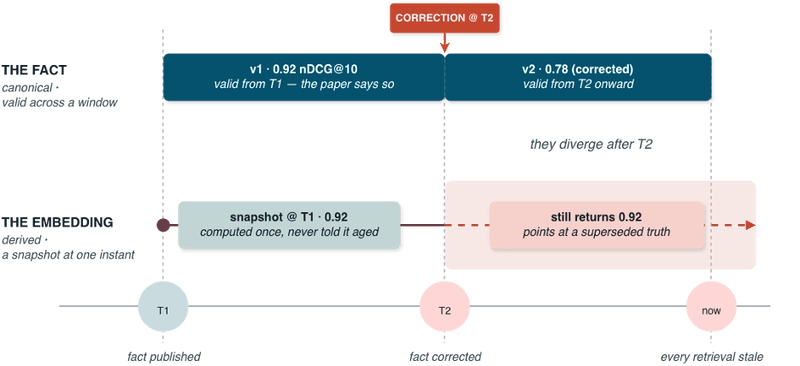
这种错误难发现,是因为过期索引仍能正常返回结果,不会抛异常。尤其当事实放在 Postgres、向量放在 Pinecone 或 Elasticsearch 时,两边的同步成了独立流程。检索又通常绕过原始记录,恰好避开了已经修正的数据。
检索结果看起来合理,不能证明它仍然有效。
两层记忆的边界,靠权威关系划分
作者把记忆分为两层。
持久记忆保存系统认可的记录,包括事实、决策、政策、偏好,以及来源、版本和有效期。派生上下文则把这些记录加工成方便读取的形态,包括 embedding、摘要、预关联视图和反规范化数据。
两层可以存在不同系统,也可以放在同一行。关键约束是:派生内容必须能追溯到权威记录的具体版本;发生冲突时,以权威记录为准。
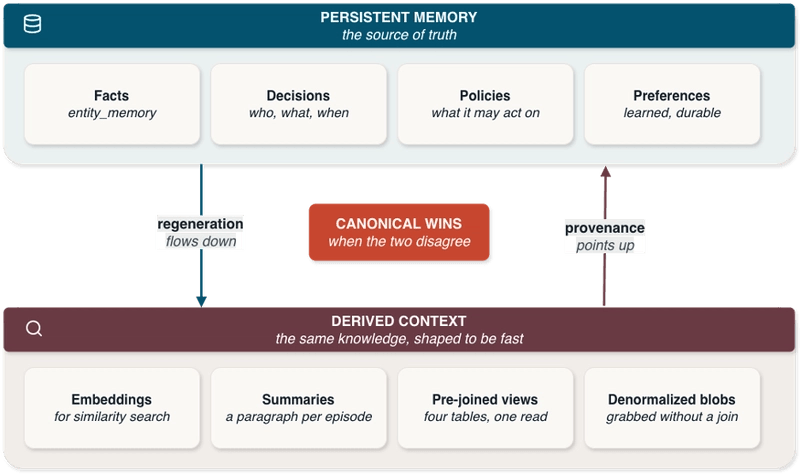
原文沿用前两篇的八张类型化表,记录按租户隔离并进行版本管理。其中,entity_memory.content 保存事实,embedding 保存由它生成的 VECTOR(384, FLOAT32)。两者同处一行,权威关系仍然清楚。
conversation_memory 则不放向量。它保存大量追加写入的原始事件,近期对话的语义缓存另行生成。作者认为,逐条为工具调用日志计算 embedding,成本与收益不匹配。
不过,事实变化也不代表所有摘要都该覆盖。比如 Q3 规划会议的摘要,可能要保留当时的认知和决策依据。后来事实变了,重写历史摘要反而会丢失信息。
因此,每份派生内容都需要关联 source_event_id 和 version。来源变化后,再按用途选择:
- 重新生成,用于需要反映当前事实的文档分块和视图。
- 使其过期,用于已经失去意义的派生结果。
- 保留并注明版本,用于历史快照,例如标明来自 transcript v3,而原始记录已到 v5。
有意保留旧版本与意外过期,需要靠这些元数据区分。
同步要多快,取决于答错一次的代价
作者给出三种同步策略,选择依据是旧数据能被容忍多久。
懒更新是在写入时标记失效,等下次读取时重建。它能减少无效计算,但不能把首次访问旧内容直接当作正常命中。失效标记必须进入实际读取流程。
定时更新按每五分钟、每小时或每晚运行,适合会议摘要、对话汇总等允许延迟的内容。刷新间隔只是预期窗口;任务失败后,实际过期时间还会继续增加。
事务更新则把事实和派生内容放进同一次事务,成功一起提交,失败一起回滚。适合不常修改、但旧值会直接误导用户的关键事实,代价是写入要承担 embedding 生成延迟。
下面这段 SQL 展示了如何新增更正记录、生成新向量,并在同一事务中退役旧记录:
-- Corrected fact and its new embedding: one INSERT, one transaction.
INSERT INTO entity_memory (id, tenant_id, user_id, subject, predicate, content,
                           content_hash, embedding, confidence, written_by,
                           source_event_id, version, valid_from, created_at)
SELECT :new_id, tenant_id, user_id, subject, predicate,
       'Helios-RAG achieves 0.78 nDCG@10 on BEIR (corrected).',
       :corrected_hash,
       VECTOR_EMBEDDING(ALL_MINILM_L12_V2 USING
         'Helios-RAG achieves 0.78 nDCG@10 on BEIR (corrected).' AS DATA),
       confidence, written_by, :correction_event_id, version + 1,
       SYS_EXTRACT_UTC(SYSTIMESTAMP), SYS_EXTRACT_UTC(SYSTIMESTAMP)
FROM   entity_memory WHERE id = :old_id;

-- Same transaction: retire the old row, then commit together.
UPDATE entity_memory SET valid_until = SYS_EXTRACT_UTC(SYSTIMESTAMP),
       superseded_by = :new_id WHERE id = :old_id;
COMMIT;
重点看 VECTOR_EMBEDDING 和最后的 COMMIT:更正文本与向量共同写入,旧记录同时设置 valid_until 和 superseded_by。但查询也必须排除失效版本;这段写入代码没有展示检索侧的过滤规则。
作者进一步提出一个验收标准:能否删除派生层,仅凭持久记忆重建它?
原文用 DBMS_VECTOR_CHAIN.UTL_TO_CHUNKS 分块,再用 VECTOR_EMBEDDING 生成向量,模型是 ALL_MINILM_L12_V2,分块参数为 {"by":"words","max":200,"overlap":20},即按词切分、每块最多 200 词、重叠 20 词。
这条重建路径也服务于模型迁移:新增影子向量列,从权威记录回填,比较新旧效果,再切换索引并删除旧列。修改分块策略同理。提供的原文在这一段末尾被截断,没有完整展开后续操作。
我的判断
我认同它把「记忆准确」落到版本、来源和重建能力上的做法。调整召回数量、提示词或重排模型,都无法自动修复一份已经过期的摘要。对知识库而言,更新与删除流程应当和首次入库一样受到重视。
但文章明显偏向 Oracle AI Database 的单库方案。把事实与向量放进同一事务,确实能减少跨系统协调;同表存储却不会自动保证所有缓存、摘要、外部索引都及时更新。文章对「提交后不存在新事实配旧索引」的描述,应限定在示例覆盖的事务和读取路径内。
原文也没有给出吞吐、写入延迟、重建成本或检索准确率的对照数据。「事实变更增加几百毫秒可以接受」属于作者的场景判断,不能直接套到一般团队。
Postgres 配外部向量库仍可采用相同边界,通过可靠事件、重试、版本校验与定期核对维护一致性,只是运维责任更多。反过来,摘要生成具有损耗;仅保存原文和版本,也未必能逐字复现旧摘要,若业务要求复现,还需记录生成配置。
另外,标题提到 Oracle 与 DeepLearning.AI 推出课程,但提供的正文没有课程大纲、时长或报名信息。它能支撑的是架构解读,不能据此评价课程。
能拿来做什么
- 给知识库的分块、向量和摘要增加来源记录 ID 与版本,并检查检索结果是否来自已失效的记录;前端展示引用时,也可以明确区分当前资料与历史快照。
- 在 Node 服务中按记忆类型制定更新策略:关键事实优先保证一致性,对话汇总允许异步刷新,历史决策摘要保留生成时的来源版本。
- 为日常 AI 编程助手加入一次「资料更正」验证:先入库旧说明,再修正 API 用法,检查回答是否仍引用旧分块,以及删除资料后是否仍能召回它。
- 在测试环境重建一份派生索引,确认只靠权威记录就能恢复检索。切换 embedding 模型或分块参数前,先用影子索引比较效果,再替换线上索引。