GPT-6 Cyber 发布,覆盖漏洞发现与修补
OpenAI 推出面向漏洞发现、利用开发与补丁建议的 GPT-6 Cyber。报道援引官方数据称,该模型发现了 Firefox 的 81 个未知漏洞,并为 Linux 内核开发了 948 个可用漏洞利用。
AI 深度解读
GPT-6 Cyber 把找漏洞、构造可用利用程序和建议补丁放进了同一套能力里。按原文转述的 OpenAI 数据,它已经在 Firefox 和 Linux 内核研究中产出结果,安全工作正从「让 AI 看看代码」走向自动验证漏洞是否真的能被利用。
但这篇报道最值得程序员关注的,并非模型又刷高了多少分,而是三个问题:结果怎样验证,成本怎么算,以及一个能攻破系统的模型,如何被限制在授权范围内。目前的成绩主要来自 OpenAI 自报,能力表现和安全承诺都需要分开看。
找到可疑代码,离证明漏洞还有多远
OpenAI 对 GPT-6 Cyber 的定位是安全专用模型:发现缺陷,开发可用的漏洞利用程序,再提出修复建议。这里的「可用」很关键。指出一段代码可能越界,与证明它能触发实际安全问题,需要不同层次的验证。
在 ExploitGym 上,模型需要利用远程系统中的指定漏洞。GPT-6 Cyber 得分为 48.5%,前代 GPT-5.6 Cyber 为 32.1%。图中 GPT-6 Astra(Daybreak Blue)为 42.4%,启用安全防护的 GPT-6 Astra 则为 0.0%。
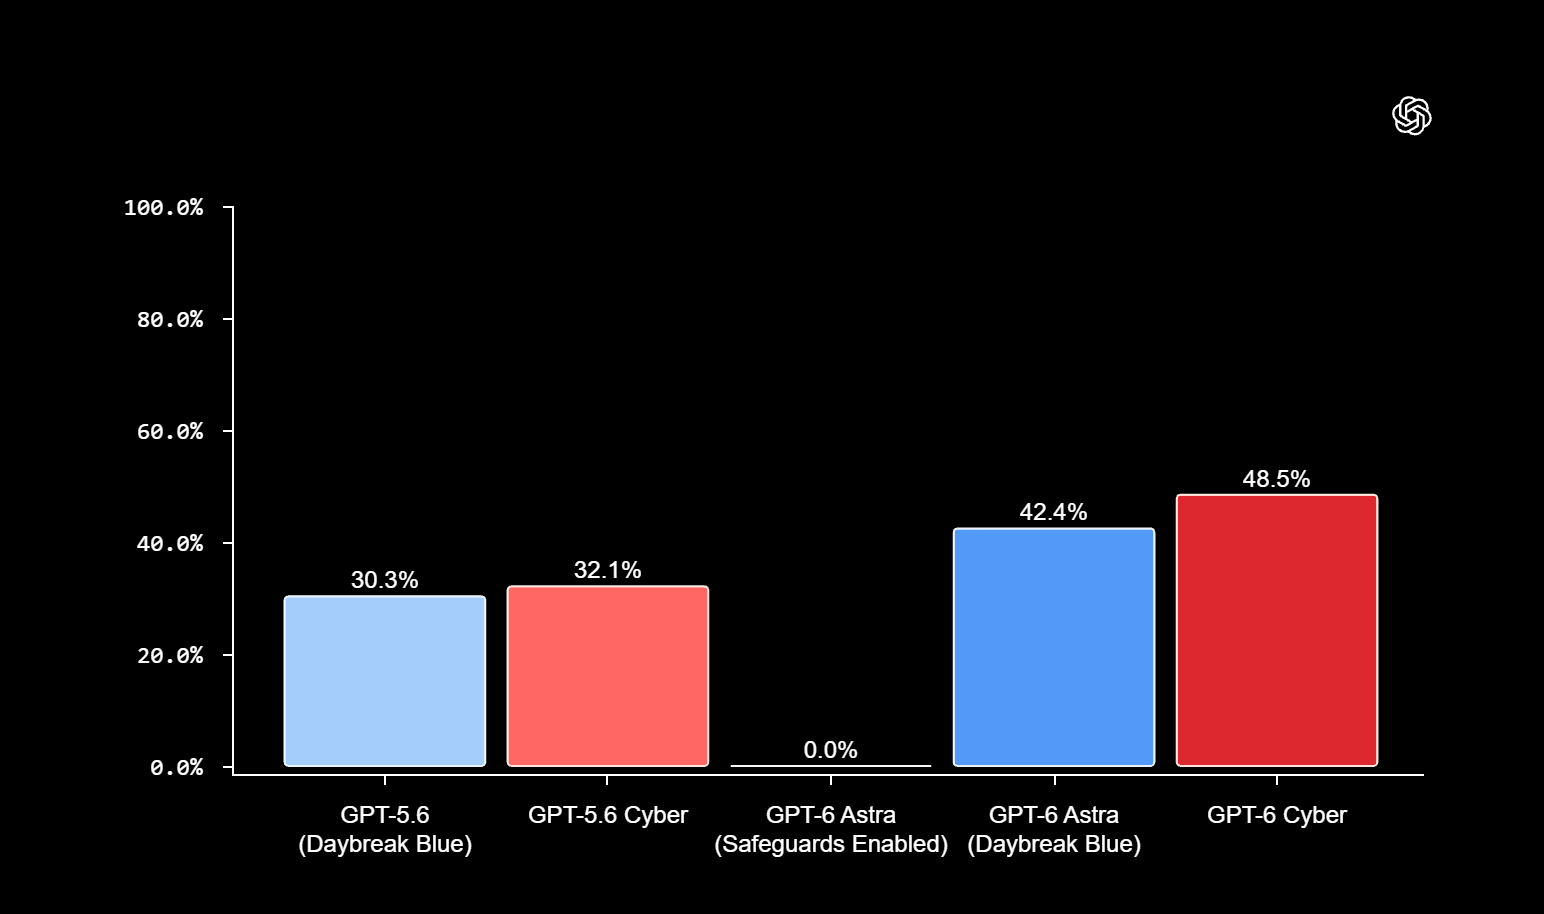
这些数字不能直接当成模型能力排名。安全防护可能限制模型执行利用操作,因此 0.0% 不能单独证明模型不会攻击,也不能证明它不存在被滥用的风险。
另一项新测试要求模型在拿不到源码的情况下寻找 Web 应用漏洞,GPT-6 Cyber 的命中率为 40.3%,未经安全专项训练的 GPT-6 Astra 为 32.0%。这与 Web 开发更接近,但原文没有交代应用规模、漏洞分布和测试预算,不能据此推算普通业务系统的漏洞检出率。
这些成绩说明专项训练有收益,但收益大小仍受测试条件限制。
Linux 的结果,靠的是模型加验证流水线
真实项目中,GPT-6 Cyber 据称在 Firefox 找到了 81 个此前未知的严重漏洞,还证明了 30 个已知问题比原先判断的更严重。原文称 Mozilla 接受了报告,并已发布修复。相较单纯的评测分数,维护者接收报告并修复,更能说明结果具有实际价值。
Linux 内核的数字更大:复现 1,724 个漏洞,为其中 948 个开发了可用利用程序;同等条件下,GPT-5.6 Sol 完成了 166 个。OpenAI 还向维护者报告了 304 项关键发现,并附上修复建议。这里的对照模型是 GPT-5.6 Sol,与前面 ExploitGym 的 GPT-5.6 Cyber 不同,不能混用。
这些成果来自一套专门搭建的自动化系统。侦察与分析智能体先扫描约 5,034 处安全相关位置,覆盖约 7% 的代码库,再筛出 2,308 个候选问题,在隔离虚拟机里确认 1,724 个漏洞,最后构造出 948 个可用利用程序。
对工程团队来说,这条流水线比「模型发现漏洞」更有参考意义:候选问题必须经过执行验证,才能逐步变成可信报告。模型负责提出和推进假设,隔离环境负责提供证据。
整轮计算费用为 1,213,430 美元,平均每个利用程序约 1,279 美元。原文拿它与 Pwn2Own、TyphoonPWN 历史上同类发现的 20,000 至 70,000 美元奖金比较,但计算费用和漏洞奖金的口径不同。报道没有给出人工复核、系统开发和后续修复的完整成本,不能直接据此宣布安全研究便宜了多少倍。
OpenAI 还称智能体使用了至少 10 种外部内核安全专家此前也不知道的新攻击技巧。这项说法仍来自厂商,原文也承认,「新方法」究竟指独立发现还是已有知识的重组,存在争议。
能力越强,授权边界越需要单独验证
OpenAI 称,它使用了受 Hugging Face 事件启发的蜜罐等方法训练边界遵守能力。未添加专门安全指令时,GPT-6 Cyber 在 99.93% 的测试中没有越界,前代为 94.49%;启用安全指令后,测试结果为 100%。
这只能说明给定测试中的表现。原文没有提供测试次数、边界定义和环境覆盖情况,不能把 100% 理解成部署后的绝对保证。OpenAI 自己也在 Preparedness Framework 中,将 GPT-6 Cyber 和基础模型 GPT-6 Astra 的网络安全风险评为「Critical」。
访问因此采取分级开放。GPT-6 Cyber 最初通过 API 和 Codex 提供给部分 Daybreak Red 客户,之后逐步扩展至全部客户;GPT-5.6 Cyber 同期向全部 Daybreak Red 用户开放,GPT-6 Astra 的 Daybreak Blue alpha 访问也将扩大。
防护措施包括核对行动是否符合用户权限、监测新披露漏洞、通过 Private Safety Processing 自动执行安全检查,以及为 Daybreak Red 设置 IP 访问限制。OpenAI 还建议在隔离环境中运行,并保留人工监督。
针对电厂、水处理设施等关键基础设施,公司提出了 Daybreak Red for Critical Infrastructure 授权测试分组,并提及十亿美元规模的 Daybreak for Frontline Defenders 资助计划。它希望利用一个有限的时间窗口先帮助防守方加固软件,但原文引用的 Epoch AI 研究也提醒:开放的 GLM 模型已经可能利用已知但尚未修补的 Firefox 漏洞,防守方并不会天然独占这些能力。
我的判断
我更认可这篇报道展示的验证流程:筛选、复现、利用验证、提出修复建议,各阶段有不同的交付物。相比让通用 AI 对整个仓库做一次安全点评,这种流程更容易追踪证据,也更方便维护者复核。
但报道没有给出与人工审计、静态分析或模糊测试的完整对照,也没有公开补丁正确率、误报率和端到端成本。它还不能支持「专用模型可以替代现有安全工具」的结论。
发现漏洞、生成补丁、确认修复,是三件需要分别验收的事。
Firefox 的维护者反馈提供了现实支撑;其他基准成绩、边界遵守率和新攻击技巧,目前主要还是厂商报告,尚无已发表的独立模型测试。一般团队也未必具备同等预算和隔离验证设施,应当借鉴流程,再判断是否需要同等级的模型。
能拿来做什么
- 给 Web 或 Node 项目安排 AI 安全检查时,先写清允许访问的域名、接口和测试账号,并准备隔离环境,把授权范围变成可执行的限制。
- 把 AI 提交的问题分成候选缺陷、可复现漏洞和修复建议,要求附上触发条件与验证证据,再决定哪些需要开发者优先处理。
- 评估安全模型时,同时记录复现成功率、人工复核耗时和补丁验证结果;仅凭生成报告数量,很难判断它是否减少了团队工作量。
- 对已确认的依赖漏洞及时升级和回归验证。原文提到的 GLM 案例说明,漏洞已经公开但补丁尚未落地的间隙,同样需要认真处理。