OpenAI 披露内核漏洞自动发现与修补流程
据报道,OpenAI 在隔离研究环境中运行自动化 Linux 内核审查,流程覆盖发现、动态验证、可利用性评估和补丁生成,最终交由人工审核。标题称单次运行耗资约 120 万美元、发现 948 个提权缺陷,正文摘录另列出 2308 个候选发现。
AI 深度解读
一次自动化运行,花掉 $1,213,430 的 API 额度,产出 948 个可工作的 Linux 本地提权利用。这是原文转述的 OpenAI 实验结果。它想展示的,是 AI 能把发现漏洞、复现、评估可利用性和生成补丁串成一条流水线。
对程序员有参考价值的是这套交付方式:每项发现都带着验证记录和修复候选。但原文末尾也明确写了暂未找到确认信息,因此数字应当按待核实的报道阅读,不能直接当成已验证的行业基准。
自动化的价值,在于每个发现都能继续往下验证
按原文描述,这套系统由一个尚未公布名称、即将推出的网络安全模型驱动,依次经过四个阶段:漏洞发现、动态验证、可利用性评估、补丁生成。
这里的动态验证,就是实际运行并尝试复现问题,检查模型指出的缺陷是否真的存在。可利用性评估则继续追问:这个缺陷能造成什么后果,能否形成可工作的利用?
四个阶段逐级交接。作者称,直到最终人工审核之前,系统都不需要人工介入;每个报告会附带完整的验证与补丁生成历史。
发现可疑代码只是起点,能复现、能解释、能提出修复,才接近可交付的安全研究结果。
这与让 AI 扫一遍仓库、输出风险清单有明显区别。后者经常把验证工作留给开发者,而这套流程试图把验证成本提前消化掉。
948 个提权利用,不能直接读成 948 个独立漏洞
报道给出的实验时间是 2026 年 10 月中旬,目标是某个桌面 Linux 发行版原样交付的系统,运行环境受控且隔离。原文称,这不是针对真实攻击的响应,也没有入侵线上系统。
这一轮产生了几组不同口径的数据:
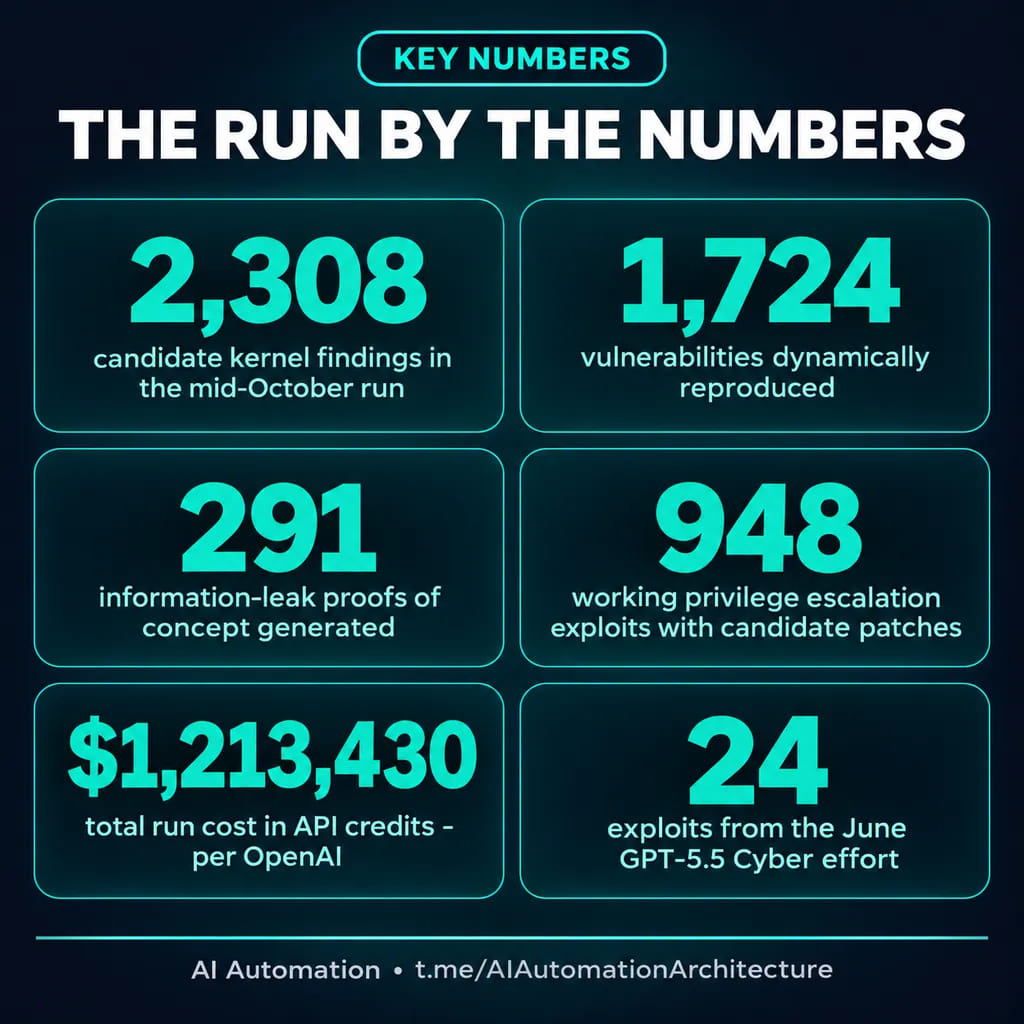
- 发现阶段提出 2,308 项内核候选问题。
- 动态验证将其中 1,724 项复现为真实漏洞。
- 可利用性评估产出 291 个信息泄露概念验证,即 PoC。
- 最终交付 948 个可工作的本地提权利用,每个都附有候选补丁、根因分析和最小崩溃 PoC。
本地提权指攻击者已经能在机器上执行某些操作,再利用漏洞取得更高权限,不能把它理解成无需前提就能远程接管机器。
这些数字也不能直接相加。原文没有交代 291 个信息泄露 PoC 与 948 个提权利用是否重叠,也没有解释不同利用是否对应独立根因。因此,标题中的 948 项成果,更严谨的读法是「948 个可工作的本地提权利用」,独立漏洞数量仍需去重信息支持。
报道还将其与 2026 年 6 月的 Patch the Planet 项目比较:当时 GPT-5.5 Cyber 产出 24 个 Linux 内核本地提权利用,新一轮约为其 40 倍。但新模型没有名称,目标规模与计算投入也未对齐,不能把这个倍率直接解释成模型能力增长。
单个利用约 $1,279,离完整修复成本还有多远
原文称,整轮消耗 $1,213,430 的 API 额度,除以 948 个可工作的利用,约为每个 $1,279。
这给出了一个可讨论的成本口径:自动化系统不只报告产出,也报告获得这些产出的 API 开销。但它没有说明人员审核、实验基础设施、补丁回归验证和后续沟通是否计入成本。
每个可工作利用的 API 成本,不等于每个漏洞完成修复的总成本。
人工审核仍是流程的一部分。按报道,所有结果离开实验室之前都需要人工签字;报告从最严重的问题开始,经 Patch the Planet 合作伙伴协调披露。
补丁也只是候选方案,仍要经过正常的 Linux 上游维护者审核。生成一个看起来能阻止崩溃的改动,与确认它没有破坏其他内核行为,是两回事。
我的判断
我认可把复现、根因和候选修复一起交付的方向。相比只给风险评分或可疑代码行,这些材料更方便维护者判断问题,也更容易发现模型误报。
但原文的证据不足以支持「安全研究已经变成可预测的预算流水线」这一强结论。文章标注日期为 2026 年 11 月 4 日,同时写明暂未找到确认信息;它没有提供具体发行版、内核版本、漏洞去重规则、补丁接受率,也没有与人工研究或模糊测试进行同条件比较。
因此,成本优势和长期提速目前都应保留问号。尤其是「长期无人处理的漏洞会更快修复」属于作者对影响的推断,实际还取决于审核与回归测试能否跟上产出速度。
能拿来做什么
- 给 Node 或全栈项目做 AI 安全审查时,可以要求每项发现附上触发条件、最小复现、根因说明和候选修复,让团队能实际验收。
- 统计 AI 编程效果时,可以分别记录候选问题、成功复现问题和通过审核的修复数量,避免把模型输出条数当成有效成果。
- 评估自动化修复预算时,可以同时记录 API 开销与人工审核时间,并保留测试、合入环节,不能直接套用报道中的每项 $1,279。