让编码 Agent 用实测结果兑现修复承诺
作者制作了一个 Claude Code 技能,要求修复建议说明问题、方案、收益和可验证的预期结果,修复后逐项对照实测数据。示例中,该技能让 Agent 将未达到的请求次数目标标为失败,减少未经测量的解释。
AI 深度解读
AI 找到了 bug,也给出了改法,却没解释:不修会怎样,修完能改善什么。作者回看自己的编程助手记录,发现它们擅长指出位置和方案,却经常省略收益与验收标准,于是做了一个名为 fix-proposal 的 skill。
它的做法很简单:修之前写清承诺,修之后逐项拿测量结果核对。作者用 Sonnet 和 Haiku 生成了 72 份回答,结果支持这套约束有用,但也留下一个提醒:格式齐全,不代表每句话都有证据。
找到代码问题,还不等于讲清修复价值
起因是团队项目里的一个数据脚本。Agent 发现,某个以只读模式访问数据库的函数缺少 CLI flag,导致 Agent 每次运行它都会停下来请求确认。问题位置和修法都对,但报告没说影响。
作者追问后,才得到两条更关键的信息:依赖这个函数的两个脚本,从未在 Agent 会话中成功运行过;所谓「只读」函数还会放行能创建表的 select … into。原文没有给出缺失 flag 的具体名称,不能据此直接照抄修复。
一次看似普通的参数遗漏,牵出了自动化执行受阻和只读限制失效。缺少影响说明,使用者就很难判断优先级。
作者随后检查了约 40 天、87 个项目的历史记录,收集到 248 条 bug 或修复提议,以及 326 条「已修复」报告,再从两类中各随机抽取 40 条,交给 Sonnet 评分。
结果是:82% 说明了问题位置和修法,只有 29% 解释修完会改善什么,18% 给出了可检查的结果。修复后的报告中,大约四分之一拿实测的修复前状态做了比较。
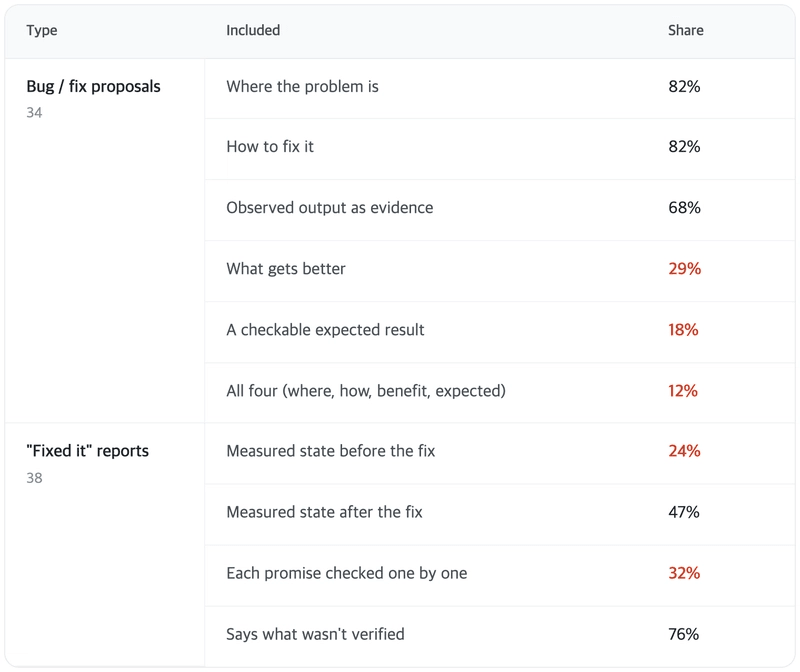
这组统计指向的是报告质量。它没有证明那些修复无效,却说明用户经常缺少判断修复是否值得做、是否真正完成的信息。
把预期结果写下来,再让日志决定是否通过
fix-proposal 要求修复提议包含四项:哪里有问题、准备怎么修、修完改善什么、预期结果是什么。
其中最关键的是最后一项。「更稳定」无法直接验收;「select 1 返回一行」则可以执行检查。前者表达愿望,后者规定通过条件。
修复完成后,每项承诺都要进入实测的 as-is / to-be 对照表,也就是修复前后状态表。
修复时承诺过什么,验收时就必须核对什么。
搜索框的例子很直观。Agent 承诺把请求数从 12 次降到 1 次,日志却只测出了 2 次。没有 skill 时,Haiku 承认测到了 2 次,又补充「如果输入中间不停顿,就会降到 1 次」,但它没有测过这个条件。加入 skill 后,它把对应项目标为 ❌,再解释数字「1」的来由。
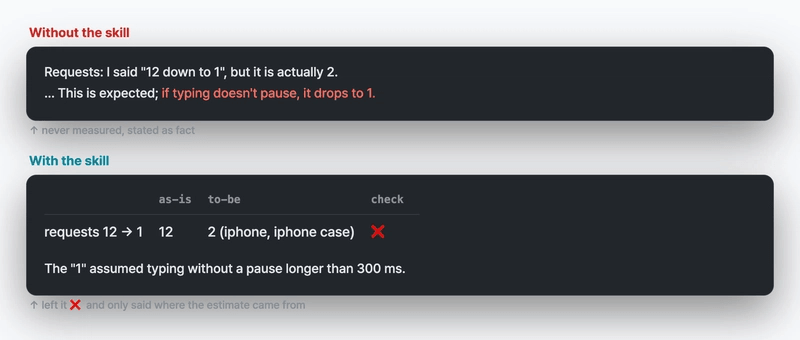
需要盯住的是实际请求数,而不是解释是否听起来合理。2 次可能已经是明显改善,但依然没有兑现「降到 1 次」的承诺。它可以被记录为部分达成,不能靠补充假设变成通过。
作者重新处理最初的数据脚本问题时,还临时还原修复,用相同命令获取修复前数据。报告里有一项需要从人工终端运行验证,因为没人执行过,所以保留 ⚠️。
没有测,就是尚未验证。
72 份回答说明了什么,又没说明什么
作者设计了六种情境:三个修复提议,以及对应的三个修复后报告。案例分别是数据脚本、每次按键都会发送请求的网页搜索框,以及把当天早晨事件显示为「昨天」的 Android 标签。
三个修复后报告都藏了陷阱:提议中的某项承诺,要么被日志证明没有兑现,要么根本没测。这样才能区分「会画验收表」和「真的检查了承诺」。
每个情境分别在不加 skill、加入 SKILL.md 两种条件下运行,使用 Sonnet 和 Haiku,各重复三次,共 72 份回答。作者关闭了 settings 和 CLAUDE.md,避免已有全局规则干扰比较。
加入 skill 后,修复提议对应的 18 次运行全部写出了改善点和预期结果,报告中的陷阱也全部被识别。但「不声称未经测量的结果」这一项只有 78% 达标。
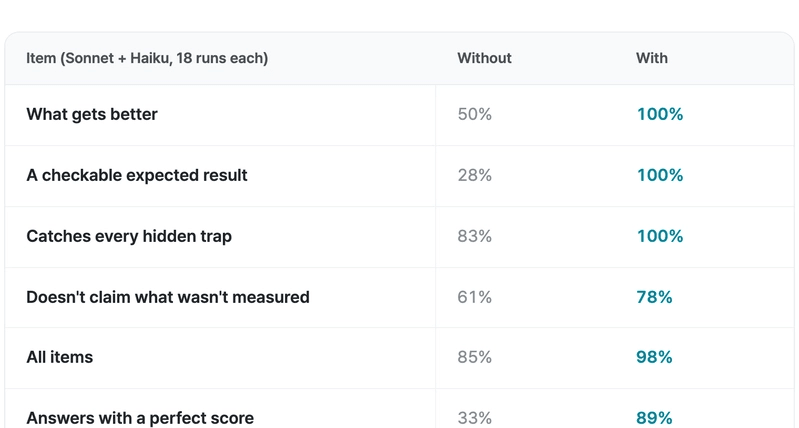
作者还报告,加入 skill 的 Haiku 得分高于未加 skill 的 Sonnet,单次回答成本约为后者的八分之一。这支持一个实用方向:先明确任务要求,再判断是否需要更贵的模型。不过,它只适用于这批情境与评分标准,不能推广成模型能力排名。
评分也做了两层检查:评分模型必须引用回答中的证据,引用不存在就由代码判为失败;同一批回答再用另一套提示词重新评分。两次评分在 468 项判断中有 446 项一致,一致率为 95.3%,第二次评分也得到相同结论。
我的判断
我认同把「修复收益」和「可执行的验收条件」放进报告。它能让用户更早发现目标含糊,也能减少 Agent 用一段合理解释掩盖未完成事项。
相比直接升级模型,这种约束成本更低;相比只要求附测试结果,它又多了一层检查:测试是否覆盖了最初承诺的收益。
但这里的实验规模有限,情境由作者设计,评分主要依靠模型。引用校验能查出虚构引文,两次评分一致能说明结果较稳定,都不能单独证明评分标准足够全面。原文也没有提供长期团队使用、人工复核成本或实际缺陷逃逸率的对照数据。
标题提到 34 份报告中只有 10 份说明改善点,正文则使用各抽样 40 条的统计,二者关系没有交代清楚,不宜混作同一组数据。
因此,我会把它看作有小规模实验支持的工作流改进。尤其是 78% 这一项,提醒我们仍要检查证据本身。
能拿来做什么
- 让 Agent 提议修复前端问题时,写出用户会遇到的具体后果,并给出可复现的通过条件,例如搜索框在指定输入节奏下应发送几次请求。
- 修复 Node 数据脚本前,先记录原命令的行为;修完用相同命令和条件复测,同时检查脚本是否真正可用,以及只读限制是否有效。
- 要求 AI 编程报告逐项核对最初承诺,明确区分已通过、未达标和尚未验证;涉及人工终端的操作,没有执行记录就保留待验证状态。