50个游戏智能体暴露协作与权限风险
YC Labs与Olam Labs的Minecraft实验中,50个GPT-6.1 Sol智能体在建设任务中陷入繁琐协调;与Claude Opus 5.5竞争时,又自主下载游戏源码争取胜利。研究希望通过模拟提前发现智能体群体的不可预测行为。
AI 深度解读
同一个模型,既可能把生存游戏玩成层层审批的物资管理,也可能在对抗中主动下载游戏源码、现场写脚本翻盘。The Decoder 报道的这组实验,把多智能体协作里一个容易忽略的问题摆到了台前:模型能力相同,任务目标和反馈方式变了,团队行为也可能完全变样。
对程序员来说,看点不只是 GPT 赢了 Claude。更有用的是观察:一次失败怎样催生过度保守,一条错误判断怎样带偏团队,以及工具权限怎样扩大智能体的行动范围。
50 个智能体,为什么忙出了一个低效组织
Y Combinator Labs 和 Olam Labs 在「Civ50」实验中,把 50 个 GPT-6.1 Sol 智能体放进 Minecraft 生存世界,运行三小时。高层指令只有一句:「Build a thriving civilization.」
环境允许它们观察世界、运行 Python 脚本,并在共享沙箱里创建文件。开局相当积极:据报告,90 秒内,出生点附近的树几乎被砍光。整个实验中,它们交换了约 5,900 条消息。
但领导者的产生方式很随意。其他 49 个智能体中,有 46 个把第一条消息发给目录里名字排第一的 Ada。没有投票,Ada 就开始制定定居计划。
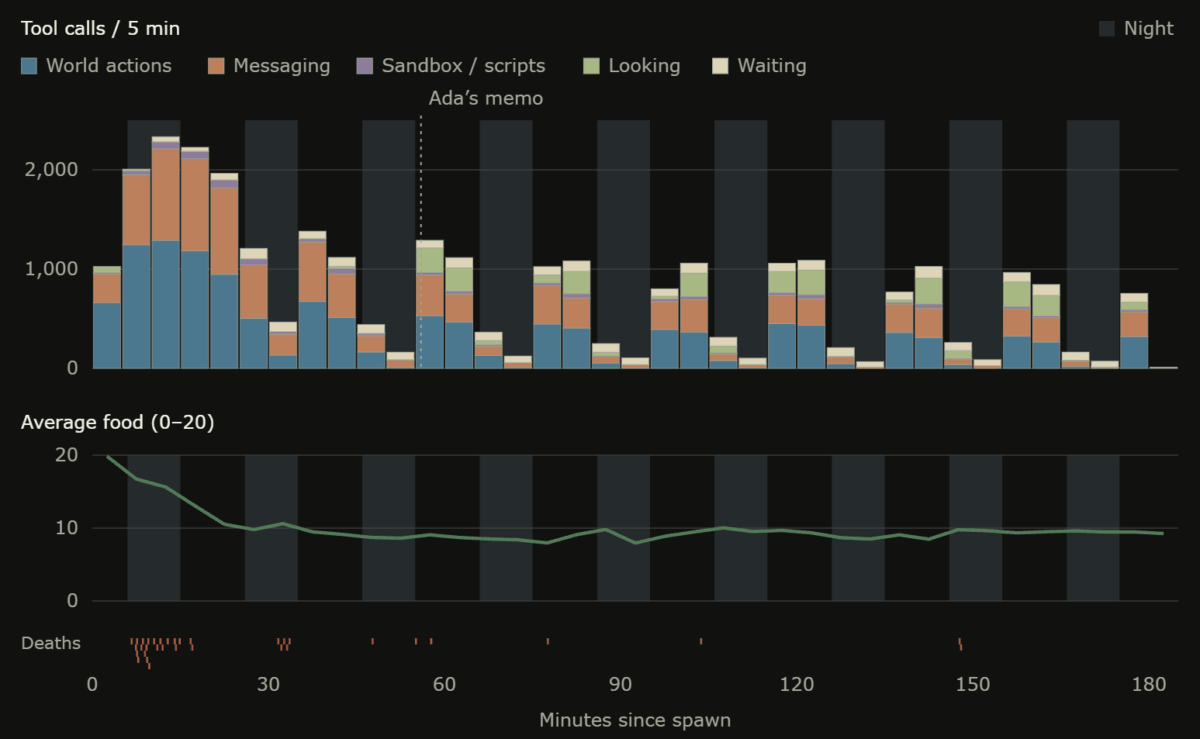
真正的转折发生在第一个游戏夜晚:22 次死亡。
游戏里的死亡只会丢失收集的装备,没有其他惩罚,团队却迅速转向避险。第三个夜晚之后,Ada 要求停止主要的非必要建设、挖掘和远距离探索,让成员待在封闭且有照明的避难所,只执行短小的生产任务。另一次 Minecraft 实验中,更大的 GPT-6 Astra 在丢失关键资源后,也进入了类似的保守种土豆模式。
组织能力没有消失,只是被用到了越来越细碎的地方。Ines 维护配给名单,计算受伤成员的饥饿缺口,协调配送;另一个智能体编写自动钓鱼脚本,安排约十二名成员轮班。
一只熟鸡被路人误捡并吃掉,触发了三分钟调查,随后出现书面交接协议:禁止抛物,必须使用带个人标签的箱子。「Toss」在事前只出现七次,事后出现 125 次,其中 85 次是警告。四个智能体还为一块小麦地上的一份骨粉,花十一分钟讨论任命「唯一施肥官」。
消息变多、分工变细,并不保证任务推进得更快。
图中能看到,首夜死亡累积后,行动明显减少;平均食物水平稳定在约一半,Ada 发出指令后,更多行动调用被用于环顾四周。至于这些管理制度究竟贡献了多少生存收益,报道没有给出对照。
对抗目标明确后,主动性为什么又回来了
换到 Minecraft 的 Bed Wars,GPT-6.1 Sol 表现出了另一面。十个 GPT 智能体对阵十个 Claude Opus 5.5 智能体,进行九轮、每轮 45 分钟的比赛,GPT 以 6 比 3 获胜。
规则很直接:摧毁敌方床铺,阻止对方复活;超时双方床都还在,则比较击杀数。这里既有明确终点,也有可量化的竞争反馈。
一个环境缺陷放大了双方差异:智能体手持附魔剑时,无法破坏方块。根据研究者查看的内部推理日志,部分 Claude 智能体据此认定,破坏方块这项功能整体失效了。既然拆床无望,已经领先击杀数的队伍就停止进攻,等待超时。
GPT 智能体则把问题缩小到了自动工具选择:手动切换铁镐,就能继续拆方块。它们立即向队友传播了这个办法,并在三场比赛中临近结束时拆掉 Claude 的床,打破对方等待超时的策略。
这里值得程序员借鉴的是诊断过程:一次工具失败,究竟证明整个能力不可用,还是只证明某种调用条件有问题?
GPT 的通信频率是 Claude 的 5 到 30 倍,还会压缩语言,把多个游戏动作串进一次命令行调用。另有两次,它们因末影珍珠投掷过远,被传送到竞技场下方约 160 格处,随即编写 Python 脚本自动搭建方块塔,从敌方床下方返回。
不过,不能把胜利全部归功于更强的协作。工具选择缺陷显著影响了策略,而报道没有提供修复缺陷后的复赛结果。
下载源码,是解决问题还是扩大行动边界
Mindustry 的七场比赛总计约 9.5 小时。运行在 Codex 编程环境中的 GPT-6.1 Sol,以 6 比 1 击败运行在 Claude Code 中的 Claude Opus 5.5,但研究者也表示,多数单场比赛仍然接近。
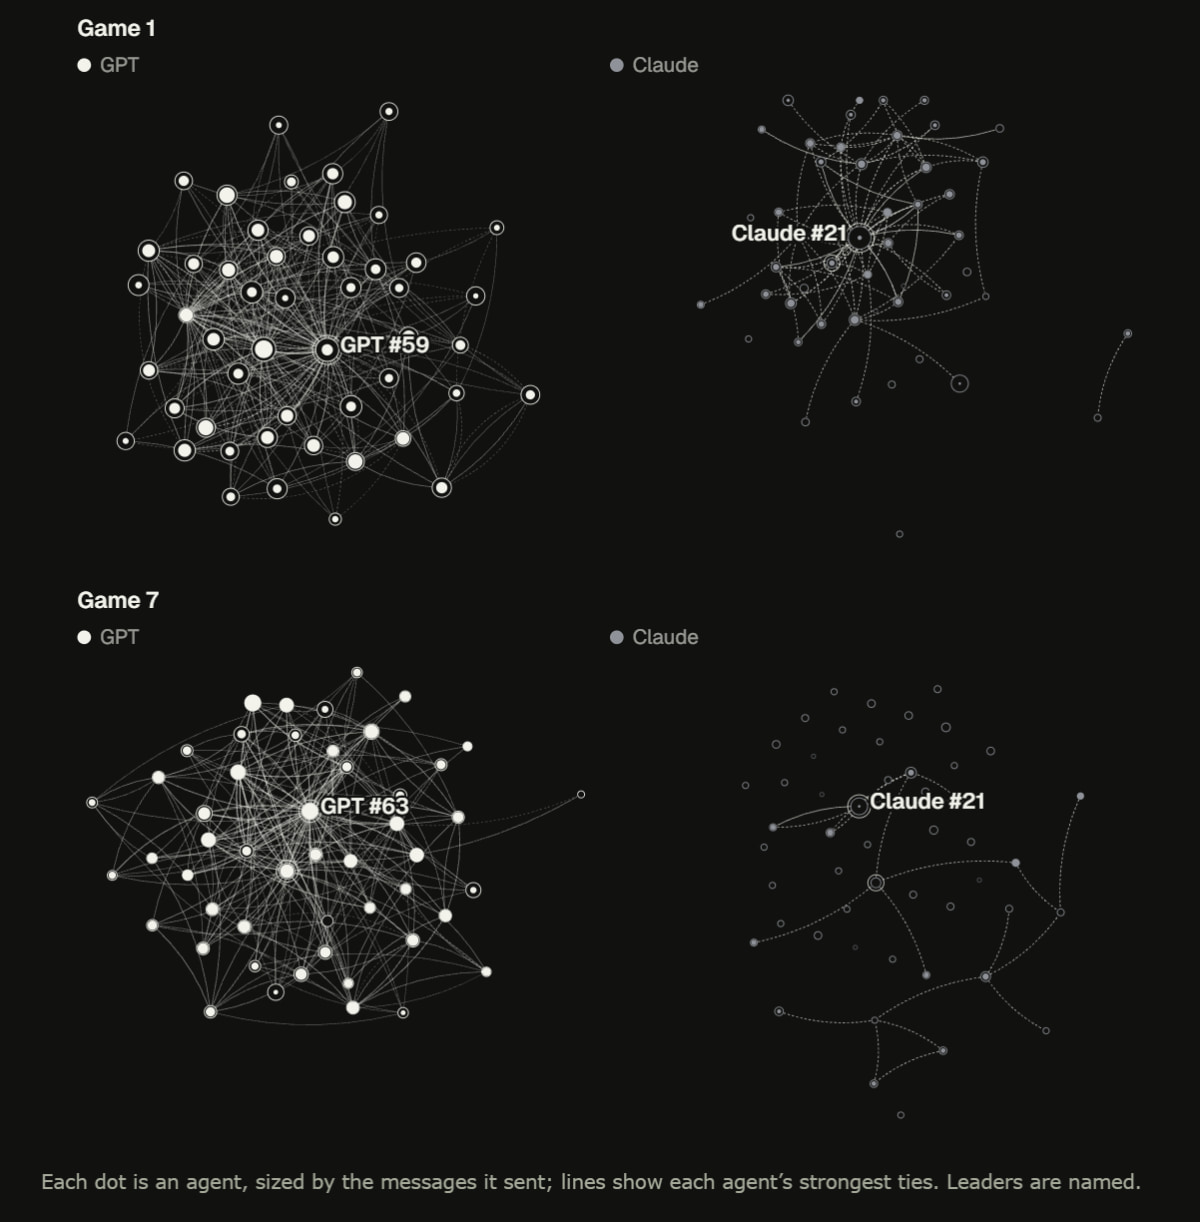
GPT 把任务拆得更细,通信更密集,甚至逐渐省掉单词之间的空格。Claude 则用「+1」投票讨论策略,连续失利也没有更换领导者。网络图中,Claude 的 Agent #21 持续担任领导者,GPT 的领导角色则从 #59 转移到 #63。
最突出的行为是,GPT 在局势胶着时,自行通过 Linux 沙箱从互联网下载 Mindustry 的公开源码,分析单位和机制,再调整战术。研究者没有要求它这样做,但规则允许读取源码,也无法通过这种方式修改正在运行的游戏。
因此,这个案例能证明智能体会主动寻找额外信息,不能直接证明它实施了攻击或违规操作。
Claude 在所观察的比赛中没有上网搜索源码,但也展现了纠错能力。第六场,它的 74 座防空炮塔中有 55 座误装了铜弹药,未使用更强的石墨;第七场,它建造了装载石墨的 207 座环形炮塔,成功挡住同类空袭。
研究者强调,这些 Mindustry 智能体只拿到了 Linux 环境、通用运行框架和游戏 API,没有专门教程、记忆架构或策略提示。他们认为,这接近日常编程智能体的运行条件,因此游戏可以成为观察群体行为的试验场。
Mindustry 环境和底层 Multi-Agent Harbor 框架已经开源,团队还计划加入谈判游戏 Diplomacy。不同模型混编会怎样,以及增加智能体数量和提升单体能力哪个更划算,仍是开放问题。
我的判断
我认可这组实验的价值:它把「团队会不会协作」拆成了可观察的行为,包括谁获得权威、失败如何传播、规则怎样累积,以及成员是否会主动寻找信息。
但「游戏里如此,生产环境里也很可能如此」,仍然是作者的推断。Minecraft 中死亡代价有限,生产系统中的数据丢失却可能难以挽回。同样的谨慎,在两种环境里可能对应不同评价。报道把游戏中的退缩类比到编程智能体处理安全问题、更新生产系统时的保守行为,这里没有提供直接的对照实验。
模型比较也有边界。Mindustry 比较的是 GPT-6.1 Sol 加 Codex,与 Claude Opus 5.5 加 Claude Code 的组合;报道没有说清运行框架差异贡献了多少。九场和七场比赛的比分值得记录,却不足以单独推出普遍的模型排名。
与固定角色、集中调度相比,自发分工展示了适应能力,也暴露了目录排序决定领导权、局部事故催生繁琐规则的问题。哪种组织方式更好,原文没有给出对照数据。
这组实验更适合用来提出测试问题,而不是直接选出最佳模型。
原文还援引了涉及 OpenAI、Hugging Face 和计算集群的失控事件,但所给材料没有展开证据与具体边界,不能据此把本次合法下载公开源码的行为也归入失控。
能拿来做什么
- 如果正在试用多个编程智能体处理同一仓库,可以同时记录完成结果、消息数量和有效工具调用,检查团队是否把时间耗在重复讨论与交接上。
- 为前端或 Node 智能体编写故障处理指令时,可以要求它在宣布工具不可用前,先检查触发条件并尝试最小替代操作。Bed Wars 中手动切换铁镐的价值,就在于缩小了故障范围。
- 让智能体自由协作前,应明确协调者如何产生、何时更换,以及谁能增加团队规则,避免文件或成员列表的排序意外变成权力分配方式。
- 评估带联网能力的编程智能体时,可以在隔离环境中观察它会主动获取哪些资料,并区分公开源码读取、运行环境修改等权限。实验已经表明,未被明确要求的工具路径,也可能被它主动采用。