14 款模型实测 ObjectScript 编程能力
该基准用 140 道题评估代码生成、理解和修复,其中 93 道在真实 IRIS 实例上执行评分。整体准确率为 51.5% 至 85.1%,前九名统计区间重叠,相近表现的模型成本仍有明显差异。
AI 深度解读
通用编程榜单上的高分,能不能直接用来挑选 ObjectScript 和 InterSystems IRIS 开发助手?作者用 140 道手写题测试了 14 个模型,结论是:模型之间确实有差距,但前九名还不足以分出可靠的胜负。
这份评测更有用的地方,是把「代码能否运行」「解释是否正确」和「答对一道题要花多少钱」拆开来看。对于需要维护 IRIS 系统、接入 AI 编程工具的团队,它提供了一份选型参考,也展示了小样本排行榜应该怎么读。
代码能跑通,比解释听起来正确更有说服力
作者将 ObjectScript LLM Benchmark 定位为首个面向 ObjectScript 和 IRIS 平台的开放评测。原因很直接:SWE-bench、LiveCodeBench、Terminal-Bench 等既有评测主要取材于 Python、JavaScript 和 shell,没有覆盖 ObjectScript、IRIS SQL、Embedded Python 或 %CSP.REST。通用榜单无法直接证明模型在这些技术上的能力。
他们设计了 140 道手写题,覆盖代码生成、代码理解和缺陷修复。其中 93 道题交给真实 IRIS 实例评分:编译模型输出,执行代码,再将结果与预期字符串比较。剩余 47 道理解题,由遵循评分规则的 LLM 裁判评判。
两种评分方式回答的问题不同。执行评分检查程序能否通过指定用例,理解题评分则检查回答是否符合规则。前者减少了主观判断,但通过用例也只证明代码满足这些测试条件,不能自动扩展成生产质量保证。
参测模型包括 Claude 4.x/5、GPT-5 variants,以及三个自托管 Qwen3/DeepSeek 模型。所有模型使用各自可用的最高推理配置,temperature 设为 0,每题只生成一次,也就是只测 Pass@1。
这个设定适合观察首次作答表现,却没有测量多次尝试、运行后修正,或者代理反复调用工具后的成功率。作者也明确承认,推理模型在多次运行之间的波动没有被记录。
前九名分不清,任务类型和成本却能拉开差距
整体准确率从 0.515 到 0.851,前九名集中在 0.737 到 0.851。数字看起来存在高低,但它们的 bootstrap 95% 置信区间相互重叠。
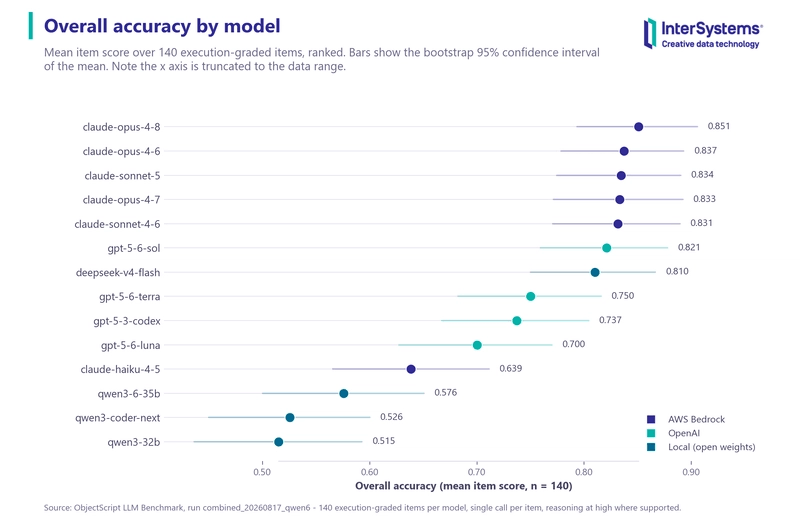
这份评测不足以可靠地区分前九名内部的高下。
作者在 n=140 的条件下,只能区分前九名这一组与后五名。这里的置信区间,可以理解为有限题目带来的成绩不确定范围;它提醒读者,不能把一次测试的名次当成稳定实力顺序。
按任务拆开,信息量更大。代码生成最难,最高准确率只有 0.745,模型之间的极差达到 0.511;缺陷修复最难拉开差距,极差为 0.196。
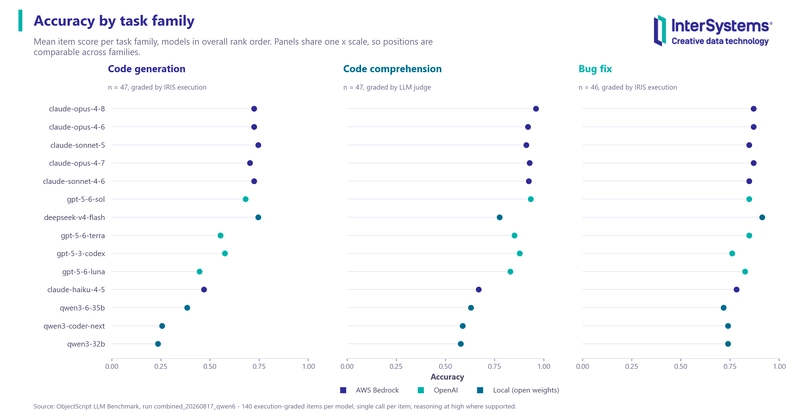
所有模型的理解分都高于生成分,差距约为 0.03 到 0.25。不过,这不能全部归因于「看懂容易、写对困难」,因为两类题采用不同评分机制。
DeepSeek-v4-flash 就说明了总分可能遮住什么:这个自托管模型在代码生成上以 0.745 并列第一,缺陷修复以 0.913 领先,整体却排第七。它的理解分为 0.774,低于头部 Claude 模型的 0.91–0.96。考虑到理解题另用 LLM 裁判,这组跨任务比较需要保留疑问。
成本差异也比总分排名更值得看。准确率超过 0.80 的模型中,claude-sonnet-5 每获得 1,000 个正确答案的成本为 $4.61,gpt-5-6-sol 则为 $17.54。
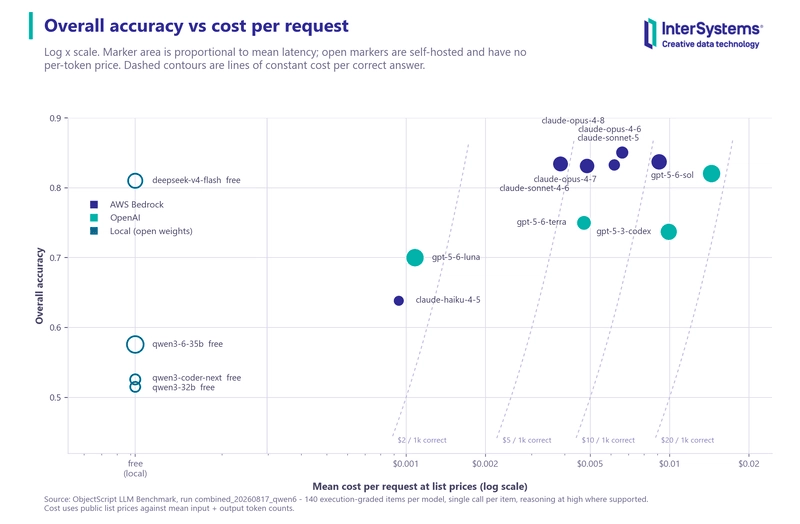
有价格数据的 10 个模型,单次请求成本为 $0.0009–$0.0144,作者概括为约 15×;按准确率折算后,差距缩小到 12×,模型顺序也发生变化。因此,只比较请求单价不够,还要看这些请求能产生多少正确结果。
但这仍是该题集、该推理配置下的成本,原文没有给出将其直接外推到团队真实工作负载的依据。
我的判断
我认可它优先执行代码的做法。相比只让模型解释代码,真实编译和运行更接近开发者关心的交付结果;相比通用编程榜单,专门覆盖 ObjectScript 的题集也更贴近 IRIS 团队的需求。
不过,执行结果属于实测证据,「哪个模型更适合你的团队」仍需要进一步验证。
首先,140 道题的规模有限,作者已经明确给出了排名不确定性。其次,理解题由固定版本 claude-opus-4-8 评分,而它自己又取得最高理解分 0.960。这构成潜在的自我偏好风险,但不能据此断言存在偏袒;93 道执行评分题不受这一裁判问题影响。
覆盖范围也有限:没有 Interoperability,包括 productions、HL7、DTL;没有大上下文任务,也没有纯 SQL 工作。需要在大型仓库里理解调用关系、维护接口或处理互操作流程的团队,不能把这份成绩当成完整能力证明。
题目在测试时尚未公开,降低了当时直接接触题目的可能性;公开之后,后续评测就会面临题目进入训练数据的污染风险。
我会把它当作候选模型筛选依据,而不是采购结论。
它提供了可检查的实测结果,但没有证明哪种模型能在一般团队中稳定减少多少开发时间,也没有测量人工复核成本。那些收益,不能替作者补上。
能拿来做什么
- 如果团队维护 ObjectScript 或 IRIS 项目,可以先从领先组筛选候选模型,再用自己的代码生成和修复任务验证,避免只凭整体名次做决定。
- 如果日常 AI 编程主要用于生成代码,应优先看生成分和真实执行结果。对接
%CSP.REST、Embedded Python 或 IRIS SQL 时,也要分别检查自己的具体用法是否被覆盖。 - 做成本评估时,可以记录请求费用、通过任务数和人工修改量。原文的「每 1,000 个正确答案成本」提供了起点,真实预算还需要补上复核与返工。
- 如果准备复用公开题集,应另外保留一组内部题,并重复运行部分任务,以检查公开题污染风险和单次作答波动。