英伟达开放连续扩散语言模型 Sigma
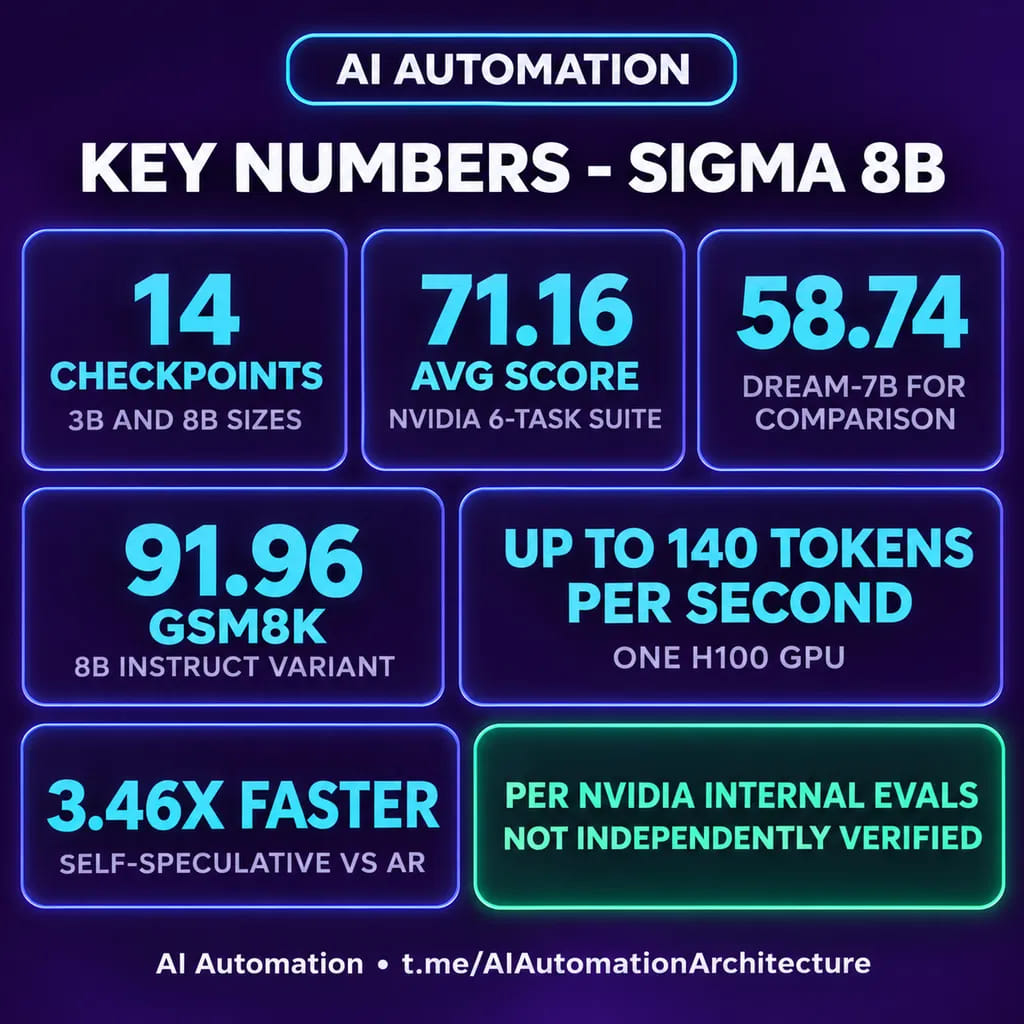
据材料,Nemotron-Labs-Sigma 提供 3B、8B 两种规模共 14 个检查点,包含基础、指令及少步蒸馏版本,许可证允许商用。模型在学习得到的嵌入空间中去噪,以每块 64 个 token 的方式生成文本。
AI 深度解读
NVIDIA 发布的 Nemotron-Labs-Sigma,尝试让语言模型按块生成文本:每块先经过多轮去噪,再输出 64 个 token。它开放了 3B、8B 两种规模的权重,希望在生成质量和推理速度之间找到另一种选择。
对程序员来说,重点是这种路线能否降低自部署推理的等待时间。原文给出的成绩有吸引力,但全部来自 NVIDIA 内部评测,而且依赖特定硬件和推理框架,不能直接套到自己的服务上。
连续扩散怎样生成文字
2026 年 11 月 20 日发布的这组模型,共有 14 个检查点,涵盖 base、instruct、少步蒸馏版本,以及每种规模各一个自推测版本。蒸馏版本提供 NFE 2、4、8、16 四档配置;NFE 通常指函数评估次数,可以先理解为生成过程需要调用模型计算的次数。
熟悉的自回归模型从左到右,逐个生成 token。LLaDA、Dream 这类离散扩散模型,则在离散 token ID 上做扩散。Sigma 选择了另一条路径:在学习得到的 16 维嵌入空间里,对 token 表示进行去噪。
可以把它理解为先准备一块尚不清晰的文本表示,再经过几轮修正,得到可以输出的文字。每块包含 64 个 token,当前块完成后,才进入下一块。因此,它能够在块内并行处理,但并不是整篇回答一次生成。
训练也没有从零开始。模型先继承一个经过约 1 万亿 token 训练的自回归检查点,再继续进行约 0.3 万亿 token 的扩散训练。它的能力既来自扩散阶段,也建立在已有自回归训练的基础上。
成绩和提速,分别能证明什么
NVIDIA 的内部六任务评测中,Sigma-8B base 平均分为 71.16。其他模型分别是 NLD-8B 的 70.22、Dream-7B 的 58.74、LLaDA-8B 的 41.78,以及自回归模型 Qwen3-8B 的 68.91。
这些数字支持一个有限的结论:在这套评测里,连续扩散路线取得了有竞争力的结果。它们不能证明 Sigma 在所有任务上都更强,原文也没有展开六项任务的组成和完整测试条件。
8B instruct 在 GSM8K 上达到 91.96,但 AIME25 只有 17.00。两者之间的落差提醒我们,常规数学题表现不错,不代表竞赛数学推理同样可靠。
速度则有两组不同口径:
- 单张 H100、bfloat16 精度下,NVIDIA 报告约 120–140 tokens/s。
- 在 GB200 上使用 SGLang,自推测 8B 版本相对原文所称的自回归平均基线,解码加速最高达到 3.46 倍,峰值为 4.20 倍。
这些成绩全部来自 NVIDIA 自报,尚未获得独立验证。
原文没有交代速度测试的完整并发、输入输出长度和基线组成,也没有提供首 token 延迟。对于聊天界面,持续生成速度与用户多久看到第一段内容,是两个需要分别测量的问题。
开放权重,适合哪些部署条件
权重发布在 Hugging Face,采用允许商业使用的 NVIDIA Nemotron Open Model License。团队可以下载、微调,并在自己的环境中部署;具体使用仍需遵守许可证条款。
NVIDIA 没有提供第一方托管 API。原文列出的运行方式包括 vLLM、SGLang 和 Docker Model Runner,因此它更贴近已经管理 GPU 和推理服务的团队。
上下文窗口也需要提前核对:一般版本为 4,096 tokens,8B instruct 扩展到 8,192 tokens。对于需要塞入大量代码、日志和历史对话的 AI 编程应用,这会直接限制一次请求能够携带的材料。
原文还认为,蒸馏版本能通过计算步骤的取舍减少网络往返。不过,它没有说明这里的「网络往返」具体指哪一层。模型内部调用次数如何转化成服务端时延收益,需要结合部署架构验证。
我的判断
Sigma 值得关注的地方,是展示了连续扩散语言模型在开放权重、自部署场景中的可行性。它提供了多个计算档位,方便团队探索质量与速度之间的取舍。
但「生成更快」还不足以支持替换现有模型。相对成熟的自回归服务,团队还要比较同等质量下的延迟、吞吐、显存占用和部署成本。原文没有给出完整对照,关于低延迟部署价值的判断,目前只能当作厂商评测和部署设想。
对国内前端、全栈读者,这也不是一份编程能力推荐。原文没有提供代码生成、工具调用或仓库修改评测,不能根据数学分数推断它适合做 coding agent。
能拿来做什么
- 已经自部署模型的团队,可以用真实业务请求对比现有自回归模型,固定硬件、并发和输出长度,同时记录回答质量、首 token 延迟与总耗时。
- 做聊天前端或 Node 推理网关时,可以检查按块生成经过服务层后如何交付,确认流式响应的间隔,以及取消请求时的实际行为。
- 准备接入 AI 编程工作流时,先用实际代码任务验证能力,再核对 4,096 或 8,192 tokens 是否装得下必要上下文,不要仅凭 tokens/s 决定替换。