英伟达开源 GPU 集群管理平面,预览版限制明确
NVKE 可在裸金属上为不同客户创建独立 Kubernetes 集群,结合 Temporal、SPIFFE/SPIRE 和硬件身份验证完成部署。预览版尚无管理平面升级及备份恢复流程,且默认缺少 TLS、启用的认证和授权控制。
AI 深度解读
NVKE 想把裸金属 GPU 集群的交付做成一条自动流水线:运营方提交请求,系统负责准备机器、安装 Kubernetes,再把独立集群交给客户。它来自 NVIDIA,以 Apache 2.0 开源,但仍处于预览阶段。
原文最有价值的部分,是把这条流水线的边界讲清了:集群能自动创建,不代表服务已经具备可交付的安全和运维能力。API 授权、管理面恢复、客户凭据和节点替换,仍有不少工作需要运营方补齐。对程序员来说,这也是一个观察异步任务设计与基础设施产品边界的具体案例。
独立集群能交付,管理集群由谁照顾
NVKE 是管理平面(management plane),服务对象是经营 GPU 基础设施的运营方。每个客户的工作负载集群都有自己的 Kubernetes 控制平面、etcd 和节点池,运营方统一维护负责创建它们的管理集群。
安装从 nvkectl 开始。它先借助一个临时种子集群搭建管理集群,再将管理平面安装上去。此后,运营方通过 NVKE API 或 nvkectl 请求创建集群,由系统编排节点供应、集群初始化及后续生命周期操作。
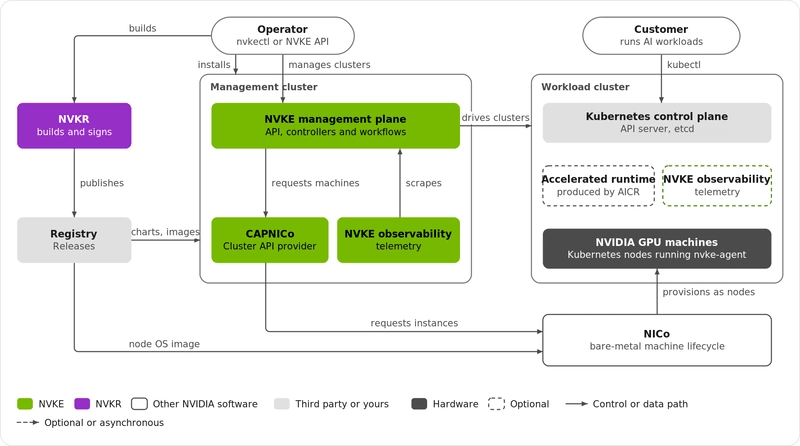
机器供应依赖 NVIDIA Infra Controller,简称 NICo。预览阶段,NICo 是唯一兼容的基础设施提供方;部署启用后还支持 LaunchLayer。管理面通过 Cluster API 的 NICo provider,也就是 CAPNICo,对接机器发现、固件、网络和主机供应。
网络使用 OVN-Kubernetes。GPU 软件栈则由 AICR recipe bundle 接手,把 GPU Operator、驱动、内核配置与 Kubernetes 锁定成版本组合,生成 GitOps bundles。NVKR 负责构建机器供应与集群管理所用的产物。
这套分工能减少逐台装机的重复劳动,但依赖链也很明确:创建租户集群、增删节点和升级都要经过 NICo。软件物料清单会通过一次 GitOps 部署,将 controller、NICo、Temporal、Postgres、SPIRE 和 CAPNICo 放进管理集群,管理集群故障会阻断供应流程。
更大的缺口在管理集群自身。它不会升级、扩缩容或替换自己的节点,预览版也没有提供管理平面的版本升级流程,以及管理集群和状态的备份恢复流程。
能管理客户集群,不等于能维护管理系统自身。
一次创建请求,怎样避免入库成功却没有任务
NVKE 的工程细节里,最值得应用开发者借鉴的是数据库发件箱(transactional outbox)。
项目采用 Go workspace,共 13 个模块,其中 3 个运行于生产环境:以 Helm chart 部署的 controller、以 Debian package 安装并由 systemd 运行的节点 agent,以及部署在 controller 旁边的 Cluster API infrastructure provider。
一个 controller 进程同时承载 REST API、Temporal worker 和 Kubernetes reconcilers。创建请求进入 /api/clusters 后,处理器在同一个 PostgreSQL 事务里写入集群记录和 workflow_outbox 表。
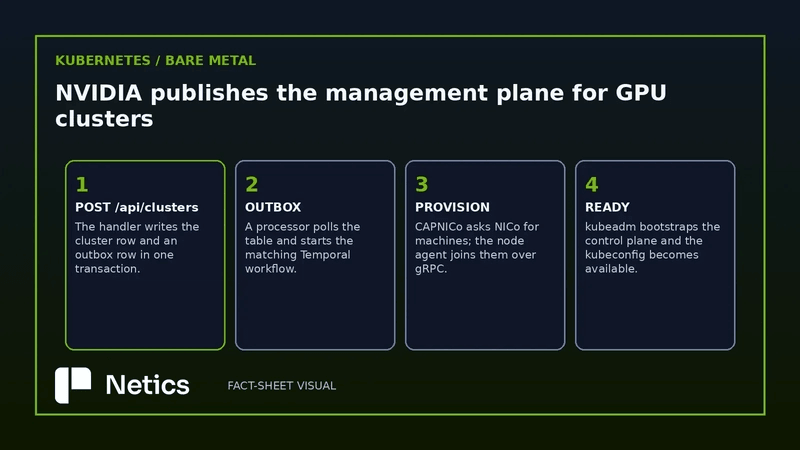
它解决的是常见的双写问题:如果先写数据库,再调用任务系统,中途崩溃就可能留下一个永远没人处理的集群记录。把业务记录和待执行任务一起提交,可以保证已提交的集群记录有对应任务。
随后,处理器轮询 outbox,启动对应的 Temporal workflow,再将该行标记为已处理。工作流创建 Cluster API 资源,由基础设施 provider 供应或接管节点,controller 再通过 gRPC 调用 nvke-agent,推动集群进入 Ready。
节点 agent 只监听请求,由 controller 主动连接。它运行 kubeadm init、kubeadm join,安装 CNI、初始化 kubelet,并处理 drain、重启与拆除。节点通过 SPIFFE/SPIRE,结合 TPM 或 join token 证明身份。
这个设计说明了任务如何可靠进入执行链,却不能单凭描述就认定所有步骤只执行一次。原文没有展开重复启动、重试和幂等处理的细节,也没有给出吞吐量或故障恢复实测。对 Node 后端开发者,这是一种可借鉴的一致性设计,不是一份完整的可靠性证明。
默认配置离多租户服务还差哪些环节
原文引用的文档与配图时间为 2026 年 11 月 9 日,讨论的是当时的预览状态。限制页比功能介绍更值得先读。
NVKE API 在每个管理节点的 30080 端口提供明文 HTTP,安装后默认关闭认证,而且完全不执行授权。进入允许网络的调用方可以访问所有端点;即使加上认证,持有 token 也不代表权限已按客户划分。
认证回答「你是谁」,授权回答「你能删除哪个客户的集群」。运营方需要在 API 前面补 TLS 和授权层。
租户集群的凭据还有另一层限制:客户拿到的是 admin kubeconfig,enableOidc 不会自动把客户的身份提供方接入工作负载集群。由于 NVKE 不轮换集群 CA,已经交出的管理员 kubeconfig 无法通过 NVKE 撤销。
节点池也不是修改配置就会自动收敛。配置变化后,运行中的节点只会被标记 condition,不会自动 drain 或删除;labels 和 taints 在创建时确定,仅在节点加入时应用。nvkectl 只升级控制平面,节点池的 Kubernetes 版本需要通过原始 API 调用修改。
NVSentinel 可以监测硬件故障,在修复前执行考虑工作负载的 cordon、drain,再调用 NVKE lifecycle APIs 触发节点替换。但清理过时节点、QCOW2 供应所需的 imager 与脚本,仍要由运营方准备。
加密同样需要分层看。NVKE 支持按集群启用 etcd 静态加密;托管流水线构建的全盘加密节点镜像则使用 LUKS2,每次镜像构建生成一个卷密钥,所有从该镜像创建的节点共享它。持有原始镜像和文档中 bootstrap passphrase 的人,可以恢复这个密钥。文档明确将此类镜像限定为评估用途。
默认遥测管道 NKTP 只在内存保存数据,还允许匿名用户以管理员身份访问 Grafana。它适合演示的默认值,不能直接承担持久监控需求。
我的判断
NVKE 说得对的一点,是把集群工厂拆成了可追踪的执行链,并公开了预览版的缺口。对于已有裸金属 Kubernetes 运维体系的团队,机器供应、身份校验和集群编排能够形成一条可继续建设的路径。
它的前提也很重:团队已经能运行 NICo,并愿意维护 Kubernetes、Temporal、PostgreSQL、SPIRE 和物理服务器。一般业务团队如果只是需要运行 GPU 工作负载,接入这套管理面是否划算,原文没有提供答案。
独立控制平面、etcd 和节点池提供了明确的集群边界,但原文没有给出它与共享集群加 namespace 方案在成本、隔离效果、交付速度上的对照数据。作者整理的是架构与限制文档,没有展示压测或恢复演练,因此对运维收益的判断仍属于经验分析。
还有一个建议需要打问号:作者提出把 admin kubeconfig 当作会过期的应急凭据,但前文同时指出它无法撤销。原文没有说明过期机制如何实现,不能据此认为 NVKE 已提供短期管理员凭据能力。更稳妥的方向是另行建立客户 OIDC 访问与集群内权限体系,再明确管理员凭据的保管方式。
恢复能力也不能靠「保存文件」替代。bootstrap kubeconfig 和 etcd 加密密钥文件必须安全保存,后者是唯一不在节点上的副本;管理节点 bootstrap 还需要运营方自己的 SPIRE CA 文件,否则会回退到自签名 CA,导致节点无法完成证明和加入。
保存恢复材料只是起点,恢复流程能实际跑通才算具备恢复能力。
能拿来做什么
- 给 Node 服务设计长时间异步操作时,可以借鉴
/api/clusters的 outbox 路径,把业务记录与任务记录放进同一事务,同时补上重试、幂等和任务状态查询。 - 评估 NVKE 时,先把限制页转成试点验收项,实际验证 API 授权、管理面恢复、凭据管理和节点替换,别只验证集群能否进入 Ready。
- 接入集群管理 API 的前端应区分请求已受理、集群 Ready 和仍需人工处理的节点 condition,避免把一次成功响应展示成整个流程已经完成。
- 准备用它承载客户数据时,应先重建或替换评估用加密镜像路径,配置可持久保存的遥测后端,并关闭 Grafana 匿名管理员入口。