NVIDIA 用企业语义层约束 Agent 数据查询
Auto Ontology 是从企业元数据构建本体与知识图谱的 Python 开源库,可协调跨系统的指标和实体定义。它通过 MCP、CLI 和 API 提供语义上下文,并支持依据认证定义与数据血缘校验生成查询。
AI 深度解读
让 Agent 查出一个营收数字不难,难的是确认它算的究竟是哪种营收、关联了哪些表、有没有拿错口径。NVIDIA Auto Ontology 想补上这层业务上下文:从数据库元数据生成语义模型,经人工确认后,再交给 Agent 查询。
它值得关注的地方,是把「生成 SQL」放进了一个更完整的流程:先解释数据,再确认能不能回答,最后返回结果和依据。不过,原文提供的是架构与样例,尚不足以证明它在真实企业数据上的准确率。
Agent 缺的业务上下文,具体长什么样
Auto Ontology 是一个开放库,定位是补充企业已有的语义模型。它试图回答六个问题:数据在哪里、代表什么、能否使用、如何使用、来自哪里,以及哪些内容相似。
承载这些信息的是本体(ontology)。这里可以把它理解成一份可供程序检索的业务字典,除了解释名词,还记录计算方法和表之间的关系。
它包含三类定义:
- Terms 描述 Customer、Invoice Line 等业务概念,带有说明、同义词和对应列。
- SQL attributes 保存经过审核的 SQL 表达式,例如利润率、滚动累计值,让 Agent 重复使用同一套算法。
- Relationships 描述表的连接方式,包括经过桥接表的关联。
相比只把数据库 schema 塞进提示词,这一层多了业务口径。字段名可以告诉模型「这里有金额」,却未必能说明这笔金额是否含税、是否扣除退款。
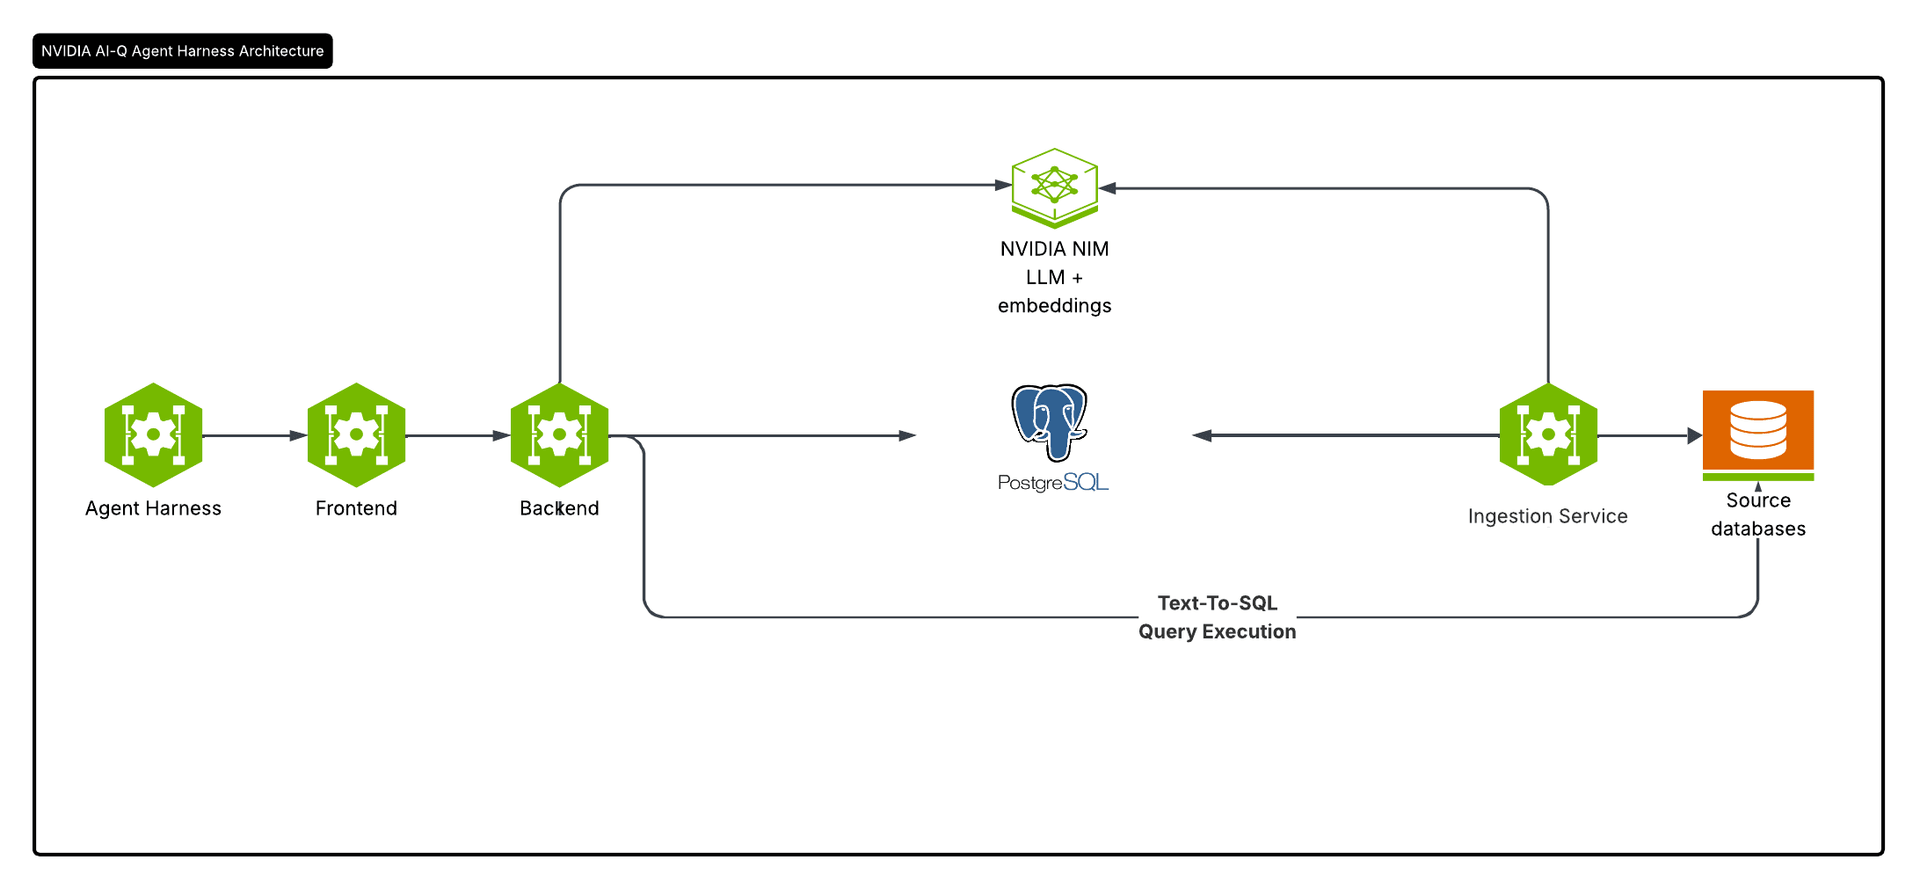
生成过程会读取 schema、分析列、采样数据,再逐表提取术语、推断关联,并从查询历史建议 SQL attributes。结果存入 Postgres,向量存入 pgvector,供后续检索。
原文展示的一次 Wide World Importers 编译生成了 31 个术语。这个数字说明样例能产出可浏览的语义图,并不代表生产数据库的覆盖能力。
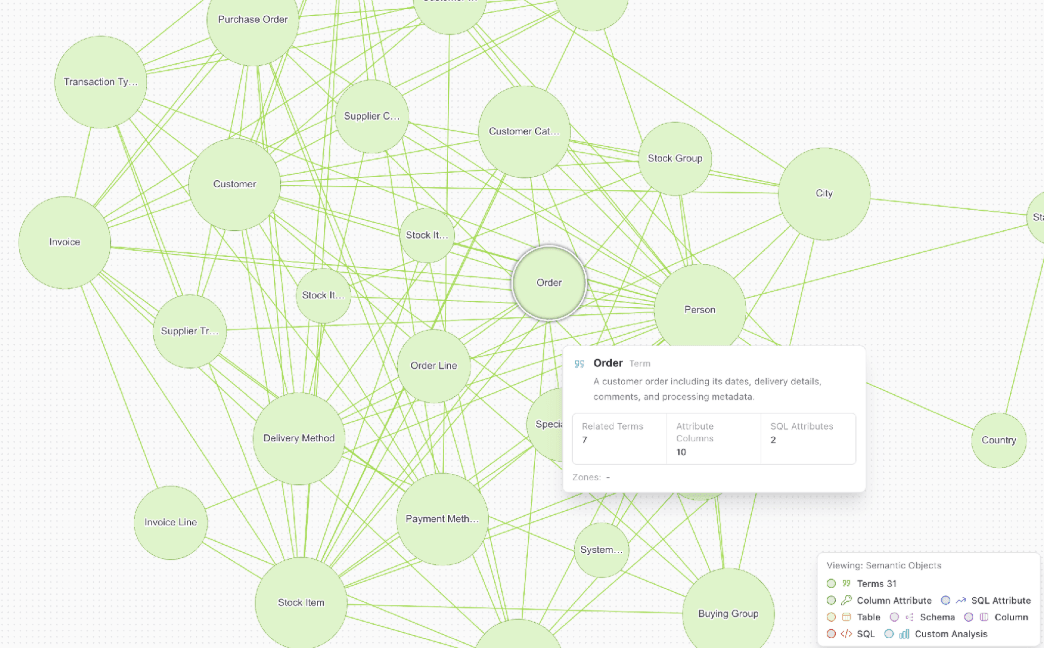
自动生成的是草稿,可信度仍要靠人确认。
团队需要用真实问题测试,在 UI 或 API 中修改术语、描述和 SQL attributes,再进行认证。项目还提出把经过认证的修正和使用情况反馈到本体,但原文没有展开自动学习的边界。
怎样判断一个数字有依据,或者根本答不了
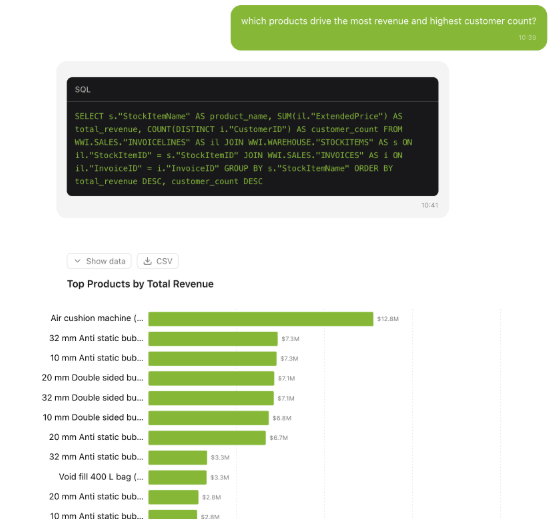
收到问题后,Agent 会识别意图和实体,通过向量检索寻找候选术语、列和计算表达式,再生成 SQL。随后检查筛选值和查询,检查失败时修复,执行后返回答案、SQL 和处理步骤。
原文的例子是:查询 2015 年 6 月 Pennsylvania 地区,一款寿司卷造型 U 盘的营收。样例答案为 $588.80,来自 3 条发票明细。
下面这段原始输出展示了它怎样把业务问题落到关联路径上:
Answer:  Revenue for USB food flash drive - sushi roll in Pennsylvania in
         June 2015 was $588.80, from 3 invoice lines.

SQL:     SELECT SUM(il.extendedprice) AS revenue, COUNT(*) AS invoice_lines
         FROM sales.invoicelines il
         JOIN sales.invoices i             ON il.invoiceid = i.invoiceid
         JOIN warehouse.stockitems si      ON il.stockitemid = si.stockitemid
         JOIN sales.customers c            ON i.customerid = c.customerid
         JOIN application.cities ct        ON c.deliverycityid = ct.cityid
         JOIN application.stateprovinces sp ON ct.stateprovinceid = sp.stateprovinceid
         WHERE si.stockitemname = 'USB food flash drive - sushi roll'
           AND sp.stateprovincename = 'Pennsylvania'
           AND i.invoicedate >= '2015-06-01' AND i.invoicedate < '2015-07-01'

Steps:   Resolved terms: Invoice Line (revenue), Stock Item, State Province, Invoice
         Joined: invoice line -> invoice -> customer -> city -> state province
         Validated the filter values against the data, then executed
要看的是 SUM(il.extendedprice) 和 c.deliverycityid 两行:前者决定营收算法,后者说明地区取自客户配送城市。SQL 可以运行,还需要业务人员确认这两个选择符合问题口径。
另一个例子更有价值。用户询问广告投入回报时,样例数据库没有广告支出数据。通过 MCP 接入的 Agent 先调用 check_answerable,得到 coverage 0.5,发现没有术语覆盖 ad spend,于是说明无法计算,并询问是否改查营收或接入其他来源。
可靠的数据问答,需要把「现有数据答不了」当作正常结果。
不过,coverage 0.5 的计算方式和判定阈值没有说明,不能把它当成答案有 50% 的正确概率。原文提到可以通过独立评估仓库运行 BIRD 等 text-to-SQL 基准,但没有给出准确率、延迟或对照结果。
接进现有应用,有哪些配置不能漏
项目支持 Docker Compose 本地部署,也提供 Kubernetes Helm chart。Web UI 包含聊天、分析、数据目录和设置,认证与 RBAC 使用 Better Auth。
模型默认走 NVIDIA NIM,可使用托管端点 integrate.api.nvidia.com 或自托管服务。默认配置为:
- LLM:
nvidia/nemotron-3.5-lightning-30b-a3b。 - Embeddings:
nvidia/nemotron-3-embed-1b。 - Reranking:
nvidia/llama-nemotron-rerank-vl-1b-v2。
原文说共有四种模型角色,但提供的内容没有完整列出。每种角色通过 <PREFIX>_ENDPOINT、<PREFIX>_API_KEY、<PREFIX>_MODEL 配置;缺失字段分别回退到 DEFAULT_MODELS_<FIELD>,密钥还兼容旧的 NVIDIA_API_KEY。
这里容易踩坑:.env.example 中各角色的 nvapi-your-api-key-here 是已填写的占位值,需要替换或删除,才能正确使用默认密钥。接入其他 OpenAI-compatible endpoint 时,还要求模型支持结构化输出,且入库和查询使用同一个 embedding 模型。
本地样例需要 Docker Compose v2、uv 和 nvapi-... 密钥。先用 docker compose up -d --wait postgres 启动数据库,再通过评估仓库的 scripts/seed/seed_wwi.py 导入数据;其中 --database-name wideworldimporters --drop 带有删除重建行为。最后运行 docker compose up -d --build,登录后开启 Settings → Semantic Compilation,等待 Semantic compilation is ready。
对前端或 Node 应用,直接调用 POST /api/chat/completions 就能接入问答。API token 在用户菜单的 API Tokens 中创建:
curl -N http://localhost:3000/api/chat/completions \
  -H "x-api-key: $AUTO_ONTOLOGY_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"question": "How many orders shipped last week?"}'
注意 -N:响应是服务端事件流(SSE),需要持续读取。result 事件携带答案,data: [DONE] 表示结束,不能直接按普通 JSON 响应处理。
现有 Agent 则可以使用 MCP 的只读本体工具,每次调用按登录用户权限执行。已有语义资产也可通过 Apache Ossie 转换成 Ossie YAML,使用 POST /api/model/import、POST /api/model/export 交换定义。
部署边界必须一起看。客户端走 3000 端口;3001、3002 应留在私网。FastAPI 信任前端转发的 x-auto-ontology-user-id,而 ingestion 服务的 ingest、delete、reset、compile 端点没有独立认证。
预测功能另走 KumoRFM。设置 KUMO_RFM_API_KEY 后,Agent 会上传连接的表;KUMO_MAX_TABLES 默认 20,KUMO_MAX_ROWS_PER_TABLE 默认不限行数。这一步需要先确认组织允许发送哪些数据。
我的判断
我认同它把业务定义、人工认证和查询溯源放在一起。对跨系统、跨团队的数据问答,反复调提示词解决不了「同一个词有不同算法」的问题。把定义沉淀为共享资产,更方便检查和维护。
但这是一条有维护成本的路线。相比直接提供 schema,它增加了术语审核、关系校验和口径更新;相比已有 BI 语义层,它是否减少重复维护,要看导入后的语义保真程度,原文没有给出证据。
返回 SQL 能提高可检查性,却不能自动证明结果正确。关联重复、地区归属或指标定义有误,都可能得到一条执行成功的查询。原文展示了流程能力,没有提供与普通 text-to-SQL、schema 提示或其他语义层的对照数据,效果判断仍属于方案主张。
项目采用 Apache License 2.0,但目前不接受外部 PR,集成请求和问题报告可以提交 issue。计划深度改造的团队,也要考虑自行维护的成本。
能拿来做什么
- 如果正在做内部数据问答,可以先选一个营收或订单场景,整理术语、计算表达式和关联路径,再评估自动生成是否减少了人工工作。
- 给 Agent 准备两类验收问题:一类有已知正确答案,另一类缺少必要数据;同时检查计算口径和拒答行为。
- 前端或 Node 接入 SSE 时,把答案、SQL、处理步骤和错误状态分别展示,让用户有机会核查数字来源。
- 试用时先关闭预测上传,替换
.env默认密码,并把 3001、3002 放在私网,再开放聊天入口。