给模型限定任务,工作流也能做好助手
作者以自建 WhatsApp 助手为例,对比代码控制步骤的工作流与模型自主决策的 Agent。通过限定模型职责并用代码校验结果,让系统行为更容易检查。
AI 深度解读
给 AI 接上工具,就一定要让它自己规划步骤吗?作者拿自己的 WhatsApp 助手做了一组小实验:同样的聊天记录、同样的模型和证据校验,固定工作流找到了两条承诺,agent 却因为提前结束而全部漏掉。
这篇最有价值的地方,是把「谁决定下一步」拆开来看:当业务已经知道处理顺序时,把选择权交给模型,可能增加请求、等待和排查成本。但三次合成数据实验,也远不足以证明工作流普遍优于 agent。
先确定步骤该由谁决定
作者引用 Anthropic 在 2024 年 12 月发布的指南,区分了两种组织方式:工作流由代码规定路径,模型和工具沿着路径执行;agent 则由模型决定下一步,以及调用哪些工具。
单次模型调用、检索后生成、工作流、单个 agent、多个 agent,并不是必须逐级升级的路线。前三种主要由代码安排步骤,后两种把更多决定交给模型。
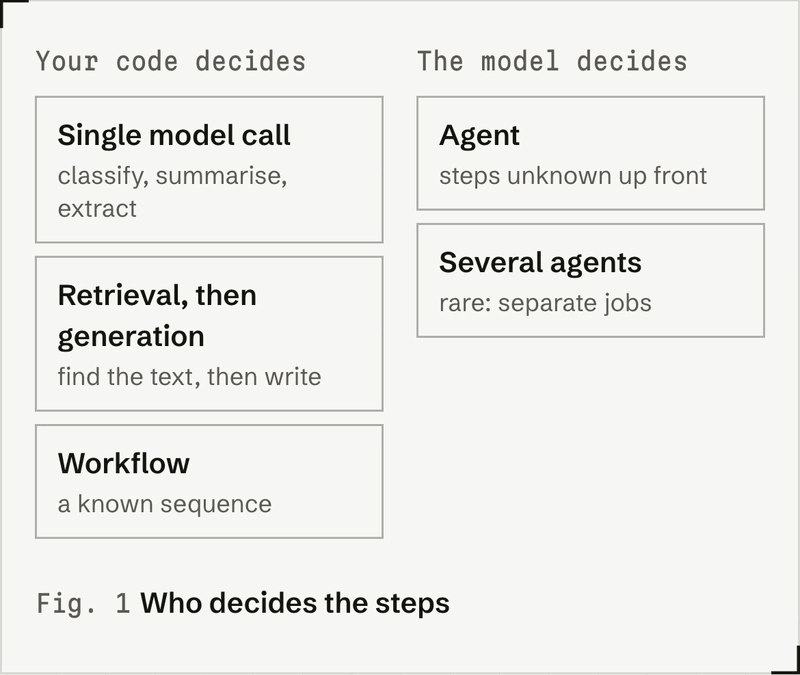
作者的 Message Yourself OS 要回答两个问题:谁在等自己回复,以及自己答应过什么。这项任务的处理顺序已经比较明确:筛选聊天、理解消息、核验证据、展示结果。
因此,模型只负责理解入选消息。它不决定打开哪个聊天,也不决定什么时候看够了。
步骤已知时,先让代码安排流程,再把需要理解语义的部分交给模型。
一次模型调用之前,代码已经做了哪些事
作者在本机索引全部聊天,再根据未读消息、谁最后发言、消息是否以问号结尾、自己是否写过「I'll」或「I will」、当天活跃情况等信号打分。静音聊天和安静的群聊会被扣分。
候选门槛是 12 分,最多选 50 个聊天,输入预算为 40,000 token。入选内容通过一次模型调用,提取待回复事项和承诺,每条都必须附上原文引句。代码随后核对引句及发送者,!today 将通过检查的结果放入 Focus,其余标记为待核实。
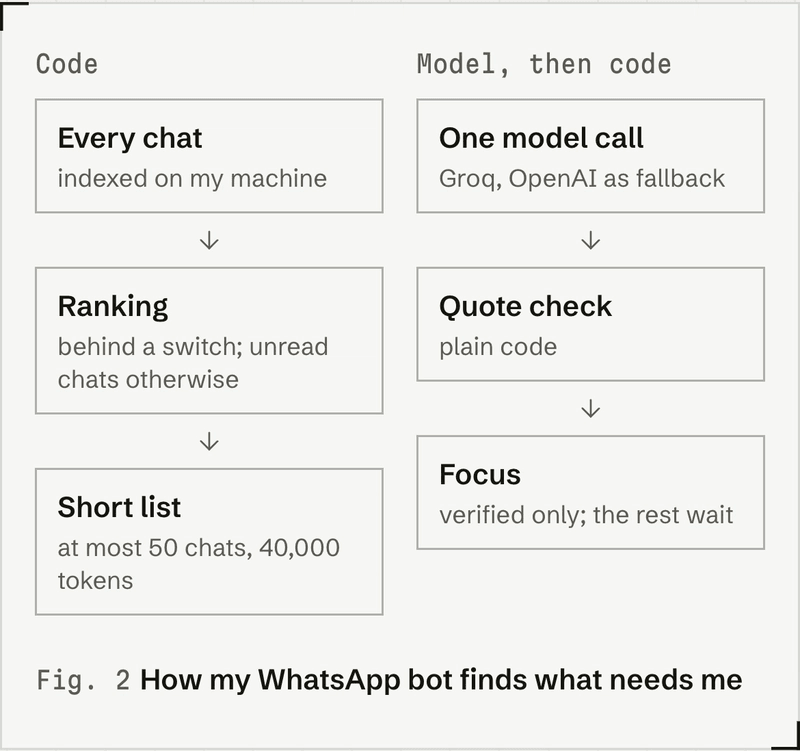
这里有一个上线前提:按分数排序的模式仍受开关控制,必须经过 7 个真实使用日的人工审核才能通过门槛。在此之前,助手使用未读聊天。原文展示的是正在测试的排序方案,并非已经默认启用的成熟功能。
公开演示用下面这段代码串起流程,解决「候选选择、模型提取、结果校验」的衔接:
const ranked = pickCandidates(chats, today);
const reply = await model.generate({
  system,
  turns: [{ role: "user", text: prompt }],
  jsonSchema: findingSchema,
});
const findings = verifyFindings(parseFindings(reply.text), chats);
要留意最后一行:jsonSchema 约束输出结构,verifyFindings 才负责核对证据。格式正确和内容可信是两件事。
本地索引也不等于消息完全留在本地。进入候选集的聊天仍会发送给模型提供商。作者称,机器人此前一直使用 Gemini 免费配额,直到 2026 年 11 月;考虑到免费服务条款允许内容用于产品改进、可能接受人工审阅,作者将默认提供商改为 Groq,保留 OpenAI 作为回退。
按原文所述,Groq 默认不保留推理输入输出,但在可靠性或滥用调查中可能保留最多 30 天的日志;作者账户开启了 Zero Data Retention。回退链仍需逐家检查,不能只看默认提供商。公开演示使用的则全部是虚构聊天。
agent 漏掉承诺,是因为根本没有读到
演示包含 12 个虚构聊天。工作流按规则选中其中 7 个,一次提交给模型;agent 获得 list_chats、read_chat、finish 三个工具,自行选择阅读顺序,最多执行 15 步。
下面的循环让模型决定继续读取还是结束:
for (let step = 1; step <= maxSteps; step++) {
  const reply = await model.generate({ system, turns, tools: agentTools });
  const finish = reply.toolCalls.find((call) => call.name === "finish");
  if (finish) return verifyFindings(finish.args.findings, chats);
  for (const call of reply.toolCalls) {
    turns.push({
      role: "tool",
      name: call.name,
      result: runTool(call.name, call.args, chats),
    });
  }
}
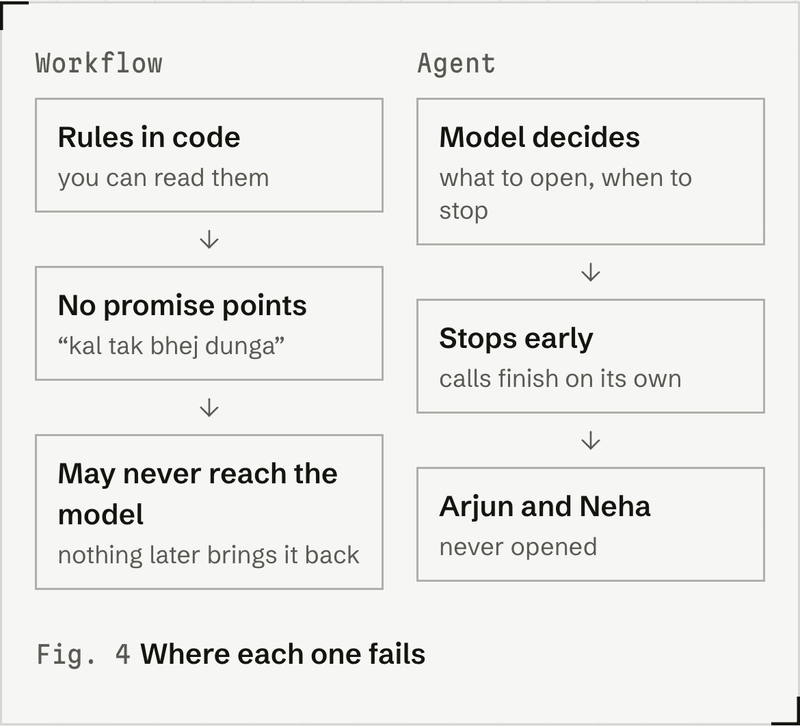
关键是 if (finish) 这一行:15 步只是上限,模型可以提前收工,并没有义务读完全部聊天。一次响应也可以包含多个工具调用,不能把工具调用数直接当成模型请求数。
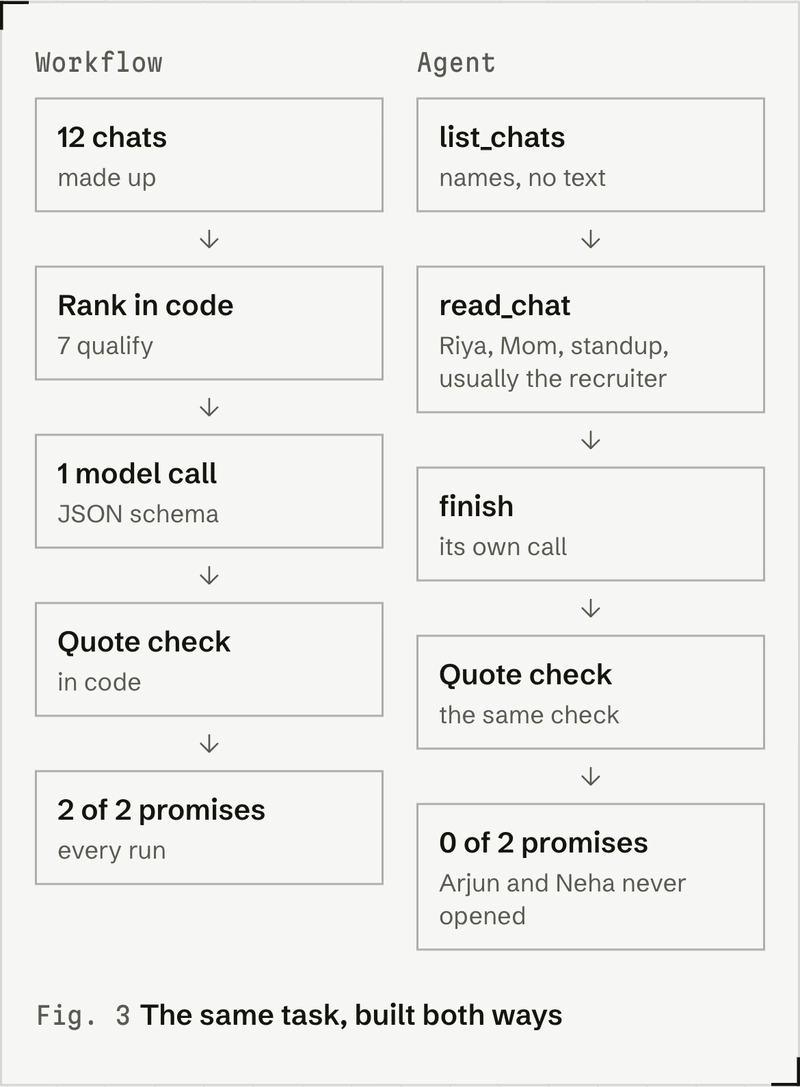
作者在 2026 年 11 月 10 日,通过 Groq 使用 openai/gpt-oss-120b 跑了三次。agent 每次都先看有人提问的聊天,随后结束,没有打开包含两条承诺的 Arjun 和 Neha 的聊天。
工作流每次都找到两条承诺,因为作者最后一条消息含「I'll」或「I will」时,与问号结尾的消息一样获得 14 分,超过 12 分门槛。模型能找到它们,首先是因为代码保证它们进入了输入。
请求成本也有差异。在这份实现里,agent 每一步重新发送此前累积的对话,累计输入 token 达到工作流的约 4.1 至 5.3 倍。这是跨请求累加的输入量,不是单次上下文长度,也不能直接当成费用倍数。Groq 将 thinking token 计入 completion token,演示把它拆出单列;可见输出与 thinking 两项相加,才是提供商报告的 completion 总量。
连续运行时,agent 因限流最多等待 29 秒;工作流有一次等待了 10 秒。演示仅在收到 HTTP 429 后,按提供商返回的延迟等待。
作者还单独跑过 gemini-2.5-flash,没有混入三次 Groq 数据。当时 AI Studio 项目显示每日 20 次、每分钟 5 次请求,第六次请求等待了 94 秒。这些都是作者当日账户观察值,并非所有用户的固定配额。
我的判断
这组实验支持一个具体结论:对于已经有明确候选筛选规则的任务,这份 agent 实现没有带来收益,还引入了提前停止的问题。它不足以支持「agent 普遍更差」:只有一个合成数据集、三次 Groq 运行,提示词、停止条件、模型或任务一换,结果都可能变化。作者给的是经验数据,不是完整基准。
工作流同样会漏。承诺如果写成「kal tak bhej dunga」,大意是明天之前发出,规则就不会因承诺措辞加分。聊天一旦被筛掉,下游模型再强也无法补救。
证据校验的边界也很清楚。代码可以确认引句确实存在、承诺由本人发出、待回复消息由别人发出。Gemini 曾把别人要求分享部署说明的消息认作作者的承诺,发送者检查拦住了它。
但工作流也曾把 Arjun 的「Bro the API docs link is broken」列为待回复事项。引句和发送者都真实,检查便放行了,系统没有证明作者需要回应。
证据真实,只能说明判断有出处,不能证明判断正确。
和全量提交聊天相比,规则筛选缩小了发送范围,也承担了漏选风险;和自主检索相比,它让覆盖范围更容易解释。原文没有给出全量提交的成本与准确率对照,这部分只能分析取舍,不能宣称胜负。
陌生代码库调查、探索性研究、未知原因的调试,下一步依赖刚得到的结果,才更适合让模型选择行动。即使如此,权限、校验和最终执行仍应留在应用代码里。
能拿来做什么
- 给日常 AI 编程功能先写出处理步骤。如果输入选择、处理顺序和输出去向都已确定,就先实现固定工作流,让模型承担语义理解任务。
- 在 Node 服务中分别处理输出结构、证据存在性和发送者归属。使用 JSON schema 后,仍需独立校验,业务语义则保留人工复核或抽查。
- 评估聊天或文档筛选规则时,同时检查候选集覆盖率。把隐含承诺、多语言表达纳入样例,确认重要内容有没有在调用模型之前被丢掉。
- 为代码库调查或调试 agent 设置步数上限,并记录读取范围、结束原因、累计 token 和限流等待。结果有真实出处时,也要继续检查是否漏掉了关键材料。