NCM 并行文本生成实测厘清加速边界
文章介绍先构建整体内容、再逐层并行细化的 NCM,并称使用官方代码和检查点复现评估,与同数据训练的自回归模型比较。作者强调,论文的 10 至 31 倍加速针对扩散语言模型,不能直接推广为相对传统大模型的优势。
AI 深度解读
NCM 能把一段文字的生成过程从逐个 token 接龙,改成先定粗轮廓、再并行补细节。但「快 10 到 31 倍」有明确比较对象:扩散语言模型。原文作者在笔记本上对比传统自回归模型,测到的是整段生成快 1.42 到 1.79 倍,首个可读输出却更晚出现。
这篇值得读的地方,是作者把论文结论、代码复现和产品体验拆开了。对程序员而言,真正的问题不是它会不会取代 LLM,而是减少串行步骤,究竟换来了什么,又付出了什么。
128 次接龙,怎样变成 11 次细化
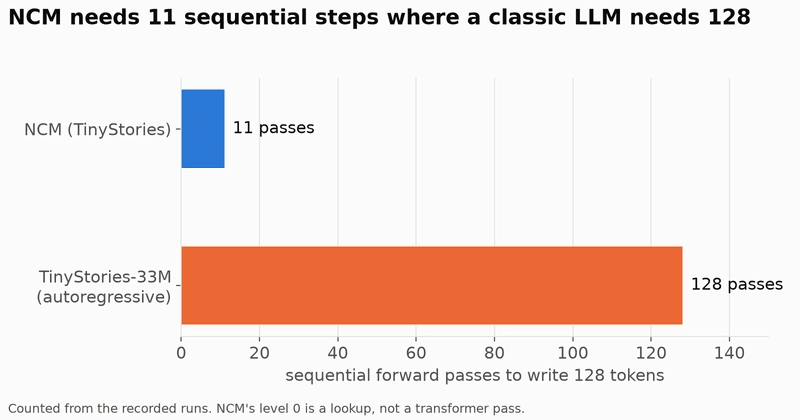
传统自回归(AR)模型根据已有 token 预测下一个。按原文讨论的逐 token 解码方式,生成 128 个 token,需要依次执行 128 次前向计算。GPU 虽然能并行处理大量运算,却不能提前知道尚未生成的前文。
扩散语言模型尝试从噪声或掩码出发,同时修正多个位置,但通常需要多轮细化。NCM 借鉴图像生成中的 VAR:先生成缩略图,再逐级提高分辨率。
文字没有天然的「缩略图」,所以 NCM 先用多尺度残差 VQ-VAE 学出一套离散编码。128 个 BPE token 被编码成 128×384 的连续潜在表示,再拆成 12 层。TinyStories 的各层长度依次是 1、8、16、24、32、40、52、64、76、92、108、128,每层都有包含 4,096 个条目的独立码本。
「残差」可以理解为补差:后一层只负责补上前面没表达好的信息。各层放大到完整长度后相加,解码器再把结果还原成文字。这里的「概念」是模型学出的编码,不保证对应人能命名的主题或提纲。
接下来,Transformer 每次预测下一整层的全部编码。TinyStories 的第 0 层直接从检查点保存的频率表采样,不需要调用 Transformer,因此剩下 11 层只需 11 次前向计算。
官方 decode_multiscales 可以把中间层解码出来,下面是作者一次运行的真实输出:
L0  (1 code)    .
L3  (24 codes)  One named the and.. and " is a it He felt wanted for before ...
L7  (64 codes)  day a boy found shiny in the. was happy showed his,. looked the ...
L11 (128 codes) One day, a little boy named Tim found a shiny stone in the park. He was very happy...
要看的是最后一行:可读的句法和措辞到后期才稳定。作者测得,中间表示与最终表示的余弦相似度从第 1 层的 0.28 升至第 11 层的 0.90;单层耗时也从约 45 ms 增至约 150 ms,因为细层需要预测更多编码。
11 次前向计算不等于耗时自动缩短到原来的 11/128,每次计算的工作量也变了。
论文里的 31 倍,究竟赢了谁
按原文介绍,Stanford Hazy Research 在 2026 年 10 月发布 NCM,论文编号为 arXiv:2610.14162。论文在 H100 上,与相同规模下较强的扩散语言模型基线比较,报告了三组结果:
- LM1B 的生成困惑度更好,速度约快 21 倍。
- OpenWebText 的质量有竞争力,速度约快 10 倍。
- XSum 的 ROUGE-L 相当,速度约快 31 倍。
Sudoku 实验还报告,NCM 在各难度上超过自回归和扩散基线,所需函数评估次数更少。这能支持继续研究全局结构生成,却不能直接证明它更擅长编程或通用推理。
作者另外做的是 CPU 实验:Apple M5 Pro、fp32、6 线程,使用 Python 3.12、PyTorch 2.15、Transformers 5.22。原文称,PyTorch MPS 缺少量化器所用的自适应池化支持,因此没有使用 Apple GPU。
官方代码固定在提交 c70274273f489abc73832b2b98584a8483b6b203,作者通过导入使用,没有修改仓库。复现调用 eval_shard.py 和 eval_merge.py,由启动器把 CUDA 设备请求映射到 CPU。
复现实验用了 5 个种子,每个生成 256 篇 TinyStories,共 1,280 篇,再由 GPT-2-large 评分。生成困惑度(gen-PPL)衡量评分模型对文本有多「意外」,越低通常表示越流畅;它不直接衡量事实正确性或任务完成度。
作者测到各种子的 gen-PPL 为 15.74 至 16.90,均值 16.23,论文为 15.41。作者据此判断结果复现成功,因为差距落在两个种子标准差以内,词汇熵也相符。生成耗时 4.5 分钟,评分另花 18.5 分钟。
这个结果支持「数量级接近」,但 CPU fp32 和库版本是否导致差异,原文没有做隔离实验,只给出了合理猜测。
整段更快,聊天窗口却未必更快
速度测试对每个模型和 batch size 先预热 2 次,再用种子 0 至 9 计时 10 次,使用检查点默认采样:temperature 1,不使用 top k 或 top p。
| 指标 | NCM | 自回归基线 |
|---|---|---|
| batch 1 整段耗时中位数 | 307 ms | 437 ms |
| batch 4 整段耗时中位数 | 734 ms | 1,313 ms |
| batch 1 吞吐量 | 341 词/秒 | 240 词/秒 |
| batch 4 吞吐量 | 571 词/秒 | 305 词/秒 |
| batch 1 首次输出 | 307 ms | 3.9 ms |
NCM 的整段生成分别快 1.42 倍和 1.79 倍,但自回归模型能先显示第一个 token。NCM 要等到全文可读,首次输出慢了约 80 倍。
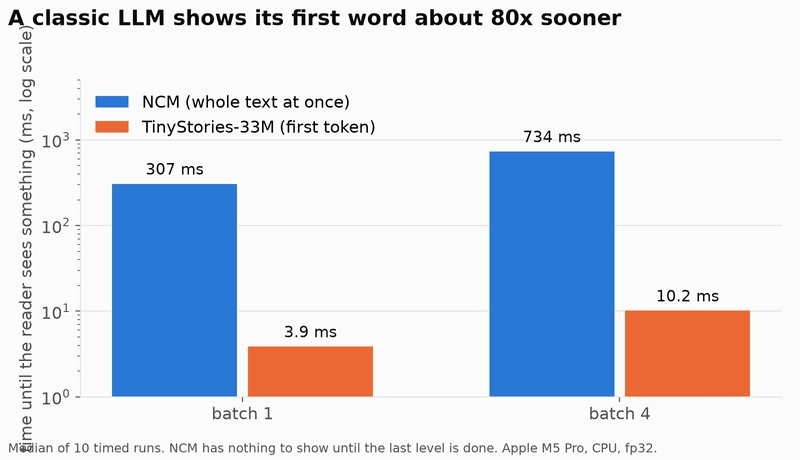
整段完成时间和首次可读输出,是两种不同的产品指标。
质量结果也没有呈现全面优势。同一个种子、同一批 4 个样本中,NCM 的 gen-PPL 为 13.48,自回归模型为 9.74;词汇的一元熵分别为 4.056 和 3.993,NCM 略多样,自回归文本更流畅。这里只有一次小样本比较,适合当线索,不能当最终排名。
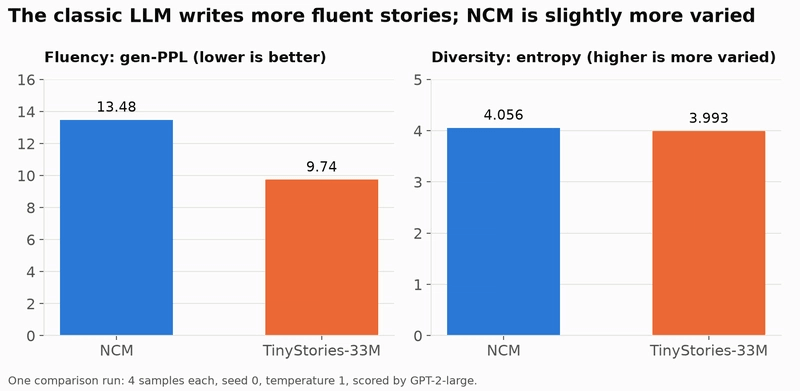
两者也不是严格控制变量:模型大小为 125M 与 68.5M,分词器分别采用 8,192 条目的 BPE 和 GPT-2 BPE,训练过程不同。NCM 固定填满 128 token,而基线可能提前结束。
作者还验证了自己的 FastAPI、React 实验台与官方输出一致:TinyStories 使用 seed 42、4 个样本,XSum 和 WMT14 各检查测试项 0 至 3。这个检查证明封装路径没有改变这些输出,不证明模型任务质量达标。
XSum、WMT14 能接受真实输入,但出现重复,例如把德语句子译成 I like like coffee in the morning.。作者没有完成全部 11,334 项和 3,003 项评测。
我的判断
作者最有价值的处理,是没有把不同实验混成一个速度神话。H100 上对扩散模型快 10 至 31 倍,与 CPU 上对自回归模型快不到 2 倍,可以同时成立。
我更愿意把 NCM 看成一种值得跟踪的生成架构。它减少串行依赖的方向很明确,但距离通用助手还有几道没有验证的门槛:几十亿参数扩展、长文本质量、指令跟随、多轮聊天和工具调用。TinyStories 检查点甚至是无条件生成,不能接收 prompt。OpenWebText 的 1,024 token 结果提供了一些线索,还不能回答这些问题。
粗层输出也暂时不能直接充当用户提纲,样例里仍有大量不通顺文本。逐段生成、展示计划、让 NCM 起草再由 AR 模型润色,都属于作者的设想。
与已经围绕 AR 建立的指令微调、RLHF、KV cache、推测解码和推理服务生态相比,NCM 还需要完整系统层面的比较。作者没有提供这些对照数据,因此「适合批量任务、适合混合架构」目前是有依据的方向判断,不是部署建议。NCM 自己也是语言模型,讨论时应比较生成方式,而不是说它取代 LLM。
能拿来做什么
- 做 AI 聊天前端时,分别记录首次可读输出和整段完成时间。逐层收到 WebSocket 消息,只能说明计算有进展,不能直接算作用户已经看到答案。
- 评估批量摘要、翻译或离线数据生成时,可以把 NCM 加入实验候选,但要使用真实任务测质量。当前小样本出现的重复,尤其需要单独检查。
- 想复现实验,可以运行原文实验台的
./run.sh。它用 SQLite 保存历史,支持逐层回放和 CSV 导出;结果位于results/,图表由blog/make_charts.py生成。原文估计安装约 20 分钟,主要花在下载,无需 GPU。 - 比较新模型时,沿用作者先验证官方输出一致、再跑性能测试的顺序,并把模型规模、分词器、输出长度和采样设置一起记录,避免让封装差异冒充架构收益。