Inkling 2 Mini 以循环层降低推理输出成本
Thinking Machines 发布开放模型 Inkling 2 Mini,每个 token 将 24 层中的 12 层运行三次,以内部计算替代部分显式推理文本。据报道,其智能指数追平 Qwen3.8 27B,成本约为后者六分之一,并可在笔记本运行。
AI 深度解读
Thinking Machines 发布的 Inkling 2 Mini,想用一种不同的方式压缩推理成本:让部分网络层重复计算,在模型内部多算几轮,减少为寻找答案而生成的文字。它是开放权重的多模态模型,原文称至少配备 32 GB 内存的 Mac 就能本地运行。
对程序员来说,值得关注的是它能否同时兼顾编程能力、输出成本和本地部署。不过,榜单成绩、运行门槛和实际开发体验,还需要分开看。
少生成文字,为什么还能多思考?
常见的推理模型会生成较长的推理文本,消耗更多 token。Inkling 2 Mini 使用循环 Transformer(looped transformer):处理每个 token 时,让某些网络层重复执行,把额外计算放在模型内部。
具体来说,它共有 24 层,其中 12 层连续运行 3 次。可以把它理解成同一组处理步骤反复加工信息,而不是每多想一步,就必须多输出一段文字。
它试图减少的是推理所需的输出 token,并没有消除额外计算。
Thinking Machines 称,这种设计能让模型用更少 token 找到正确答案。但原文没有提供关闭循环后的对照实验,也没有列出具体任务中节省了多少 token,因此还无法单独判断循环结构贡献了多少收益。
模型采用混合专家架构(MoE),总参数量为 264 亿,计入循环后的每 token 活跃参数量为 54 亿。这里的「活跃」指参与当前 token 计算的参数,不能直接拿它当作整个模型加载时的内存需求。
编程榜单很亮眼,能说明什么?
原文称,Inkling 2 Mini 在参数量低于 1000 亿的开放模型中,智能体编程测试成绩领先:
- DeepSWE v1.1 得分为 48.2%。
- Vals Index v2.2 得分为 46.5%。
Artificial Analysis 的 Intelligence Index 给它 20 分,与 Qwen3.8 27B(xhigh)和 Nanbeige4.3-33B 持平。原文还称,相比 Qwen3.8 27B,它的成本约为六分之一,速度约为四倍。
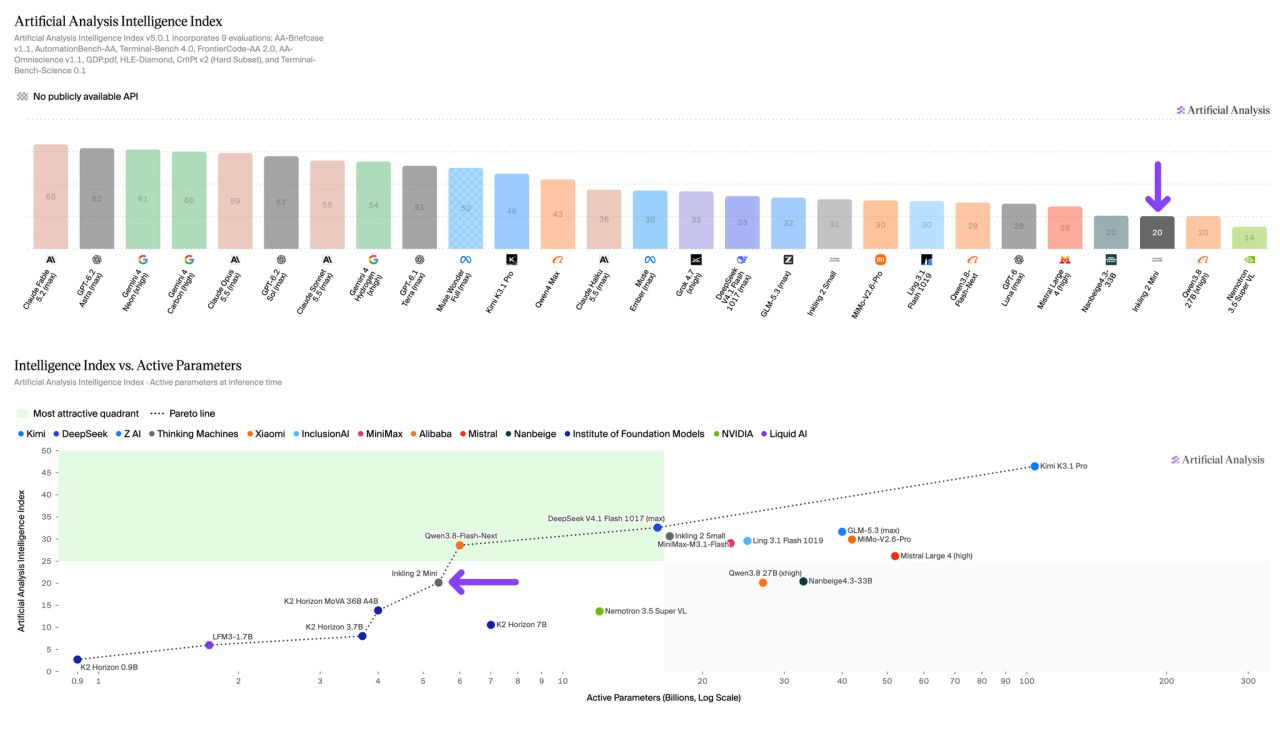
图中所谓「帕累托前沿」,是指在所比较的模型里,难以找到一个既使用更少活跃参数、又取得更高分的选择。这能说明它在该组指标下有竞争力,但不能推导出它在所有任务中都更划算。
原文没有交代成本统计口径、速度测试配置,以及编程评测使用的工具和运行设置。对于日常开发,修复一个项目里的问题是否成功、需要重试几次,比单个综合分数更接近实际价值。
能在 Mac 上运行,边界在哪里?
Inkling 2 Mini 支持文本和图像,提供 100 万 token 的上下文窗口,采用 Apache 2.0 许可证。权重可以从 Hugging Face 下载,也有允许调整循环次数的研究版本,还可以通过 Tinker Playground 试用。
本地设备方面,原文给出的条件是至少 32 GB 内存的 Mac,并提到支持 Nvidia DGX Spark。
这里需要分清两个指标:能加载运行,以及能以可接受速度处理长任务。原文没有说明 Mac 测试使用的量化精度、实际内存占用和生成速度,也没说这台设备能否承载完整的 100 万 token 上下文。
支持长上下文,不等于最低配置就能顺畅使用全部上下文。
我的判断
循环计算值得关注,因为它尝试把「多思考」和「多输出」拆开。对需要反复调用模型的编程智能体,减少输出 token 有潜在价值;但是否更快、更省,仍要把内部计算、调用价格和任务成功率一起算。
目前的证据更适合支持「值得试用」,还不足以支持「直接替换现有编程模型」。榜单成绩是评测结果,循环机制带来的收益是公司的解释;原文没有给出足够的消融实验,把两者严格连起来。
与依靠更长推理文本的方法相比,它提供了另一条路线。哪条更适合实际项目,仍需在相同任务和运行条件下比较,不能只看输出短了多少。
能拿来做什么
- 可以先在 Tinker Playground 测试已有的代码修复任务,记录完成情况、耗时和重试次数,再决定是否接入日常 AI 编程流程。
- 如果手头有至少 32 GB 内存的 Mac,可以下载权重验证本地运行体验,并记录量化配置、内存占用和生成速度。
- 对循环结构感兴趣的开发者,可以使用 Hugging Face 上的可变循环研究版本,在相同任务中比较不同循环次数的正确率、输出 token 数和耗时。