单卡部署语音转写,提示词也要测试
文章展示了在一张 32GB Blackwell 显卡上,使用 vLLM 与 NeMo Speech 部署 Nemotron 3.5 Transcribe 的方案,并兼容 OpenAI 转写接口。逐字转写、去除口头词和带时间信息的说话人区分由提示词控制,使提示词成为需要测试的接口行为。
AI 深度解读
Nemotron 3.5 Transcribe 把语音转写的输出选择放进了请求:保留口头语、整理成干净文本、区分说话人,都可以靠一句提示词切换。作者用一张 32 GB Blackwell 显卡跑通部署,但发现模型未必遵守格式要求。
这篇实测最有用的结论是:当 prompt 开始决定接口行为,它就需要像代码一样接受测试。至于准确率、24 GB 能否运行、线上服务会踩什么坑,作者给出了测量结果,也留下了明确的证据边界。
接口没怎么变,为什么测试要变
NVIDIA 于 10 月 28 日以 OpenMDW-1.1 许可证发布模型,提供了 vLLM 加 NeMo Speech plugin 的开放部署方案。作者选择最小的 21.6 GB NVFP4 文件,在单张 32 GB RTX PRO 4500 Blackwell 上运行。
他们用一个 Python 自定义后端接入标准路由 /v1/audio/transcriptions。现有客户端仍可沿用 OpenAI 风格的调用,只增加输出要求:
out = client.audio.transcriptions.create(
    model="default", file=open("meeting.ogg", "rb"),
    prompt="speakers", timestamp_granularities=["word"])
要看的是最后一行:speakers 是后端定义的风格名,会被替换为完整指令,也支持自由文本;逐词时间信息放在独立的 ctc_timestamps 对象中,每个词带有 start、end 和 speaker。
在 PriMock57 医患对话的前 3 分钟里,verbatim 和 clean 各耗费 4.1 s GPU 时间,带逐词时间的 speakers 耗费 4.4 s,返回 561 个带时间的词。
问题出在输出契约。clean 明确要求删除填充词和意外重复,保留其余原话,并以 Output: transcript only 收尾。填充词确实消失了,结果却混入 50 个以 <spk: 开头的说话人标签,还保留了起句中断的 Hello, how.。
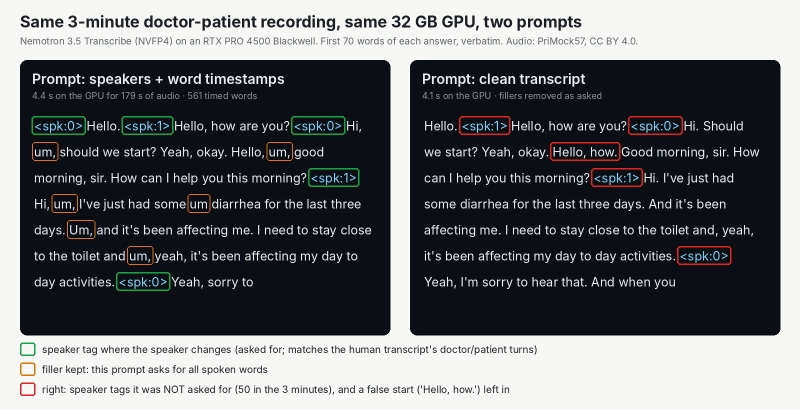
提示词定义了输出要求,却不能保证模型履约。
作者建议把每种风格当作一条代码路径:检查 clean 有没有 <spk:,检查 verbatim 是否保留口头语。后者在这段样本中保留了人工参考文本里 34 个 um、uh 中的 33 个。这是一次实测结果,不能直接当作其他录音的保证。
准确率居中,输出灵活才是主要收益
作者使用词错误率(WER)衡量与人工转写的差异,数值越低越好。在 Open ASR Leaderboard 数据中的 40 段英语短音频上,Nemotron 为 6.82%;此前按相同方式测得的 Bark 3.0 Pro 和 Qwen3-ASR-1.7B 分别为 6.28%、7.03%。
这个结果支持的是输出选择更多,而非准确率领先。
不同录音类型的差距更值得看。有声书语音上,Nemotron 以 0.94% 成为三者最佳;多人交叠说话的 AMI 办公会议中,它升至 14.62%,介于 Bark 的 11.54% 和 Qwen3-ASR 的 16.92% 之间。
样本规模也必须一起读:短音频合计只有 924 个词,另测了 3 分钟和 5 分钟录音,每次只发一个请求,没有测吞吐或并发。
NVIDIA 公布的九组英语数据平均错误率 4.71%,来自最大版本,作者没有复测。官方每秒处理 2,238 秒音频的数字来自尚未开源的封装引擎;NVIDIA 预计开放部署路径约慢两倍。不能拿这些数字替代本文配置的服务容量评估。
24 GB 能跑,但不能靠限制显存来证明
降低 vLLM 的 --gpu-memory-utilization,只是在大卡上限制可用比例,并不会把它变成小卡。作者设定 23.5 GiB 预算后,实际显存占用仍达到 25,712 MiB。
随后他们改用 RTX PRO 6000 Blackwell 的真实 24 GB 切片。该切片只有整卡四分之一的算力,还必须关闭 speculative decoding(推测解码)和 CUDA graphs。前者通过提前草拟多个词再验证来加速,后者通过重放已记录的 GPU 工作减少调度开销。
在 16,384-token 上下文、同时 2 个请求的配置下,词错误率仍为 6.82%,但同一段 3 分钟说话人转写从 4.4 s 增至 35.3 s。开启推测解码则显存不足。由于算力与优化配置都变了,这不是单独衡量显存影响的对照实验。NVFP4 还要求 Blackwell,不能直接搬到 RTX 4090 或更早的卡上。
部署也有三处具体故障:
- FlashInfer 内核构建在 62 GB 容器里被终止,当时约有 18 个并行
nvcc编译任务;作者改用预编译内核,并设置MAX_JOBS=6。 - 平台通过
SIGKILL删除后端后,残留的vllm serve仍占用 25 至 29 GB。作者用PR_SET_PDEATHSIG和旧 pid 文件检查绕过,平台改成SIGTERM加宽限期的修复仍待提交。 - 他们平台的转写路由只允许上传 2 MB,约对应 8 分钟压缩语音,低于模型支持的 1 小时。暂时只能切片,跨片段说话人标签能否保持一致尚未测试。
我的判断
我认同把输出风格纳入接口测试。对于接收转写结果的前端和 Node 服务,标签是否混入正文、时间对象是否齐全,都直接影响展示与后续处理,不能只看文本读起来顺不顺。
不过,作者没有给出与「转写后再清理、再区分说话人」方案的完整对照数据,因此一体化请求是否更省成本、更稳定,仍不能下结论。它减少了显式处理步骤,也把部分格式控制交给了模型。
这份实测证明了一组配置可以运行,还没有证明它适合生产并发。
尤其要区分模型限制与作者平台的问题:2 MB 上传上限、删除后的残留进程都来自其部署环境;24 GB 切片的速度也不能代表所有 24 GB Blackwell 配置。
能拿来做什么
- 给转写客户端建立按风格划分的回归样本,分别检查
clean的标签残留、verbatim的填充词保留,以及speakers的逐词时间字段。 - 做会议产品时,优先拿自己业务中的交叠发言录音测 WER,再决定是否采用,别只参考 6.82% 的总体结果。
- 在 Node 接口与前端展示之间明确
ctc_timestamps的解析规则;如果清理<spk:标签,要把这项处理写进接口约定。 - 部署前用真实目标显卡验证显存和延迟,同时检查上传限制与子进程退出;长音频切片后,单独验证说话人标签能否跨片段对应。