NaiveAI高速推理下的编程能力实测
NaiveAI宣称可达每秒2,100个Token,有望冲击Artificial Analysis速度榜前列。Latent Space的上手测试认为,其编程表现可与DeepSeek竞争,但摘录未给出具体测试任务和评分。
AI 深度解读
Naive-N0.5-Flash 把 AI 编程的卖点推到了速度上:峰值每秒 2,100 tokens,但生成得快,能不能更快交付可用代码?Latent Space 用数学与推理题、三个浏览器应用做了比较,结果是:它在多数请求里响应更快,开启思考后的代码表现也有竞争力,但难题可能消耗大量思考 tokens,运行效率也未必领先。
对前端开发者,这篇评测最有用的地方,是把生成速度、等待时间、代码质量和费用拆开了看。这四件事,不能靠一个 TPS 数字判断。
每秒 2,100 tokens,为什么不等于任务完成得更快
Naive-N0.5-Flash 是中国公司 NaiveAI 开发的开放权重模型,基于 Xiaomi 的 MiMo-V2.5 继续训练,并搭配自研推理引擎 NaiveRT。
它的底座是一个总参数 310B、激活参数 15B 的稀疏混合专家模型(MoE),原始训练量为 48T tokens。MiMo-V2.5 继承了 MiMo-V2-Flash 混合使用滑动窗口注意力(SWA)与全局自注意力的设计。NaiveAI 又用约 3.25T tokens,将模型适配到 DeepSeek Sparse Attention(DSA);其中约 3T 使用固定 1M 上下文长度、恒定学习率训练。
不过,速度卖点还依赖部署系统。官方数据来自单个配备八张 Blackwell GPU 的节点,运行 NaiveRT 和草稿模型 Naive-N0.5-Flash-FP8-Draft,优化目标是单路生成延迟。
这里用了推测解码:草稿模型先提出一批 tokens,目标模型验证后接受其中一部分。接受得越多,提速越明显。关闭思考时接受率为 70.6%,开启后降至 43.4%;思考阶段约 984 tokens/s,回答阶段约 1,816 tokens/s。2,100 tokens/s 是单秒峰值,应当视作上限。
NaiveAI 还报告,一轮草稿生成、验证、采样与提交,在 NaiveRT 中耗时 3.4 ms,SGLang 为 12.3 ms,减少 72.4%;关闭思考的一组测量约为 3.45 ms。这些是开发方提供的数据,不能直接当成所有部署的表现。
生成速度决定每个 token 花多久,输出长度决定你最终等多久。
实测中位数很快,难题却会拉长等待
作者比较了 Naive-N0.5-Flash 的 ultrafast 模式、DeepSeek V4.1 Flash 1017 和 GLM 5.3 Flash。每个模型测试 30 道纯文本题:MATH-500、GPQA-Diamond、HLE-Diamond 各随机抽取 10 道,分别代表易、中、难,最大 completion-token 限制统一为 256K。
吞吐量的口径并不一致:DeepSeek 和 GLM 来自 OpenRouter,Naive 来自服务端测量,因此作者没有给出精确的速度倍数。更适合比较的是端到端耗时。
| 配置 | 耗时中位数 | 耗时平均值 |
|---|---|---|
| Naive-N0.5-Flash(thinking) | 3.1 秒 | 45.3 秒 |
| DeepSeek V4.1 Flash 1017(high) | 10.1 秒 | 45.0 秒 |
| GLM 5.3 Flash(high) | 5.3 秒 | 86.9 秒 |
Naive 的典型请求更快,但平均值与 DeepSeek 几乎相同。原因藏在少数超长回答里:开启思考后,Naive 在全部题目上的 completion tokens 中位数约 3,200,平均值却超过 51,000。
在困难的 HLE 题目上,Naive 平均生成约 108,500 completion tokens,约为 GLM 的 9 倍、DeepSeek 的 11 倍。尽管吐字很快,平均耗时仍达到 89.8 秒,慢于 DeepSeek 的 79.7 秒。
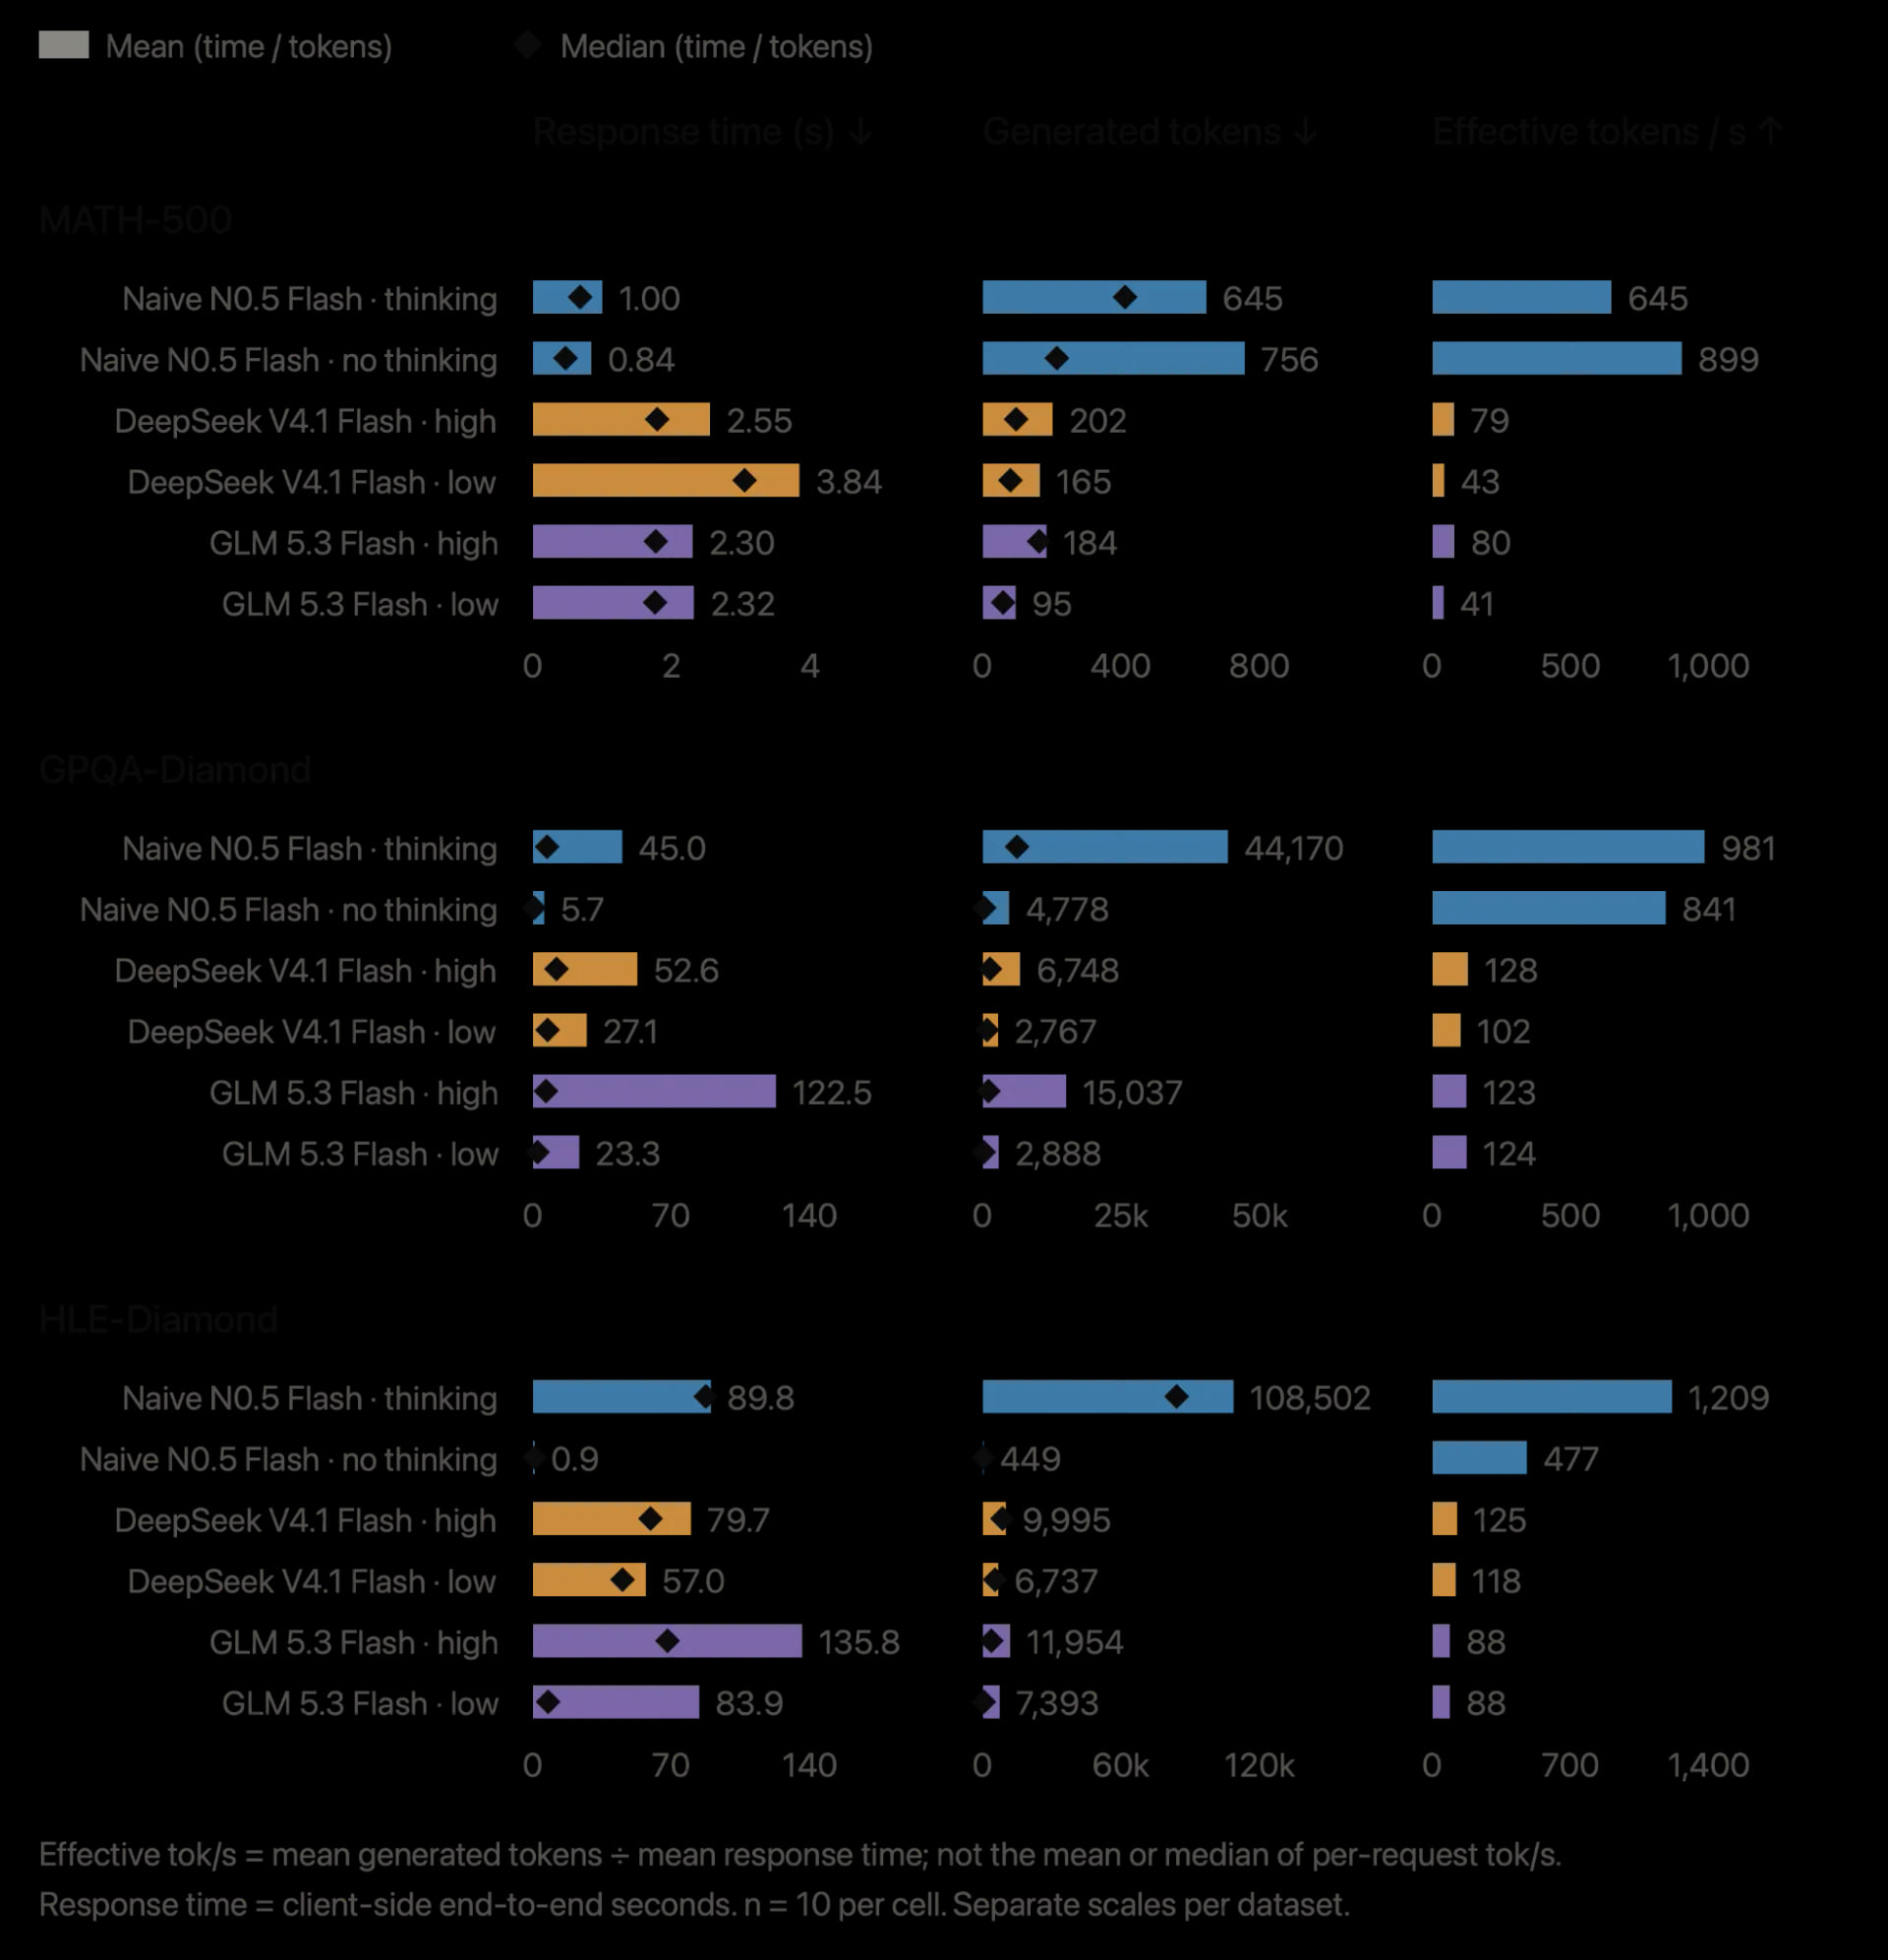
这组实验有明确边界:每档只有 10 道题,而且没有批改正确率。它能说明等待时间和输出长度,不能证明谁解题更好。
原文引用的公开榜单认为,Naive 的编码能力位于两款对照模型之间,在 NL2Repo-Bench 上领先两者。但所给材料没有完整分数表;Artificial Analysis 当时也尚无 Naive 的数据。可确认列出的 Intelligence Index 是 DeepSeek V4.1 Flash 1017(Max)的 45 分,不能据此补出三方排名。
三个前端应用,暴露了不同的代码能力
作者还给三款模型相同的初始提示词,测试六种模型与思考配置,展示了三个浏览器应用。正文可辨认的配置包括 Naive 的 no thinking、thinking,以及 DeepSeek 的 low、high;GLM 的展示和讨论使用 high,完整六项清单在所给原文中缺失。
第一个任务是交互式地球与太阳系,支持镜头环绕、行星公转和速度控制,所有表面纹理都由程序生成,不使用图片文件。
作者认为 Naive(thinking)最好:太阳有黑子,地球背光面还有城市夜景。DeepSeek(high)紧随其后,但缺少小行星带,地球细节较少。GLM(high)的光照让行星难以区分,速度控件也过于敏感。
第二个任务是用带种子的随机生成器创建 3D 树:分支逐渐变细并分叉,包含数千片叶子、树皮纹理、风动与阴影,还能调整种子、分支深度、叶量、风向、太阳位置,切换秋色并显示帧率。
Naive(thinking)和 DeepSeek(high)都得到不错的结果,但 Naive 关闭思考后,没有生成可用应用。成功版本也有瑕疵:DeepSeek 的细枝在强风下偶尔脱离父枝,GLM 的整棵树则会明显扭曲、晃动。
第三个任务更能区分程序效率:将《Ray Tracing in One Weekend》移植到浏览器,实现不同材质球体、景深、渐进渲染、进度与耗时显示,以及质量预设和 PNG 下载。
三款开启思考的模型都做出了可运行应用。作者认为 DeepSeek 的光线追踪器效率最高,也充分利用了屏幕宽度;Naive 实现正确,但 JavaScript 效率较低;GLM 速度与 Naive 接近,界面更简陋。原文没有提供可用于量化差距的运行耗时或性能剖析。
模型更快写出代码,不代表代码运行得更快。
我的判断
我认可作者把端到端耗时和输出长度一起展示。这比单看 TPS 更接近日常 AI 编程体验:一次小改动很快完成,与一个难题长时间不结束,是两种不同的使用感受。
价格也要按整次任务计算。Naive 给出的目标价格为每百万输入 tokens 0.10 美元、输出 tokens 0.40 美元、缓存读取 tokens 0.01 美元;输出价格位于多款 Flash 模型每百万 0.20 至 0.60 美元的区间内。但目标价格不等于已经确认的实际账单,大量思考 tokens 也可能抵消单价优势。
这篇文章足以支持「值得试用」,还不足以支持团队直接换掉现有模型。三个应用覆盖了视觉细节、交互和算法实现,却没有展示多次生成的成功率、修复轮数或统一验收结果。太阳系谁最好、树谁打平,主要是作者的观察判断。
相较于直接选更快的模型,限制思考预算、按任务切换模型,也是可比较的做法。原文没有测试这些策略,无法判断哪种更划算。
至于 NaiveAI 提出的递归自我改进、让 AI 优化自身推理 CUDA kernels,是更长期的主张。DSA 降低解码成本可能帮助强化学习生成 rollout,但这篇评测没有验证自我改进是否成立。
能拿来做什么
- 如果你常用 AI 生成浏览器交互原型,可以用同一组提示词比较 Naive、DeepSeek 和 GLM,同时记录等待时间、首次运行成功率与修复次数,再决定是否切换。
- 对程序化纹理、随机几何体这类约束较多的任务,优先验证 thinking 配置。原文中 Naive 关闭思考后生成 3D 树失败,不能假定省去思考总能换来更快交付。
- 对光线追踪等计算密集型 JavaScript,验收时加入实际运行性能。页面能打开、画面正确,只完成了一部分要求。
- 评估调用成本时,同时记录 completion tokens、耗时中位数和少数最长请求。遇到长推理任务,单看每百万 tokens 的报价容易低估费用。