预测准确率为何掩盖 AI 系统失效
作者复盘运行五个月的 LLM 预测市场系统,发现方向准确率、Brier 分数及早期交易优势都不能证明策略能盈利。摘录指出,整体准确率还混入了大量未执行交易的样本,导致评估口径偏离实际目标。
AI 深度解读
一个 AI 预测机器人跑了五个月,方向准确率超过 60%,部分策略跑赢市场,还有结果达到统计显著。看上去,该让它正式交易了。作者逐项检查后却发现:这些好成绩,没有一个足以证明它能赚钱。
问题出在评估系统:算错了样本、选错了基线、低估了成本,还混入了输入错误和未来信息。对做 AI 编程工具、分类器或 Agent 的程序员,这篇失败复盘值得读,因为同类问题也会让产品评测报喜、实际使用掉链子。
全量准确率很好,为什么一出手就错?
作者用 LLM 研究 Kalshi 和 Polymarket 的预测市场,估计事件概率,再与市场价格比较。偏差足够大时,系统记录一笔模拟下注,结算结果存入 SQLite。
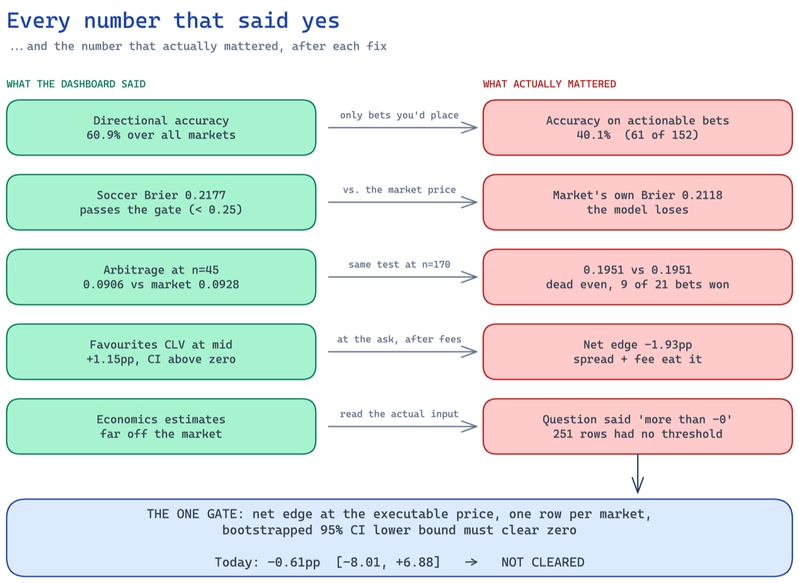
最初,方向准确率是 60.9%。但分母包含模型看过的所有市场,其中大部分属于 SKIP:预测接近市场价格,根本不会下注。热门结果原本就更容易猜中,这些样本抬高了总成绩。
真正触发下注的是预测与市场相差至少 5 个百分点的样本。这个子集里,模型只猜对 61/152,准确率为 40.1%。
评估应该跟着系统实际采取的动作走。
作者举了一个通用例子:如果 Agent 只对 15% 的输入采取行动,其余 85% 就不能代替这部分决策接受检验。当然,40.1% 也不能单独判定收益,价格同样重要;它首先证明的是,全量准确率掩盖了行动样本的表现。
第二个问题是及格线设错了。作者原定 Brier score 低于 0.25 就通过,足球预测得到 0.2177,顺利过关。这个分数衡量概率预测误差,越低越好。但同一批比赛,市场价格的分数是 0.2118。
模型及格了,却输给了交易对手。
扩大到 517 个市场,模型为 0.2376,市场为 0.2166,各足球类别也都输给市场。作者因此停掉足球预测。对程序员来说,这对应一个熟悉的问题:新 Agent 达到自设指标,还得证明它优于现有规则、旧模型或简单的 if/else。
样本扩大、成本补齐后,优势还剩多少?
跨平台策略寻找同一事件在两个交易所的价差。前 45 个样本中,模型 Brier score 为 0.0906,市场为 0.0928。作者据此接上了真实下单能力。
样本增至 170,接近原来的 4 倍,两者都变成 0.1951;实际触发的 21 笔下注只命中 9 笔。早期优势没能保持。这里能支持的结论是,这个策略的优势尚未得到证明,而非所有策略都不可能有效。
作者在另一项策略里提前约定:买入价格为 0.65–0.80 的热门结果,至少观察 100 笔已结算的样本外下注。到 135 笔时,命中率为 65.19%,平均买入价格为 68.69%,每份合约毛优势已经是 -3.50pp。pp 表示百分点。
接着,他发现手续费公式也错了。原先使用 0.003 × p,后来按原文所述的 Polymarket US taker fee 公式 0.0695 × p × (1 − p) 修正。在这些价格附近,手续费约 1.5 个百分点,是原估计的 5 倍,净优势降至 -4.97pp。
连统计显著的结果也没逃过执行成本。热门策略的收盘线价值(closing-line value)为 +1.15pp,95% 置信区间是 [+0.37, +1.97],整体高于零。这个指标考察入场价格相对后续收盘价格是否有利。
但作者用的是买卖报价的中间价。改按实际买入要付的卖一价(ask),再扣手续费,结果变成 -1.93pp。
中间价上的优势,未必能在成交时兑现。
作者把它类比到 AI 系统:质量分数如果没算延迟、token 成本和重试率,也可能高估产品价值。
模型答错之前,先确认它读到了什么
经济类市场会问「CPI 是否高于 3.2%」这样的问题。模型预测严重偏离,作者连续几周都在找建模原因,最后发现是解析错误:带小数点的阈值被截断,模型实际收到的问题成了「more than -0」。
共有 251 行数据是在缺失阈值的情况下生成预测的。模型连题目都没读全,继续调提示词或换模型,很难修复这类故障。
回测还有相反的问题:滚动向前校准(walk-forward calibration)偷偷使用了预测时刻之后的信息,并且重复计算部分市场。前者让评估看到了未来,后者让样本权重失真。修复后成绩更差,却更可信。
五项修正完成后,作者只认可一个放行指标:按可执行价格计算、扣除手续费、每个市场只计一行的已实现优势,并通过自助重采样(bootstrap)得到 95% 置信区间,下界必须高于零。
当时的累计结果为 -0.61pp,区间 [-8.01, +6.88],没有通过。
连还需多少样本,他也算错过。此前的「再来约 400 笔」建立在被高估的效应量和 50% 统计功效上;按 80% 功效证明真实存在的 3 个百分点优势,约需 2,000 笔。功效可以理解为:优势确实存在时,检验有多大概率识别出来。具体数量仍依赖计算假设,不能直接搬给其他项目。
我的判断
这篇最有价值的地方,是把「上线资格」变成了可执行约束。真实订单默认被硬禁用,每次运行都必须显式设置环境标志;每个平台累计亏损上限为 $50,由代码执行。原文没有给出环境变量名称和具体命令。
作者还提前登记淘汰条件:经济策略在固定日期接受固定检验,结果模糊就淘汰。热门策略失败后,虽然切出 0.70–0.80 区间看起来略有优势,也不再给它单独开一次检验,避免从失败数据里反复挑赢家。
这些做法有明确道理,但它仍是一份个人项目复盘,没有与其他 LLM、人工预测或替代架构做完整对照。它不能证明 LLM 不会预测,也不能证明这套门槛适合所有团队。
尤其是收益评估与 Agent 评估之间的类比,只能迁移原则。代码助手的正确性、维护成本和响应速度,很难合并成一个像交易净收益那样清晰的数字。一般团队更适合保留多个指标,再设定明确的发布条件。
另外,置信区间的可靠性仍依赖数据与重采样方式。原文没有交代市场间相关性如何处理,不能因为加入 bootstrap,就认为统计问题已经全部解决。
能拿来做什么
- 给 AI 编程助手分开统计全部请求和实际应用的修改,并检查后者的成功率,避免大量简单问答掩盖代码改动失败。
- 给 Node Agent 保留现有规则或旧流程作为同批基线,比较完成质量,同时记录延迟、token 消耗和重试成本。
- 保存模型实际收到的输入与时间信息,先检查解析后的字段是否完整,再排查评估是否混入未来数据或重复样本。
- 在实验前写下样本量、观察日期和失败条件;看到早期好成绩时按约定继续收集,避免临时放宽上线门槛。