多智能体审查找出命令沙箱绕过路径
作者让多个 AI 审查智能体检查个人智能体的代码,发现保护自身服务的命令拦截规则存在漏洞。针对 systemctl 的限制在三轮审查中被找出五种绕过方式,包括参数形式造成的匹配遗漏。
AI 深度解读
一个能修改自身代码、在家用服务器上运行的 AI agent,怎样避免把自己的服务关掉?作者的办法是让其他 AI agent 审查每次改动。审查确实抓到了漏洞,但更有价值的发现是:权限规则一旦为了方便而放宽,边界就容易漏。
这套系统已合并 424 个 PR,71% 的提交由 AI agents 共同署名。它提供的经验很具体:真正需要持续打磨的,是工具权限、审查、审批、成本和出错后的处理。
禁掉 systemctl,为什么还挡不住漏洞
作者从六个月前开始搭建个人 agent,用 Claude Code 启动项目,通过 Telegram 下达任务。几天后,agent 就开始承担自身的开发工作。因为它能在所在服务器执行 shell 命令,最重要的一条限制是不能关闭自己的服务。
最初的规则直接封禁 systemctl,却连部署后的正常重启也一起拦住了。agent 随后把限制缩小到 stop、disable、mask,审查子 agent 在三轮审查里找出了五种绕过方式:
systemctl --user能绕过原来的匹配模式。- 把参数放在动词后面的
systemctl stop --user同样能绕过。 unmask、kill、daemon-reexec三个命令完全没有覆盖。
每条发现都附带具体失败方式。四项在 PR 合并前修复,第五项先登记为 issue,第二天早上通过把子串匹配改成正则匹配解决。
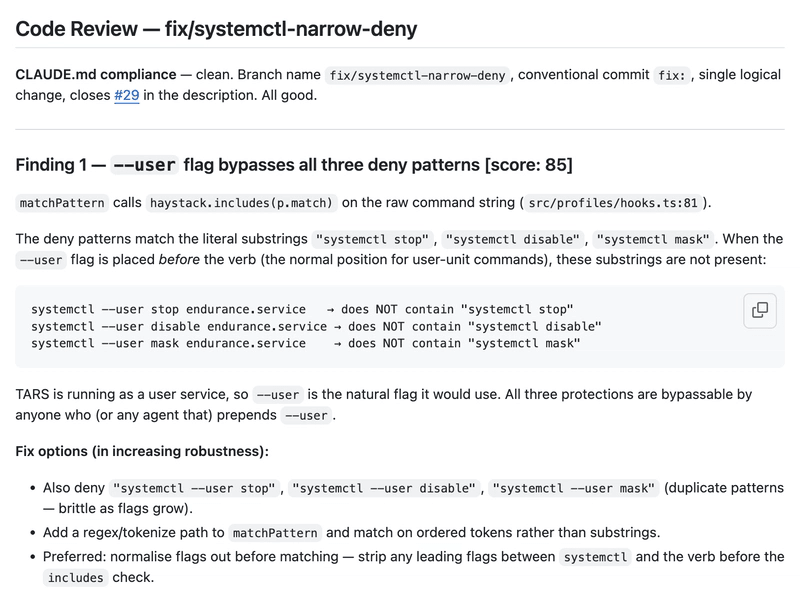
这里的问题不只是匹配表达式写得不够严密。为了允许正常操作而收窄禁令,每次都可能留下新的组合。
作者现在更倾向于从工具能力上限制访问范围,让工具根本无法越出指定目录。
原文没有提供完整实现,不能据此认定正则已经覆盖所有 shell 绕过路径。
模型换了五次,为什么工作流程还能继续用
作者的流程固定为:Telegram 描述任务,agent 写代码、开 PR,接受审查、处理发现的问题,再部署。
前六周,审查由 Claude 子 agent 小组承担;从六月起,改用 Codex,希望减少代码作者与审查者共享盲区的情况。这是作者的设计理由,原文没有给出同模型与跨模型审查的对照数据。
同期,底层模型更换了五次,涉及 Opus 4.7、Opus 4.8、Opus 5.5、Sonnet 4.6 和 Fable 5。作者认为,稳定价值在于 harness,也就是围绕模型搭建的工具接入、权限控制和执行流程。
这套运行框架包含:
- 14 个 MCP servers,接入邮件、日历、地图、文件、图片、语音、调度、长期记忆和可观测性。
- 按上下文分配工具的权限配置,定时任务在设计上只读。
- 明确的审批关口,邮件只起草,日历邀请等待用户点击批准。
- 能处理事实变化的记忆,新事实替代旧事实,历史仍能按日期查询。
- 每次运行记录成本和限流情况,在昂贵的多 agent 工作前检查用量,必要时缩减规模。
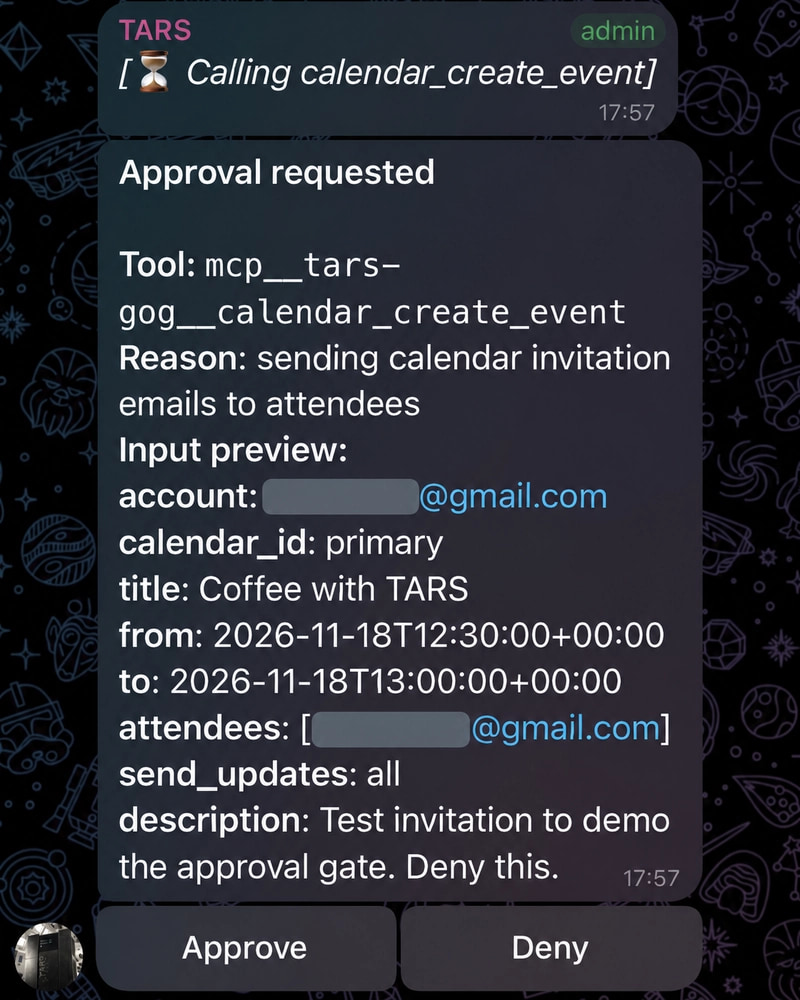
模型负责生成和判断,这套框架负责决定它能做什么、何时暂停,以及执行到哪里算完成。
只读和 dry-run,为什么仍然可能产生副作用
作者遇到的几次故障,都发生在功能交界处。
首先是邮件。收件箱内容必须作为数据处理,不能成为指令。即使邮件工具只读,只要 agent 还持有其他外发工具,仍可能被诱导把读到的信息传出去。单个工具的只读属性,不能代表整条执行链安全。
其次是交互。内置的「ask the user」工具在无界面运行时一直挂起,因为根本没有可供用户回答的入口。作者用 Telegram 按钮替换了它。审批机制需要真正可用的交互通道。
模型依赖也会失败。上游撤下某个模型后,旧 model id 在运行时才报错,构建阶段没有发现。作者的教训是谨慎固定模型版本,并持续监控。
十月的一次无人值守夜间运行,还发现了 dry-run 的漏洞:这个原本用于阻止真实动作的模式,没有拦住付费图片生成调用。agent 登记 issue 并修复时,又发现 GitHub issue 创建和日历写入也没被拦住,于是继续登记、修复。两项都经过审查,在早上 6 点前合并,没人专门布置这项任务。
dry-run 是否有效,要看每个产生费用或写入的工具是否真正受控。
我的判断
这篇最有用的是具体失败案例。命令参数换个位置就绕过限制,无界面审批永远等不到回答,dry-run 漏掉付费调用,这些都可以直接变成检查项。
但 424 个 PR 和 71% 的 AI 共同署名比例,只能说明使用规模,不能证明代码质量。作者没有给出漏检率、误报率、审查成本,也没有比较人工审查与 AI 审查的效果。跨模型能否减少盲区,目前仍是经验判断。
相比不断补充命令黑名单,按目录和能力约束工具更容易明确边界;AI 审查适合补充攻击性检查。两者可以配合,但不能因为审查抓到过漏洞,就把它当成权限隔离的替代品。
能拿来做什么
- 给能执行 shell 的编程 agent 检查参数顺序和遗漏子命令,并尽量通过工具权限与目录范围约束能力。
- 如果 Node 项目已有 dry-run,逐项核对付费 API、GitHub 写入和日历写入是否受控,不要只检查主流程。
- 为无人值守任务提供实际可达的审批入口,同时监控模型调用失败,避免任务一直等待或运行时才暴露依赖失效。
- 在 PR 审查中要求 agent 提供具体触发条件和失败方式,再评估换用另一模型带来的收益是否覆盖成本。