动态深度推理为何省算力却未必更快
文章分析逐 token 深度路由与统一全层计算的性能差异:跳过部分层虽减少运算,却引入路由、内存访问和不规则执行开销。GPU 上的实际延迟还受批次同步与内存瓶颈影响,不能直接由 FLOPs 降幅推算。
AI 深度解读
Transformer 里的逗号和复杂推理步骤,通常都要经过同样多的层。Mixture-of-Depths 想改变这件事:让不同 token 使用不同计算深度,省下不必要的运算。原文的核心判断是,少算不一定更快,因为路由、搬运数据和批次同步也要付费。
这篇值得读的地方,是把「节省 FLOPs」拆成了部署问题:服务能否在尾延迟达标时处理更多请求,答案质量会不会下降。它给出了评估思路,但没有提供足以验证收益的实测数据。
少算 25%,为什么服务可能没变快
统一全深度执行(uniform full-depth execution)让所有 token 经过所有层,形成形状规整的张量。GPU 可以连续执行矩阵乘法,调度也比较简单。
逐 token 深度路由则让一个可学习的门控模块决定哪些 token 进入某一层,其余 token 绕过。计算路径因此变得参差不齐:同一批数据里的不同位置,可能执行不同数量的层。
原文给了一个算术例子:对于一个 32 层模型,如果一半 token 跳过一半层,运算量大约减少 25%。 这个数字是条件推算,不是作者报告的性能测试结果。
真正执行时,省下的矩阵运算前后还有额外步骤。路由器先计算选择结果,top-k 产生索引,再通过 gather 把选中的激活值收集到紧凑缓冲区,计算完成后用 scatter 放回对应位置。
可以把它理解为:原来所有人按座位顺序一起做题,现在先挑人、重新排座位,做完再送回去。题少做了,组织过程却变长了。
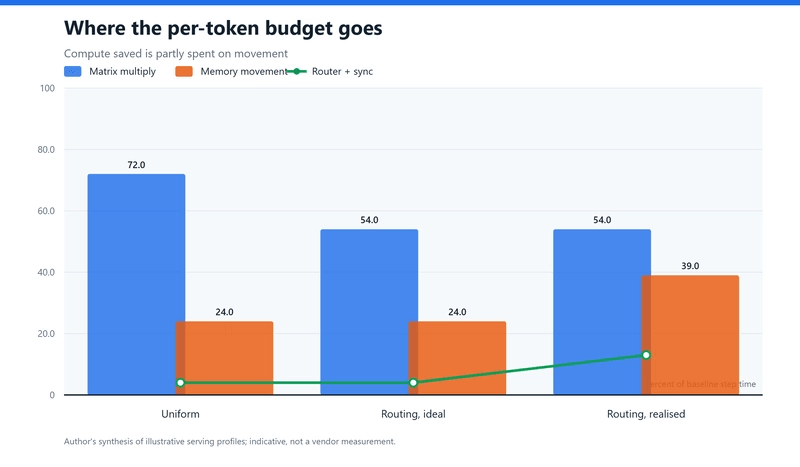
这里要区分计算量与内存带宽。FLOPs 衡量做了多少浮点运算,延迟还取决于数据搬运需要多久。如果原来的服务已经卡在内存带宽上,减少乘法次数未必能缩短等待时间;新增的 gather、scatter 反而可能继续争抢带宽。
原文认为,这些额外操作可能吃掉全部 25% 的算术节省。但它没有给出硬件型号、模型配置和测量结果,不能把这个可能性当作普遍成立的比例。
大批量离线任务和交互服务,账要分开算
深度路由的另一个成本出现在批处理里。
统一执行时,批次中的 token 具有一致的计算结构。不同 token 走不同路径之后,调度器需要把计算需求相近的 token 分组,或者给较短路径补齐。
两种办法都有代价。分组增加同步和调度工作;补齐则会重新执行一部分原本想省掉的计算。批次越不规整,理论节省越难完整兑现。
因此,原文把优势场景放在大批量、以吞吐量为目标的离线任务上,并补充了一个条件:带宽不能已经饱和。交互服务通常使用较小批次,还必须控制慢请求,留给路由开销的空间更小。
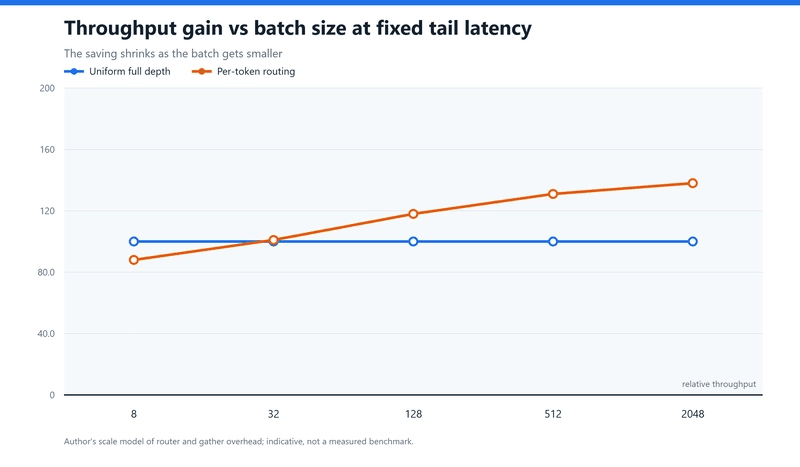
尾延迟关心的是响应时间分布中较慢的那一端。一个方案即使平均速度更快,只要慢请求明显变多,也可能无法满足在线服务要求。
公平比较应当固定尾延迟目标,再看端到端 tokens/s。
这里的端到端必须包含路由、top-k、gather、scatter 和调度成本。只测被选中层的执行速度,相当于只计算做题时间,遗漏了前后的组织成本。
原文据此提出,同一个模型检查点可以在不同部署场景下采用不同执行方式。不过,它没有解释既有检查点如何获得路由能力,也没有说明训练或改造成本。这句话适合作为部署方向理解,不能直接当作任意模型都支持的开关。
把计算分给「难词」,不等于答案更可靠
性能之外,路由还涉及质量问题。
如果路由器依据语言建模损失学习,它可能优先把计算资源分给局部难预测的 token。但局部难预测,与对最终答案重要,是两种判断。
原文举了两类可能的错配:长推理链开头的 token 看起来容易,却决定后续推导方向;罕见专有名词后面的标点不容易预测,却未必值得投入更多计算深度。
这些是作者用来解释风险的例子,并没有附带对应实验。它们支持的是评估要求:应该检查下游任务最终完成得怎么样,不能只看逐 token 损失是否接近。
成本核算也有类似问题。原文认为,统一执行下 token 数与加速器运行时间的关系较容易估算;路径不规则后,两个 token 数相同的请求可能消耗不同资源,进而影响配额、限流和报价。
这个方向有道理,但「统一执行近乎线性」也只是简化。原文没有展开其他影响成本的条件,因此不能据此认为统一执行天然具有固定单价。
我的判断
我认同原文把比较标准从 FLOPs 拉回实际服务表现。对于需要等待模型返回结果的应用,用户能感知的是完成时间、慢请求和答案质量,计算量下降只是实现这些收益的一条路径。
但这篇更接近工程分析,不能视为一份基准报告。它没有给出具体模型、硬件、批次配置、尾延迟指标或对照数据。文中的图也不能替代可复现的测试条件。「大批次更适合路由、小批次更适合统一执行」可以作为验证起点,暂时不宜当作选型结论。
相比引入深度路由,保留统一执行的直接好处是张量规整、调度简单、成本较容易解释。路由值得承担多少复杂度,应由实际增加的有效吞吐决定。原文并未证明它优于其他服务优化做法。
还有两处需要单独打问号。作者把深度路由与资本支出、统一执行与运营支出关联起来,却没有说明采购和部署模式如何导致这种差异。这段财务判断缺少论证。
作者还估计,到 2030 年,包含路由运行时、调度器和编译器的服务端优化市场可能达到每年约 20 亿至 60 亿美元,即 $2B–$6B。下限假设优化仍捆绑在少数大框架中,上限假设独立服务基础设施形成市场。但原文未提供测算来源和具体输入,只能把它看作规模推演。
能拿来做什么
- 如果你在评估自部署模型的深度路由,先固定尾延迟目标,再比较端到端 tokens/s,并把路由和数据搬运全部计入。不要用「减少 25% FLOPs」直接推算服务器数量。
- 如果产品同时有离线批量任务和在线对话,把两类流量分别测试。原文讨论的收益依赖批次与带宽条件,一个场景的结论不能直接覆盖另一个场景。
- 如果模型用于 AI 编程,用实际代码任务检查最终质量,关注正确性和任务完成情况。逐 token 损失接近,仍不足以证明跳层没有损害关键推理。
- 如果你负责 Node 服务的配额与成本统计,接入采用动态路由的推理后端前,先验证相同 token 数请求的资源差异,再决定限流和报价是否需要调整。