Foundry 应用上线先理清身份与网络
文章将 Foundry Web 应用部署拆解为身份认证和网络出口设计,强调统一规划 Entra 注册、托管身份与代表用户调用的 OBO 流程。还讨论私有端点、DNS 和发布前的身份及网络检查。
AI 深度解读
Microsoft Foundry 应用部署成功,不能只看容器能不能启动、页面能不能打开。作者的核心判断是:上线前更该证明的是,应用以谁的身份运行、能否代表用户调用下游服务,以及请求能否沿着预定的私有网络抵达依赖。
这对做 AI 前端和 Node 后端的团队很实用:演示环境正常、预发布却频繁报错,问题可能出在身份和 DNS。原文给出了一套排查与验收顺序,但没有提供「Deploy as Web App」与自建 Backend Proxy 的完整对照。
网页能打开,为什么还不能算部署成功
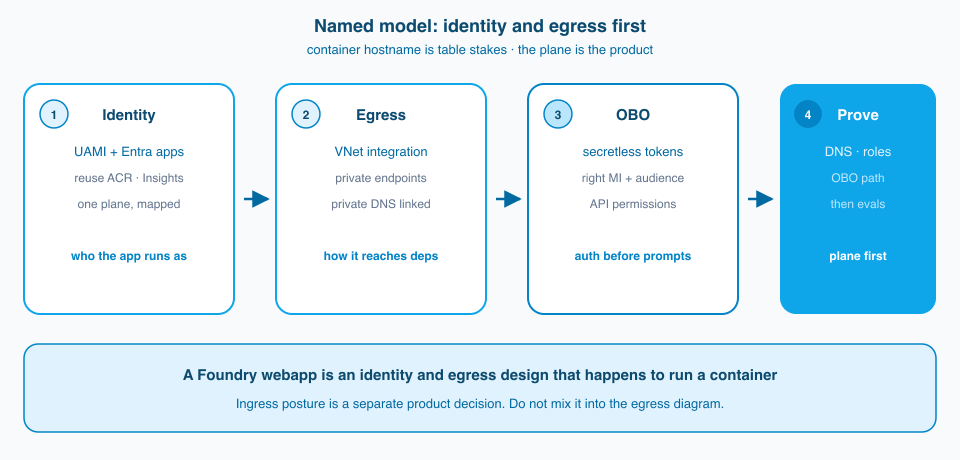
作者讨论的是用容器化 App Service 承接请求,再访问 Foundry、Search 和 storage 的架构。容器监听正确端口、域名和 TLS 配置完成,只证明用户能到达应用,尚未证明应用能调用下游服务。
他们强调两条需要一起设计的链路:身份链路决定应用以谁的名义访问资源,出站链路决定请求通过什么网络到达资源。提示词正确,也补不上这两条链路里的缺口。
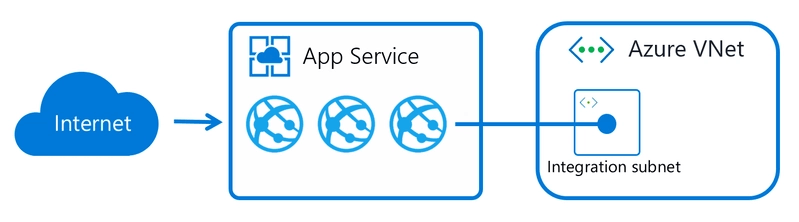
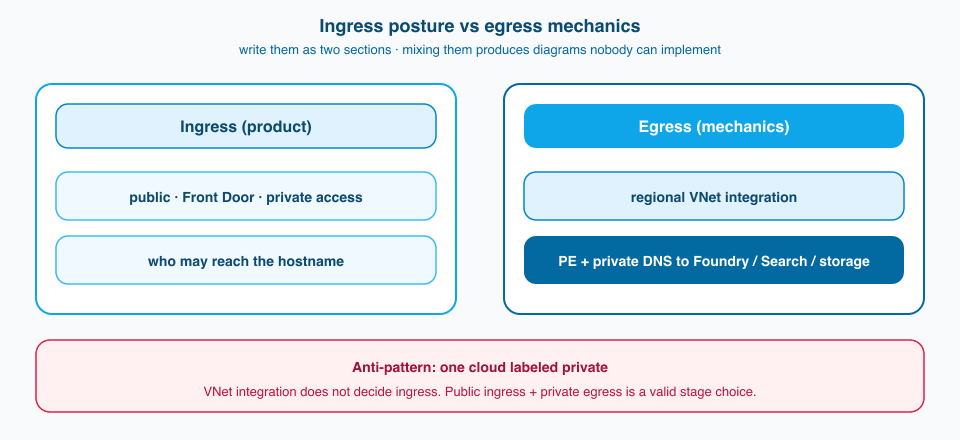
这里最容易混淆的是入站(ingress)和出站(egress)。入站回答用户如何访问应用:公网直达、经过 Front Door,还是使用私有访问。出站回答应用如何访问 Foundry 等依赖。
App Service 的区域 VNet 集成(regional VNet integration)服务于出站连接,给应用提供通往私有端点的路径。配置 VNet integration,不等于网站入口已经变成私有。
因此,公网入口配合私有出站,可以是某个阶段的合理选择。设计文档应分别写清入口策略和依赖访问方式,不能画一个标着「private」的云,就当网络方案已经完成。
无密钥调用,为什么仍然会报 401/403
原文建议围绕已有的 Entra app registration 和用户分配的托管身份(user-assigned managed identity)建立清晰的身份方案,同时复用 ACR、App Insights 等已有资源与模式,避免随手建立第二套身份体系。
这几类东西不能混为一谈。Entra 应用注册承载 API 的身份配置;托管身份供运行中的应用访问 Azure 资源;ACR 管理容器镜像;App Insights 接收观测数据。把它们连成一张清楚的关系图,才能知道请求失败时该检查哪里。
OBO(on-behalf-of)则涉及代表用户调用下游服务。大白话讲,用户登录应用后,应用还需要按规定携带用户身份继续办事。
作者强调,secretless OBO 需要匹配的运行时托管身份、正确的 token audience,以及经过验证的 API permissions 和 consent。audience 指令牌预期交给哪个接收方,不能只看「拿到了 token」就认定鉴权完成。
原文列出的典型症状是:令牌可以签发,资源调用却返回 401/403。此时应先核对身份、权限和授权配置,不能直接归因于「模型太慢」。
不过,原文没有给出 secretless OBO 的具体配置、令牌交换代码或逐项权限清单。它提供的是架构检查方向,不能当成可直接照抄的实现教程。
复用也有边界。作者后面补充,各阶段可以复用模式和资源类型,但实例应按需要隔离,并不要求共享同一组秘密或私有端点。跨阶段复用 Entra 应用时,还要维护好 redirect URI 和 audience,避免配置互相冲突。
预发布先验 DNS,再跑提示词评测
作者最有操作价值的建议,是调整上线验收顺序:
- 从应用运行环境验证,私有端点的 DNS 是否解析正确。
- 验证托管身份在 Foundry、Search 和 storage 上的角色分配。
- 用真实用户路径验证 OBO。
- 确认依赖出站连通、App Insights 能收到数据,再运行提示词评测。
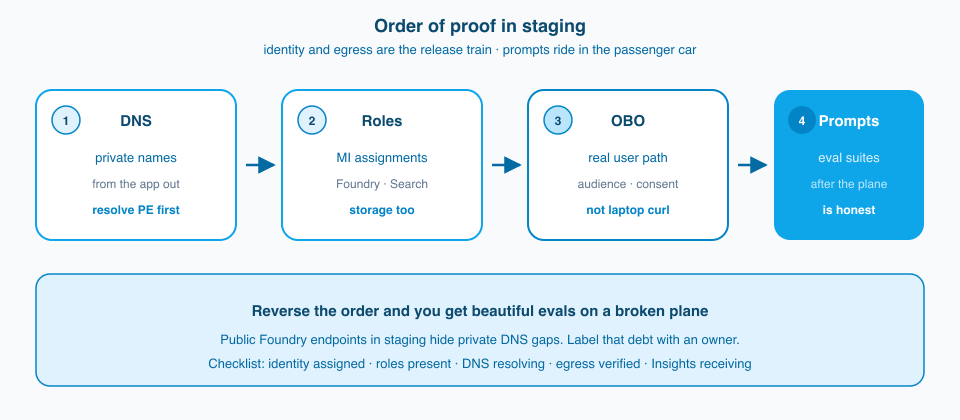
这里的重点是「从应用运行环境验证」。开发者电脑能访问公网 Foundry,只能证明本机那条路径可用。预发布使用私有端点后,App Service 集成子网实际使用的 DNS 必须能解析 Foundry、Cognitive Search 和 storage 的对应地址。
缺少私有 DNS zone 时,故障可能表现得像间歇性平台错误或 SDK 问题。只在本机反复运行请求,很容易绕开真正失败的路径。
同一份容器镜像能启动,不代表两个环境具备相同的调用条件。
作者因此把身份和网络的一致性排在 Node 补丁版本一致性之前。这是故障排查与上线验收的优先级判断。镜像可迁移,周围的身份、角色、子网和 DNS 配置仍要逐项核验。
如果预发布暂时使用公网 Foundry 端点,原文建议把这项例外写进架构决策记录(ADR),指定负责人。每个阶段还应在仓库里保留一张网络图,并列出应用注册、托管身份、DNS zone 的配置矩阵,让环境差异可以被检查。
我的判断
我认同作者把验收重点前移到身份和出站网络。对于依赖 Azure 身份与私有端点的应用,这套顺序能帮助团队判断:当前该修网络、查权限,还是调整模型调用。它尤其适合纠正「页面正常就算部署完成」的验收习惯。
但文章主要是经验性建议,没有给出故障样本、耗时统计或方案对照。作者认为严格检查能减少后续排障成本,方向合理,收益幅度却没有数据支持。用户分配的托管身份、私有端点和私有 DNS,也需要额外的平台知识与配置时间。
复用身份体系同样不能机械执行。原文反对的是缺少映射和管理的重复注册;具体环境是否共用注册,仍要结合隔离要求与维护方式决定。作者也承认,VNet integration 会约束扩缩容选择,但没有展开具体边界。
至于标题里的「是否需要 Backend Proxy」,正文没有充分回答。它没有比较两种方案的能力、成本与限制,也没有给出选择阈值。更准确的读法是:无论最终采用哪种承载方式,都要解释清楚身份和依赖访问路径。它还能用于提醒考虑 Foundry hosted agents 的团队:迁移运行时,并不会自动解决登录、角色和用户会话映射。
能拿来做什么
- 给现有 AI Web 应用补一张调用图,分别画出浏览器到应用、应用到 Foundry/Search/storage 的路径,并标明每段使用的身份与入口策略。
- 排查 Node 服务的 401/403 时,先核对运行时托管身份、token audience、API permissions 和角色分配,再决定是否检查模型调用参数。
- 把预发布验收改成可执行的检查顺序:应用内 DNS 解析、依赖连通、角色、真实用户 OBO、App Insights,最后再跑提示词评测。
- 在仓库维护环境配置矩阵,记录每阶段的 Entra 注册、托管身份、私有端点和 DNS zone;临时公网访问则写进 ADR,并明确负责人。