智能体跨会话记忆为何难做
模型调用本身不保留历史,智能体要跨会话继续任务,就得在每次调用时重新提供所需的用户偏好、历史信息和任务进度。文章讨论了生产环境中的记忆方案如何取舍,以及演示容易掩盖的难点。
AI 深度解读
AI 编程助手忘了改到哪个文件,和它隔了一周还在按旧约定写代码,是两种不同的故障。前者缺的是任务进度,后者缺的是一份能更新、能撤回的记录。把两种信息都塞进向量库,搜索时可能一起捞出来,却很难判断该听哪一条。
作者给的起步方案是用暂存笔记跟进任务,用可编辑文件保存长期约定,用原始日志回查历史,再按需引入向量检索。对做前端和全栈工具的人,这篇最实用的部分是四个验收场景。它们能测出助手是在积累有用信息,还是在积累过时答案。
先分清正在做什么、发生过什么、现在以什么为准
作者把记忆放在 Agent 的四个子系统里,和模型、工具、循环并列。模型调用本身是无状态的,跨轮延续靠应用把相关信息重新放进上下文。周一帮用户拟合同,周五接着改,系统得能找回对应客户、用户偏好的 30 天终止条款,以及法务标记需要修改的第 4 节。它们都跟当前任务有关,更新的时机却各不相同。
作者把这些信息分成三类。工作记忆存当前计划、最新工具结果和做到哪一步。情节记忆按时间记录发生过什么,比如上周二下午 3 点用户要求整理会议记录,助手交了哪版,用户随后改了哪里。语义记忆保留可跨任务复用的信息,比如用户希望 SQL 示例采用 PostgreSQL 语法,或团队按两周一个冲刺周期工作。同一句用户纠正可以出现在历史里,也可以触发一次偏好更新。历史回答「当时怎么说」,偏好回答「下次怎么做」。
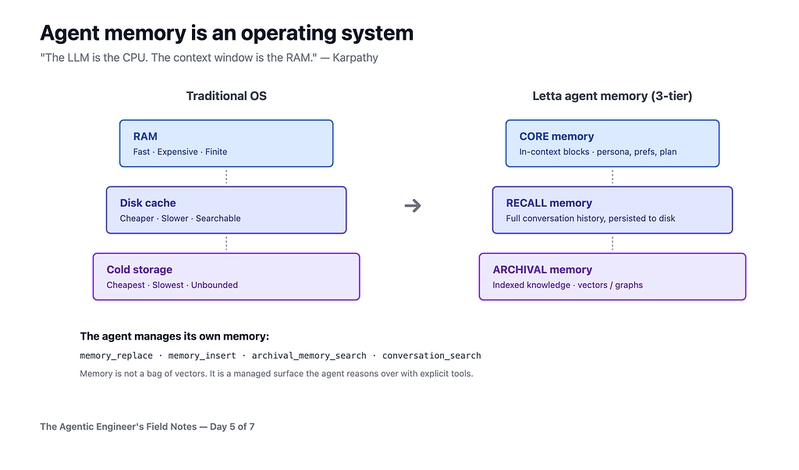
Letta 背后的团队曾发布 MemGPT。他们借用了操作系统的思路,把上下文窗口比作 RAM,再按访问方式安排三层存储。核心记忆把角色、偏好和当前任务的关键事实放进上下文。回忆记忆把完整交互历史持久化,需要时再查。归档记忆把整理过的知识存进外部向量库或图库。这套分层回答的是「存在哪、怎么取」,跟前面按信息用途分的三类大致对应。
为什么 top-k 搜到了相关内容,还是会给出旧答案
向量检索的 top-k 会返回与查询语义最相近的 k 条结果。它适合找类似的旧任务,比如「以前有没有讨论过类似的构建问题」。相似度只回答两段内容像不像,事实是否有效得由系统另外判断。
用户 3 月说偏好 Python,6 月说团队要切到 Go,两条都可能被搜出来。若后者确实更新了同一条项目约定,就该让新值生效,同时保留历史供回查。若前者是个人偏好、后者是团队标准,两条还可能同时成立,关键在于记录各自适用的范围。用户说「忘掉我说过的截止日期」又是另一回事,仅追加一句撤回说明,原来那条「截止日期是 3 月 1 日」仍能被检索到。
另外两种故障容易在单轮测试里漏掉。一年前「用户在用 v2 API」可能完全正确,今天就得重新确认有效性,这是时效问题。用户养了两只猫和用户从事医疗合规工作,也可能同时匹配到一段对话,但做合规任务时两者的重要性不同。作者把这四种情况用作验收题。遇到矛盾能否按适用范围采用新值,遇到撤回能否停止召回旧值,过时事实能否失效,以及相似度接近时能否优先选择对任务更重要的信息。
让文件管状态,让日志保留过程
作者建议先给当前任务一个暂存区。临时文件或上下文里一段结构化笔记都可以,只要每轮能读回子目标、中间决定和待办。对连续修改多个文件的编程助手,明确写下「改到哪、还欠哪项验证」,就能直接解决一批中途丢进度的问题。长期约定则适合放进人能读、能改、能精确搜索的文件。原文用 Claude Code 的 CLAUDE.md 举例,说明项目级约定可以跨运行复用。
历史会话可以存完整记录,按日期、用户或主题建轻量索引。有疑问时再拉取原文,必要时在读取阶段做摘要。常驻上下文则可以用递归摘要控制体积。把移出窗口的消息压成摘要,再定期把旧摘要压短,半小时前的过程保留细节,今天早上的工作保留摘要,上周的进展可能只剩一段。作者将 Letta 和 Claude Code 的 auto-compact 分别作为分层压缩和任务级压缩的例子。
Letta 还让 Agent 参与管理记忆。按原文列举的接口,memory_replace 和 memory_insert 编辑上下文里的记忆块,conversation_search 查历史对话,archival_memory_insert 和 archival_memory_search 写入和搜索外部归档。作者还提到在会话间运行的 sleep-time agents,可以审阅近期记录,把值得保留的内容转入长期记忆,给重复条目去重,再压缩旧摘要。模型能自主整理,也可能误删一条关键约定,所以记忆操作同样需要日志,方便追查错误从哪次写入开始。
我的判断
作者最有说服力的地方,是把记忆故障描述成可复现的状态变化。单看一次回答,很难察觉模型读到的是去年适用的 API 版本。把「先写入、再更新、再跨会话查询」连起来,才能看见系统究竟采用了哪条记录。对有明确字段的偏好,把当前值落在 Markdown 或已有的结构化存储里,通常比靠向量排序判断新旧更直接。向量索引的优势在于查找那些记不住标题、日期或关键词的旧内容。
原文把演示能覆盖的部分形容为容易的 20%,把剩下的部分形容为困难的 80%。这是经验之谈。作者给了生产观察和故障例子,没有交代样本规模,也没有给出文件、向量检索和分层方案的对照数据。尤其是让模型自行决定记住什么的做法,原文没有量化漏记、误删或摘要丢失关键约束的频率。单人项目可以手工检查 Markdown,到了多人共享的 Agent,同一条事实可能被多处同时修改,权限、版本和审计就得由存储层处理。
能拿来做什么
- 给跨多轮的 AI 编程任务留一份暂存笔记,记录正在修改的文件、已做决定和待验证项。续跑或上下文压缩后先读回笔记,再从未完成的步骤继续。
- 把长期有效的项目约定维护在
CLAUDE.md或等价的可编辑文件里。升级 API 或替换测试命令时直接更新对应条目,并写清约定适用的项目或目录。 - 给 Node 里的会话存储加一个按日期和主题查询的入口。平时只携带工作摘要,遇到需求反复或交接不清时再查原始记录。需要跨大量会话查找相似案例时,再加向量检索。
- 写四条跨会话回归用例,分别覆盖偏好更新、截止日期撤回、旧 API 事实过期和高低重要度信息同时命中。检查最终回答,也检查系统实际取回了哪些记忆。