大模型推理周报聚焦编译、缓存与抢占
周报汇总了 Together 用编译器替代手调融合内核、Gemma 4 对相同的全局 K/V 缓存只存一份,以及长输出服务改进请求抢占的进展。它也收录了 DeepSeek 在 Vera Rubin 平台上的吞吐测试。
AI 深度解读
11 月 11 日到 18 日的推理周报里,三项优化最容易被标题带偏。Together 用编译器替换手写大内核,Gemma 4 只存一份可共享的缓存数据,Stint 则让被抢占的长请求接着跑。它们省掉的开销各不相同,跑出来的数字也不能直接横比。
对接模型 API 的前端和全栈开发者,最值得看的是长会话怎么复用前缀,以及首 token 慢和生成中途卡顿怎么分开测。自建推理服务的团队,还可以据此判断该先动缓存、调度,还是 GPU 内核。
手写大内核能删到什么程度
GPU 内核(kernel)是提交给 GPU 执行的一段计算。把多个算子融合成一个大内核(megakernel),可以少发几次指令,也能减少中间数据在显存里的来回搬运。Together 给的例子是,GPU 上的计算只需 15µs,派发却花了 37µs。单个算子再快,派发开销也还在。
Together Compiler 让 Agent 自动改写和融合前向计算内核。团队报告,相对手写大内核基线,吞吐最高达到 1.7 倍,MiniMax M3.1-Flash 和 DeepSeek V4.1-Flash 分别跑到 1,111 和 1,205 TPS。另一组结果更适合作为工程起点。CUDA Graphs 配合 Programmatic Dependent Launch,在无需编写自定义内核的情况下,达到手写大内核性能的 98%。
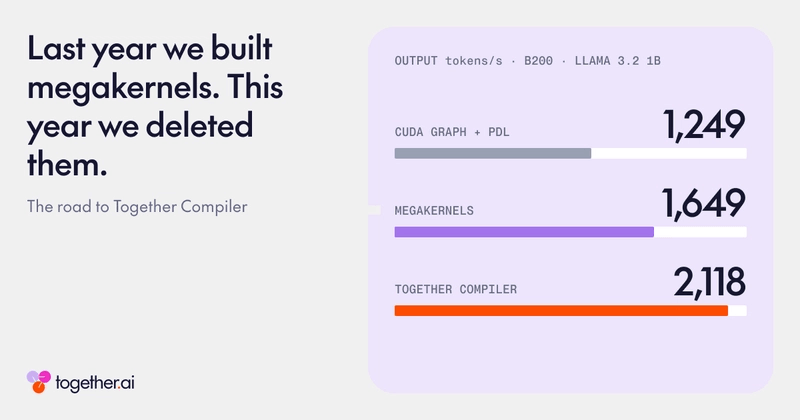
Nemotron 3.5 Transcribe 的语音识别实验给出了另一种取舍。连续批处理每一步接到的任务不同,团队先离线测出性能交叉点,再逐步选择常驻大内核或融合内核链。在 H100 SXM 上,峰值吞吐是调优后 vLLM 的 1.39 倍,低并发最高 4.39 倍。词错误率(WER)近似的情况下,400ms 的 p95 延迟预算内能容纳 8 倍并发。两组实验放在一起看,是否值得手写内核,得看负载跑在哪一段。
KV 缓存怎么省,取决于内存花在哪儿
模型每生成一个 token,都要用到前文的注意力信息。KV 缓存把已经算过的 Key 和 Value 留下来,供后续生成复用。Gemma 4 31B 的全局注意力层里,Value 来自对 Key 的归一化投影。模型报告曾给出最高 37.5% 的节省空间。vLLM 原型用两个重叠的步幅视图共享底层存储,沿用分页注意力内核,输出逐位一致。A100 上,32K–64K token 的解码 KV 内存降到原来的约 1/1.34–1/1.40,解码吞吐提升 24–38%。标题里的「减半」不能当成整个模型的实测结果。
MiSTiQ 走的是量化路线。它用 trellis 编码和 microscaling(MX)格式,通过束搜索挑出低精度表示,让注意力直接用低精度计算。约 1.25 有效 bit/元素时,Llama3、Qwen3 的困惑度和 GSM8K 指标优于论文对照方法。占用更低,但短报没交代其他任务上的质量损失和服务延迟。
Stint 处理的是缓存反复被丢弃的问题。显存紧张时,长输出请求可能刚恢复就再次被抢占,GPU 一直重算前文,用户却没收到多少新 token。Stint 把被抢占的 KV 快照放进 CPU 内存池,给等待时间设上限,并用解码隐藏状态估算剩余工作,辅助选择抢占对象。在 Qwen3-32B、H200 的实验里,相对重算,p99 单 token 耗时下降 50.7%,吞吐提高 12%。
推测解码省的是验证轮次,跨端还要算网络账
推测解码先拟出一串候选 token,再让主模型批量验证。草稿写得越长,验证通过时省得越多,猜错时也可能浪费更多计算。SpecSearch 用成本模型和小型 LoRA 预测器,针对负载和 GPU 联合选策略、草稿大小与精度。在 RTX 5090、H100、L40、MI300X 的报告结果中,吞吐是 vLLM 普通自回归解码的 2.01 倍、标准推测解码的 1.36 倍。它对未见 GPU 无需重新校准的结论,来自论文报告。
实际部署里,Inkling 2 Small 作为总参数 594B、激活 17B、最长上下文 1M 的 MoE 模型,混用 NVFP4 和 MXFP8 专家。原生草稿器 DSpark 每步猜 7 个 token,接受长度为 3.5,在 TP4 下单用户最高 630 tok/s。Kimi K3.1 Pro 用滑动窗口做草稿,vLLM 报告接受长度最高提高 30%。NVIDIA 给 Qwen3.8-27B 配的是 4B 草稿模型。
如果草稿在端侧生成、验证在云端,等待网络响应也会拖慢生成。SpecRelay 在等待验证时继续发送后续草稿树、丢弃过期请求,并按往返时延(RTT)选择端侧生成、chain-of-draft、完整推理或云端推测解码。额外 RTT 为 250ms、准确率相当时,SPROUT 和 OlympiadBench 的吞吐分别达到对照的 1.95 倍和 1.55 倍,只有 39–47% 的请求发往云端。
长会话首 token 慢,先看前缀算了几遍
编程 Agent 每轮都重发整个会话,若每轮新增内容大致相当,又几乎没命中缓存,累计预填充(prefill)工作量会随轮数近似平方增长。预填充就是模型先把输入读一遍,再开始输出。固定系统提示词、把工具定义放在稳定前缀之后、限制工具输出长度,都有助于控制重复计算。服务端还可以按 prompt_cache_key 路由,配合 PagedAttention、连续批处理、空闲会话 KV 下沉到 CPU,或通过 RDMA 拆分预填充和解码。周报引用的 SemiAnalysis 数据里,1.8% 的未缓存请求贡献了约 15% 的总支出,口径来自其样本。
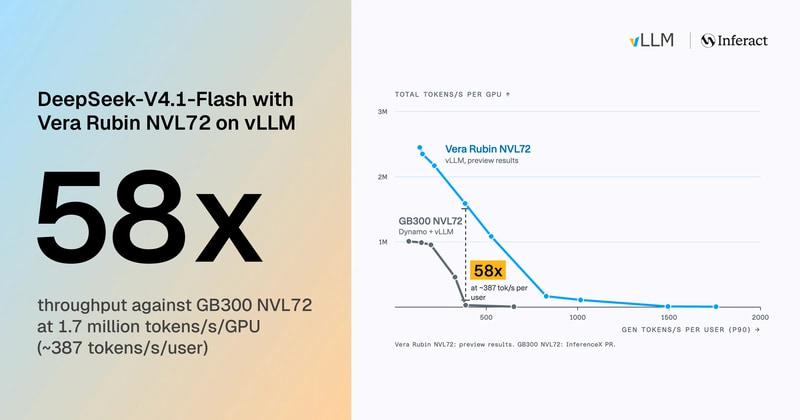
同一期的机架测试里,DeepSeek-V4.1-Flash 在 Vera Rubin NVL72 上相对 GB300 NVL72,标题给出 387 tokens/s 下 58 倍吞吐。vLLM 针对分段显存域和 FP4 指令改写内核,预填充(DEP2)和解码(DEP)分别省时约 28% 和 25%。张量并行解码在 batch size 1 时达到单用户 1,810 tok/s。机架 DRAM 和空闲 HBM 联合存 KV,高并发时前缀缓存命中率接近 97%。这些数字用了不同的指标和条件。
D-Day 汇总则报告,MiniMax-M3.1-Flash 在 Vera Rubin 上比 GB300 多出 10.2 倍的每芯片吞吐,DeepSeek V4.1-Flash 拆分编码、预填充和解码(EPD)后,P90 首 token 时间(TTFT)下降 44–47%。TPU v7 配 SGLang-TorchTPU 的小批量解码达到 3 倍,Unsloth GGUF Dynamic v3.1 报告准确率提升 5–10%。短报没有交代量化结果对应的完整任务和基线。
我的判断
我最看重 Gemma 4 那组逐位一致的结果。共享存储利用的是模型结构,量化则要另外验收质量。Stint 也给了清楚的重算对照,不过收益建立在长输出和显存压力上。短请求为主的团队,还得把 CPU 搬运和恢复的代价算进去。
我会把 Together 的 98% 当作值得复测的基线。周报没有给出普通团队用 Torch Compile、CUDA Graphs 和手写内核时的维护工时对照,哪条路维护成本更低仍是经验判断。注意力替换更要选好基线。NeurIPS 2026 的对照里,多项线性注意力收益对上现代 FlashAttention 后未能复现,精度较 softmax 低 2–10 个点,主要优势留在因果 LLM 推理的内存占用上。LARA++ 最高恢复到 softmax 精度的 99%,也增加了计算开销。
能拿来做什么
- 如果你在写 Node 编程 Agent 或 API 网关,把系统提示词和稳定工具定义放在固定位置,把每轮变化的内容放在后面,并在入会话前截断超长日志。用多轮任务对比缓存命中、输入计费和首 token 时间。
- 如果前端有流式输出,分别记录请求发出到首 token 的时间,以及后续 token 的到达间隔。再按上下文长度、输出长度和并发分组,看看慢在启动还是生成途中。
- 如果你维护 vLLM 服务,用真实会话回放长输出负载,记录抢占次数、p99 单 token 耗时和总吞吐。对接支持前缀缓存路由的引擎时,用同一批请求验证
prompt_cache_key是否提高了复用率。