69 张图实测图像模型成本与画质
作者用三类提示词测试多个图像模型及质量档位,根据返回的 token 用量核算单图成本,69 张图总计花费 5.63 美元。每种组合仅生成一张,结果适合作为成本与画质取舍的初步参考。
AI 深度解读
把图片生成的 quality 从 low 调到 max,账单可能涨到约 8.5 倍,成图却未必一眼更好。作者用 5 个模型、3 类提示词生成了 69 张图片,发现实际展示尺寸、模型选择和等待时间,往往比质量档位更影响使用体验。
这组测试适合拿来检查图片生成工具的默认配置:最高档到底解决了什么问题?不过,它只覆盖 1024×1024 图片,每个组合只生成一次,结论需要放回这个范围里看。
一张图多少钱,要从响应里的 token 算起
作者比较了 gpt-image-2,以及 GPT-Image 2.5、GPT-Image 2.6 各自的 Flare 和 Sunburst。提示词覆盖三种任务:带文字的爵士海报、带「UNION」标签的耳机盒产品照,以及有韩文招牌的冬夜炒年糕摊。
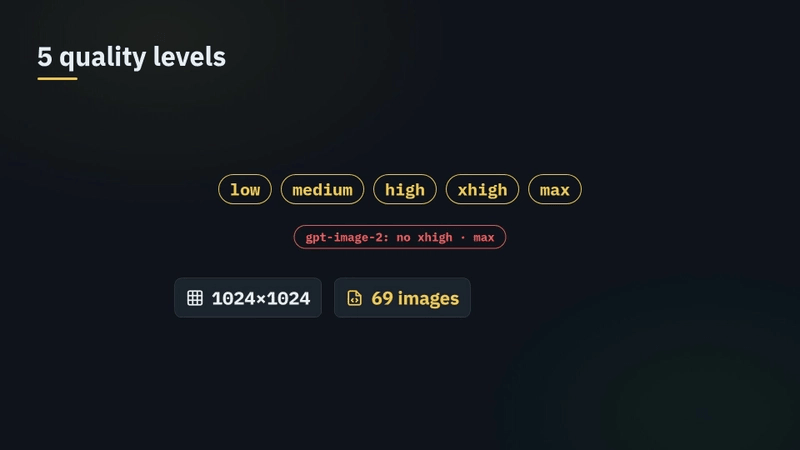
质量档位包括 low、medium、high、xhigh、max。gpt-image-2 不支持后两档,对应请求返回 400 错误,最终成功生成 69 张图片,总花费 $5.63。
作者指出,官方文档列出了 token 单价,却没有直接给出 GPT-Image 2.5、2.6 在 medium 及更高档位的单张价格。他按每百万输出 token $30、每百万输入文本 token $5,结合响应里的用量计算费用。
结果中,2.5 和 2.6 的 Flare、Sunburst 在对应档位价格相同,但跨版本差异很大:
- 2.6 从 low 的 $0.025 涨到 max 的 $0.211,约为 8.5 倍。
- 2.5 从 low 的 $0.006 涨到 max 的 $0.211,约为 35 倍。
- 2.6 low 的价格约为 2.5 low 的 4 倍。
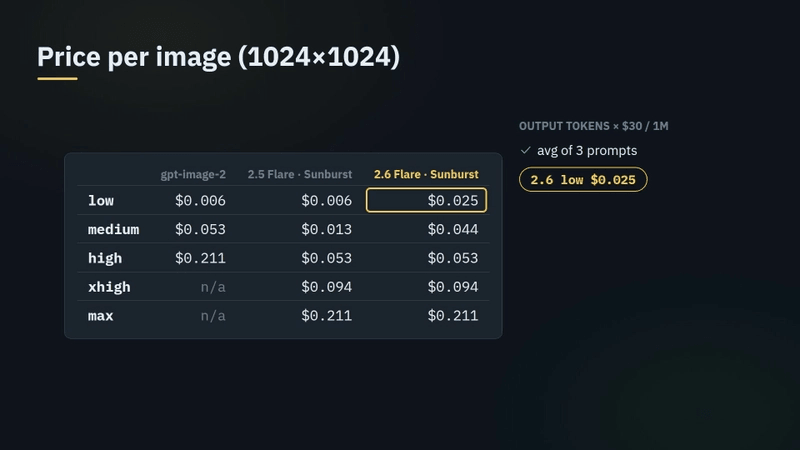
同叫 high,也不能当作同一价格档比较。gpt-image-2 high 每张 $0.211,2.6 high 每张 $0.053。给应用做预算时,只记录「用了 high」远远不够,还要记录模型和尺寸。
质量档位变高,改变的可能只是放大后的细节
作者把 2.6 Sunburst 的街边摊图片从 low 排到 max,观察到构图几乎没有变化,差异集中在针织物、蒸汽、木纹等纹理上。按原图 1:1 放大更容易分辨,缩略图尺寸下则很难看出来。
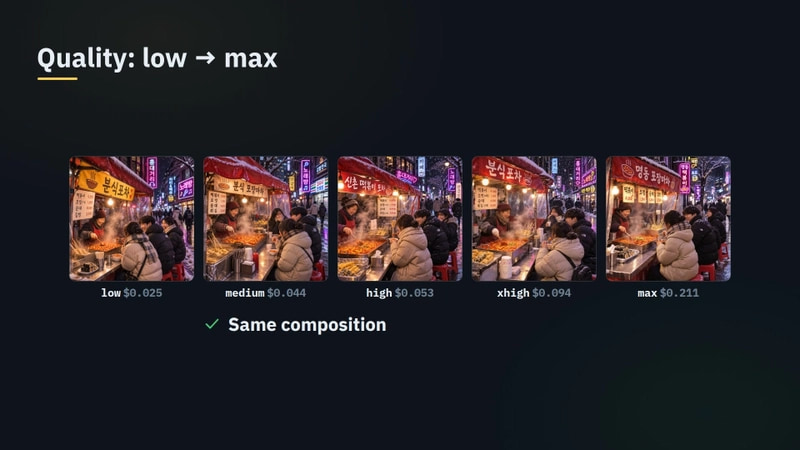
文字也没有呈现明显的档位差距。在这次测试里,low 已能正确生成英文、韩文,连小菜单板上的韩文也准确。
质量参数变高,不等于最终展示效果按价格同比提升。
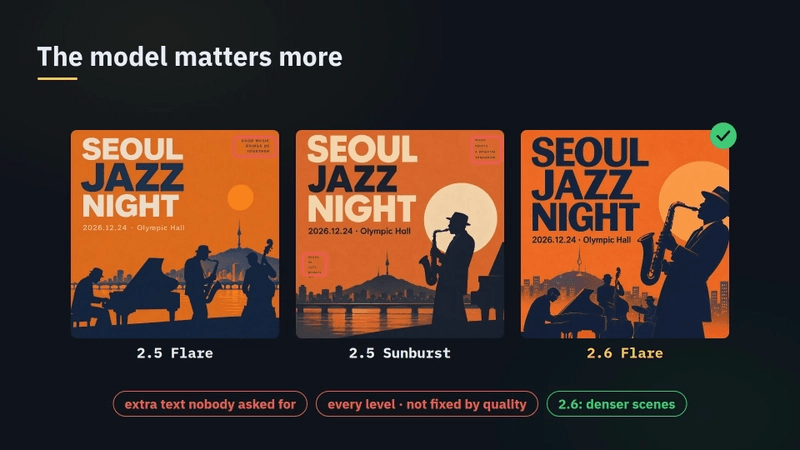
另一类问题更依赖模型选择。2.5 生成爵士海报时,擅自加入了「GOOD MUSIC BRINGS US TOGETHER.」等小字,提升质量档位也没有消除;2.6 的对应图片没有这些文字,但即使同为 low,场景也更拥挤。模型变化会影响内容取舍,不能只理解成清晰度升级。
作者制作视频缩略图时还遇到类似问题:提示词第一行用于解释的「8.5 times」,被 gpt-image-2 当成画面文字;原本用韩文写的「最高质量贵 8.5 倍」也出现了两次。他删掉解释句,加入「No other text」后重新生成。
这里能拿走的经验是:提示词里的说明文字也可能进入画面。加预算之前,先检查输入是否让模型误解了需要绘制的内容。
同价的 Flare 和 Sunburst,该怎么选
这次测试中,2.6 Sunburst 比 Flare 慢 2–5 倍。Flare low 的三次生成都在 7–8 秒,而两者在 low 下的文字准确性相同。
跨模型的等待时间差距更大:gpt-image-2 high 平均耗时 105 秒,2.6 Flare high 为 10 秒。这些时间来自三个提示词的平均值,适合参考,不能当作服务延迟承诺。
作者转述,OpenAI 将 Sunburst 的优势放在 medium 及更高质量,以及反复编辑时的一致性上。但他没有测迭代编辑,也没看出 medium 与 high 的清楚差别。因此,他提出「等待中的用户和多稿生成考虑 Flare,反复修改或保持角色一致考虑 Sunburst」,后半句仍属于选型判断,缺少本次实验验证。
还有一个有助于估算费用的观察:同一模型、同一档位下,不同提示词的输出 token 数相同。2.6 low 都是 824,medium 都是 1,449,简单海报和复杂夜景没有区别。作者据此怀疑,用量主要由分辨率与质量决定,但三个提示词不足以证明这是通用规则。
我的判断
这篇最有用的地方,是把「贵多少」和「看得出多少」放在一起。缩略图在放大后才显现的纹理提升,未必值得持续付费;文字准确、少添内容、生成更快,可能更贴近实际需求。
但「高档位收益不大」目前只是有限样本下的经验。每个组合只生成一张,随机差异就可能影响判断;原文也没有给出多轮重复、盲评或稳定性统计,不能据此宣布 low 普遍够用。
作者最后把频道缩略图工具从 gpt-image-2 high 改成了 GPT-Image 2.5 Sunburst low。这是他的取舍,不是测试证明的唯一最优配置。相比统一开最高档,更合理的是先用实际提示词试低档,再针对明确缺陷升级。至于 Sunburst 的编辑一致性,仍需单独验证。
能拿来做什么
- 给封面或缩略图工具选默认配置时,先用 low 生成,再按页面中的实际展示尺寸检查文字和主体;只有发现具体缺陷,才提高档位。
- 在 Node 图片生成服务里记录模型、quality、尺寸、响应 token 用量和耗时,按所用接口的计费规则估算单张成本,避免只看 token 单价。
- 新模型上线后,复用现有海报、产品图等真实提示词做对照;把首轮生成与多轮编辑分开评估,别用首图结果推断编辑一致性。