美团 LongCat-2.5 强化视觉与智能体编程
美团发布面向长程智能体任务的原生多模态模型 LongCat-2.5,总参数量为1.6万亿,每个 token 激活约480亿参数。新版在 LongCat-2.0 基础上强化视觉理解与智能体编程能力。
AI 深度解读
美团发布的 LongCat-2.5,重点是让模型在长时间、多步骤的智能体任务里持续把事情做完。它在 LongCat-2.0 基础上强化视觉理解与编程能力,总参数量 1.6 万亿,每个 token 激活约 480 亿参数,目标包括复杂代码库开发和完整项目构建。
对程序员来说,值得读的是它背后的工程链路:怎样把真实失败变成训练题,怎样判断代码真的修好了,以及长任务为什么必须连训练、缓存和推理一起优化。模型能力的宣传可以看,但更该看证据适用的范围。
写代码的能力,为什么要从失败轨迹里训练
长程任务的难点是连续做对一串决定:找到相关代码、修改实现、运行验证,再根据失败继续调整。前面判断错了,后面的工具调用可能都在扩大偏差。
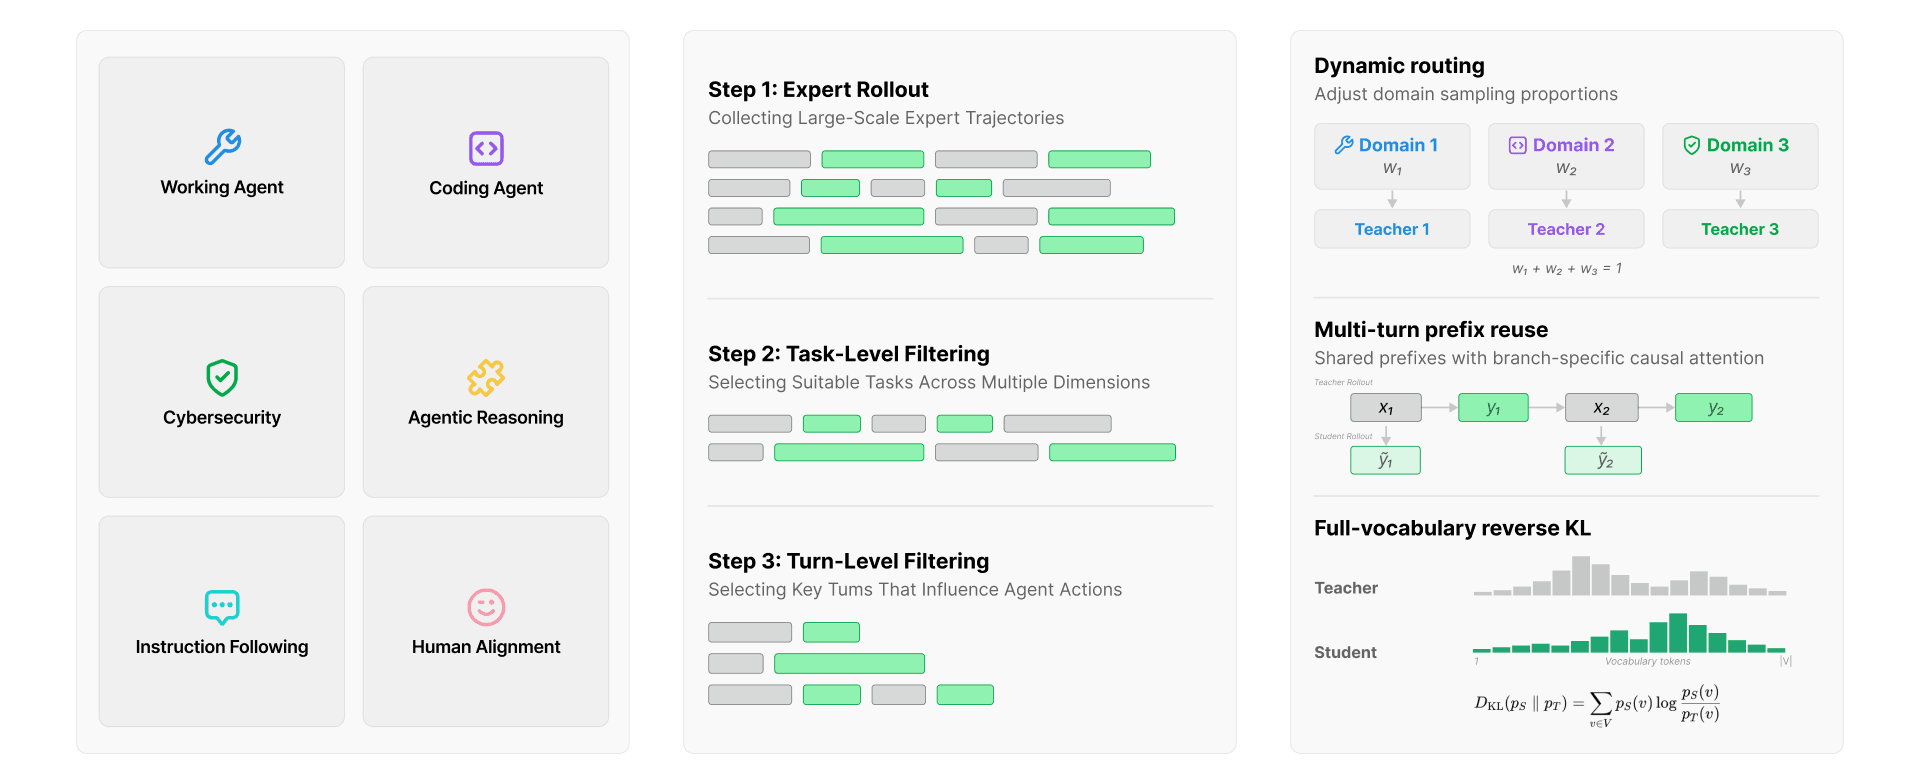
美团团队的做法,是增加长程轨迹数据,并搭建 Agentic RL,也就是让智能体在可交互环境里执行任务、根据结果接受强化学习。他们从 GitHub 公开仓库和内部代码任务出发,对筛选后的 PR、关联 issue 自动打标,生成运行环境和测试。
验证分两类:fail-to-pass(F2P)检查原先失败的用例是否通过,pass-to-pass(P2P)检查原先正常的功能是否仍然正常。前者看有没有修好,后者看有没有修坏。
训练题是否可信,取决于测试能不能准确覆盖任务要求。
团队会结合实时 rollout,也就是模型实际执行任务的轨迹,重新筛选数据;再分析假阴、假阳,修正 F2P 用例。这比单纯积累更多题目更有价值:测试漏掉要求,模型就可能拿着不完整的实现获得奖励。
长任务还存在耗时不齐的问题。partial rollout 会在凑齐训练批次后,中断并保存未完成轨迹,下轮恢复;过采样率随任务通过率调整,全对或全错的零梯度样本组会被过滤。代价是同一轨迹可能混入不同历史 checkpoint 生成的 token,因此还要裁剪新旧 logprob 差异,并调整各 token 的梯度贡献。
团队也专门处理 Reward hacking,即模型钻奖励规则的空子:训练环境断网、清除 git 历史和文件缓存,引入 LLM judge 检查轨迹,并惩罚重复思考、重复工具调用。跨任务和跨 Harness 的混合训练,则试图减少模型对某一种运行框架的依赖。Harness 可以理解为包住模型的工具、执行与验证系统。
视觉变成 token,怎样帮助模型处理界面
LongCat-2.5 将图像表示成多层级离散 token,让主干模型统一处理视觉与文本输入。原文称其在 Visual Coding 上表现出色,并支持创意设计和 3D 任务;但没有在文字中展开这些任务的具体完成标准。
视觉离散化沿用 LongCat-Next 方法:语义对齐编码器(SAE)先提取原生分辨率特征,再通过残差向量量化(RVQ)编码。可以把它理解为用多层视觉词表逐步描述图像,减少离散化时丢失的信息。
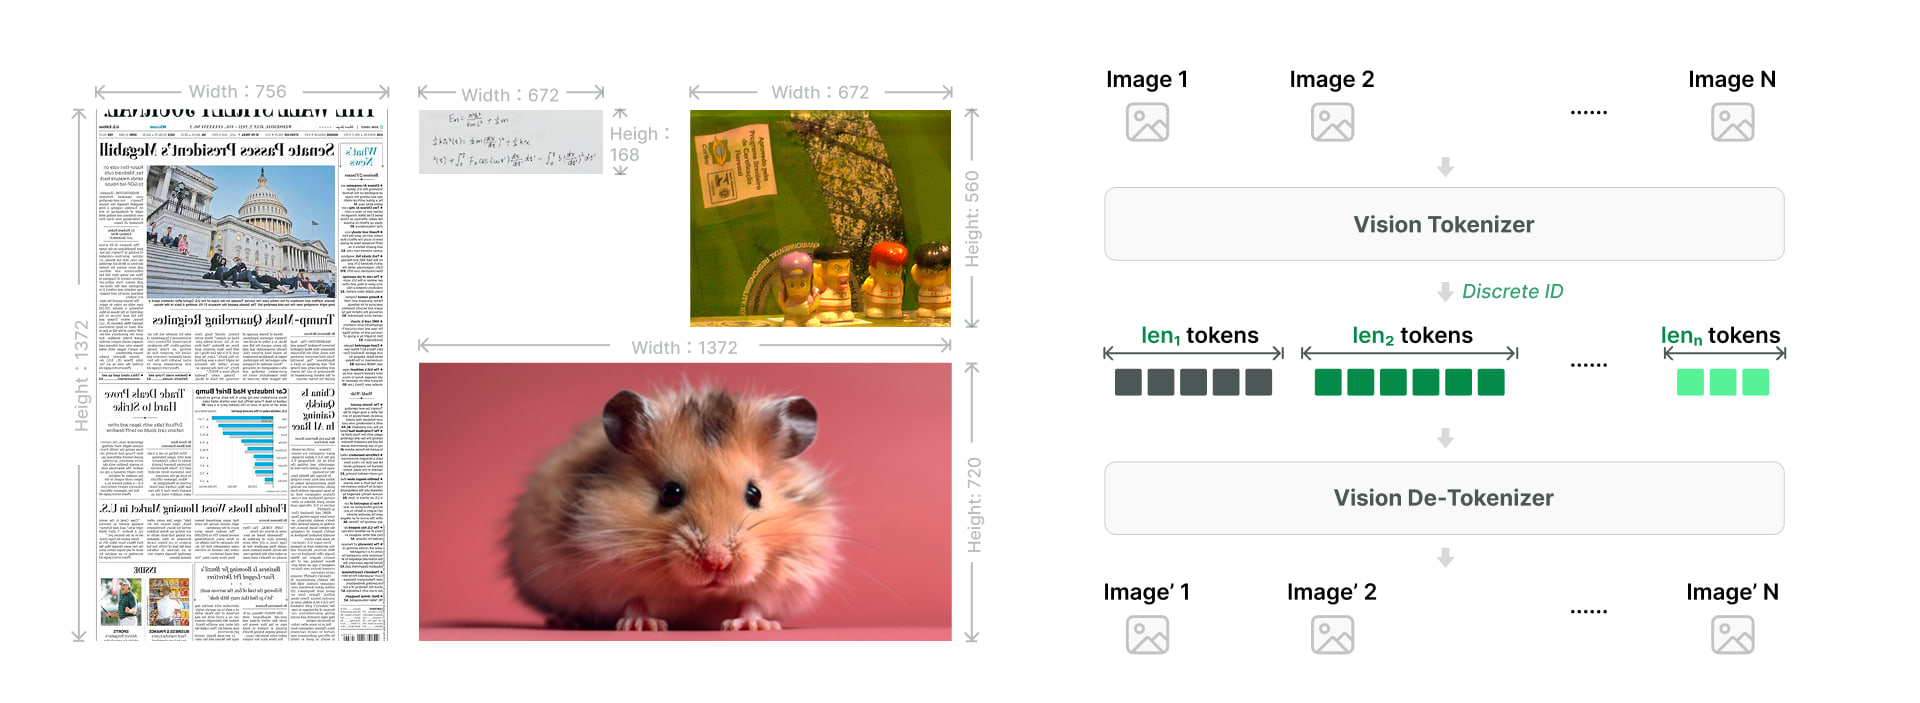
这个设计还有训练层面的收益。固定的 tokenizer 允许提前计算并缓存视觉 token ID,训练主干模型时不必在线运行视觉编码器。图像序列有多长也提前可知,更容易打包数据、分配负载。
视觉码本 embedding 与主干模型共同学习。团队在平均激活参数约 3B 的较小 MoE 模型上,用 t-SNE 展示视觉与文本 embedding 交织分布。这是初步验证,不能直接当成最终 1.6T 模型视觉能力的证明;二维可视化也不能替代任务评测。
此外,团队沿用 LongCat-2.0 的专家组机制,分别优化 Agent、推理和交互体验,再用 MOPD 将能力融入学生模型。领域专家根据学生在线采样结果,通过全词表 KL 散度提供学习信号。
这里的改动是把 per-turn prefix 进一步切成固定长度的 per-cut prefix,并限制学生自采样长度,减少单轮长回复越写越偏的问题。同一教师轨迹共享 prefill 计算与 KV cache,再结合 Tree Attention,减少重复计算。
长任务能否跑得起,还要看显存和数值一致性
原文很大篇幅都在讲基础设施。原因很直接:长轨迹既占缓存,又让训练等待更久;即使任务设计好了,也未必能经济地扩大训练规模。
面对国产算力单卡显存不足 80 GB 的限制,团队按超节点拓扑组织 FSDP、EP 和 CP,让主要通信尽量留在高带宽互联域内;通过混合词表并行、双重分片 FSDP、缓冲区复用和零拷贝通信降低显存开销。MoonEP 的动态专家复制则只在负载不均衡达到阈值后启动,避免均衡收益被通信成本抵消。
这些优化组合起来,在所测长序列 SFT 任务中,单卡吞吐较 DDP 基线提升 86%。它是特定配置下的系统结果,不能理解成所有训练任务都能获得同样增幅。
另一个问题是训推一致性。强化学习要比较 token 的生成概率,如果训练和推理因为并行切分、求和顺序不同而产生偏差,就会干扰学习信号。团队基于 IsoExec、GLM-5 和 XoRL,扩展 TP、DCP 支持,报告在接近无损的性能下,保持逐 token logprob 的 bitwise 一致,即数值按位相同。
长上下文 rollout 使用 Prefill/Decode 分离,并结合 HiCache、Mooncake 和容量感知调度减少缓存浪费。利用 LSA 奇数层复用前一偶数层 top-k 索引的特点,团队把部分 KV 放到主存并提前搬回,报告在 TPOT 无损时,Decode KV 缓存容量接近翻倍。所测负载下,P/D 实例配比 3:2 最优,这不是通用部署比例。
W4A4 则将专家权重和激活都量化至 4 bit,用原生 INT4 矩阵乘法执行计算,并基于 FlatQuant 优化精度。线上压测相对 W8A8 INT8 基线,prefill、decode 吞吐分别提升 43.3%、42.77%,TTFT、TPOT 分别降低 15.91%、19.72%;GMM 算子平均加速 1.73×。TTFT 是首个 token 的等待时间,TPOT 是后续每个 token 的平均耗时,两者都不等于完整任务完成时间。
我的判断
我认可这条路线:把编程能力放进环境、测试和持续执行里训练,比只看单轮答案更贴近实际开发。尤其是修正测试误判、限制奖励投机、跨 Harness 训练,回应了代码 Agent 常见的可靠性问题。
但证据要分层看。86% 和 W4A4 的数字有各自基线,属于系统性能结果;视觉融合有较小模型上的初步观察;长程任务与泛化提升则缺少足够的文字细节来复核。
原文展示了与 GPT-5.5、GPT-5.6-Sol、Claude-Opus-4.8、Claude-Opus-5 的对比,但所给文字没有交代完整评测配置、工具预算、重复运行次数和统计波动,因此不足以支持笼统的模型排名。
和给现有模型增加工具、检索、重试的做法相比,这套方案深入到了训练环节,也依赖大规模环境建设和基础设施投入。一般团队更容易复制的是验证方法。原文也未说明上下文窗口、API 参数、价格或开源情况,无法据此判断接入成本和私有部署条件。「注册认证赠千万 token、老用户加赠五百万 token」属于限时福利描述,不能替代成本评估。
能拿来做什么
- 评估代码 Agent 时,从自己的 Node 或前端仓库挑真实修复任务,同时准备 F2P 和 P2P 用例,检查需求完成与已有功能回归。
- 保存失败任务的工具调用、测试输出和环境信息,把能够复现的失败沉淀成评测集,持续检查更换模型或 Harness 后是否改善。
- 测试 Visual Coding 时,选有明确验收条件的界面任务,同时核对视觉还原、交互行为和代码能否运行,避免只凭截图观感判断能力。
- 比较模型服务时,分别记录首 token 延迟、生成速度和完整任务耗时,并记录工具调用次数;原文的推理吞吐提升不能直接换算成开发效率提升。