为编程助手添加跨会话偏好记忆
文章通过 ByteChef 模板演示持久记忆:智能体主动保存构建工具、Java 版本等信息,并在后续会话中读取。其采用 Spring AI AutoMemoryTools 对应的六种工具,将记忆存入数据库,并按项目部署和环境隔离。
AI 深度解读
AI 编程助手记得刚才改了哪个函数,却未必记得你上周说过「项目用 Gradle」。ByteChef 这篇文章讨论的就是这种断层:用 Chat Memory 延续当前任务,再加一层由 Agent 主动读写的长期记忆,让偏好和项目约束跨会话保留下来。
方案不复杂:索引、分类条目、六个工具,加上数据库存储和归属隔离。对程序员更有参考价值的,是它怎样划定记忆边界,以及怎样让错误记忆有地方可查、有办法修改。
跨会话记忆为什么要单独做一层
原文用两个例子说明问题:用户说过自己用 Gradle,新对话却收到 Maven 的 pom.xml;已经说明使用 Java 25,过一周又得到针对 Java 17 的变通方案。
在作者描述的机制中,Chat Memory 是当前会话的滑动窗口,容量满了就丢弃较早内容。它适合接住「现在补个测试」这样的连续指令,却不能承担下个月仍要生效的项目约束。
长期记忆则要求 Agent 主动判断:哪些信息值得保存,后续什么时候需要读取。
当前上下文负责接续任务,长期记忆负责保留经过选择的事实。
ByteChef 的「Remember coding preferences across chats」模板把这两层放进同一个 AI Agent。工作流只有三个步骤:New Chat Request 接收消息,使用 Anthropic 模型的 AI Agent 处理请求,Reply 返回回答。Chat Memory 服务当前对话,Auto Memory Tool 放在 Tools 槽位中负责长期记忆。
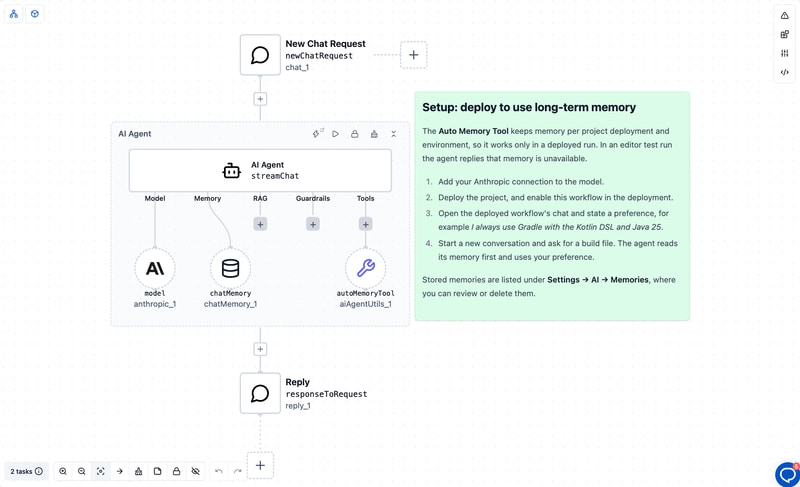
系统提示词规定了具体动作:每次对话开始,先读索引和相关记忆;用户声明构建工具、Java 版本、测试风格、回答长度等持久偏好时,立即保存并告知用户;后续回答主动应用这些偏好。
这里没有「接入存储就自动记住」的保证。存储提供能力,提示词负责告诉模型何时使用。
索引加分类条目,怎样避免每次读取全部历史
长期记忆由短 Markdown 条目和一个 MEMORY.md 索引组成。每条记忆带有 frontmatter,记录标题、可选描述和类型,正文保存事实。
下面是原文给出的示意条目,用来保存用户的构建偏好:
---
title: Build setup
description: Gradle with the Kotlin DSL, Java 25
type: USER
---

Always use Gradle with the Kotlin DSL and target Java 25.
要留意 type: USER:这里记录的是用户偏好;如果某个版本只属于当前项目,把它存成普遍偏好就可能扩大适用范围。
条目分为四类:USER 保存用户角色和偏好;FEEDBACK 保存纠正意见或用户认可的方法;PROJECT 保存当前工作的决策与约束;REFERENCE 保存指向外部系统的线索。
MEMORY.md 按每条一行、最新在前的方式列出条目。Agent 先浏览索引,再打开相关内容。ByteChef 自动同步索引,Agent 不需要手工维护。条目名称是扁平的,例如 build_setup.md,不支持文件夹。
这套组织方式的目的,是把「查有哪些记忆」和「读取具体事实」分开,减少每次翻阅全部内容的需要。不过,原文没有提供 token 消耗、检索准确率或延迟对照,不能据此宣称它已经证明了性能收益。
作者说 Agent 通过 Spring AI 的六个工具管理记忆,但提供的正文没有列出这六个工具的名称和参数。能够确认的是设计与格式保持兼容,无法仅凭本文还原完整调用接口。
为什么部署归属比存进数据库更关键
Spring AI 默认把记忆保存为磁盘上的 Markdown 文件。ByteChef 在其存储接口下面接入自己的记忆服务,默认写入数据库;自托管实例也可以通过 bytechef.ai.auto-memory.provider 选择文件存储。原文没有给出该配置的具体取值。
数据库让平台能够持久保存并集中管理条目,而真正决定「谁会读到这条记忆」的是归属规则。
自动化项目按「项目部署 + 环境」划分记忆。同一部署内的所有工作流和运行共享记忆,另一个部署或环境拥有独立记忆。嵌入式集成则按 integration instance 隔离,作者以此实现不同客户之间的记忆分离。
部署级记忆不能直接当成个人记忆使用。
假如多个用户共用同一部署,「我喜欢简短回答」是否应该影响其他人,就需要另行确认。原文展示了部署和集成实例边界,没有说明同一部署内部如何继续按用户隔离。
这也解释了为什么必须先部署再验证。编辑器测试运行没有部署归属,记忆工具虽然会加载,每次调用都会返回附带原因的「memory is unavailable」。微服务安装缺少 ByteChef server application,或者运行缺少工作流上下文时,也会出现不可用情况。
作者给出的验证步骤是:导入模板、连接 Anthropic、部署项目并启用工作流,在部署后的聊天里声明偏好,再开新会话索要构建文件。
截图展示了这个过程的结果:新请求没有提 Gradle 或 Java,Agent 先查询记忆,找到两个相关条目,再生成带 Java 25 toolchain 的 build.gradle.kts。
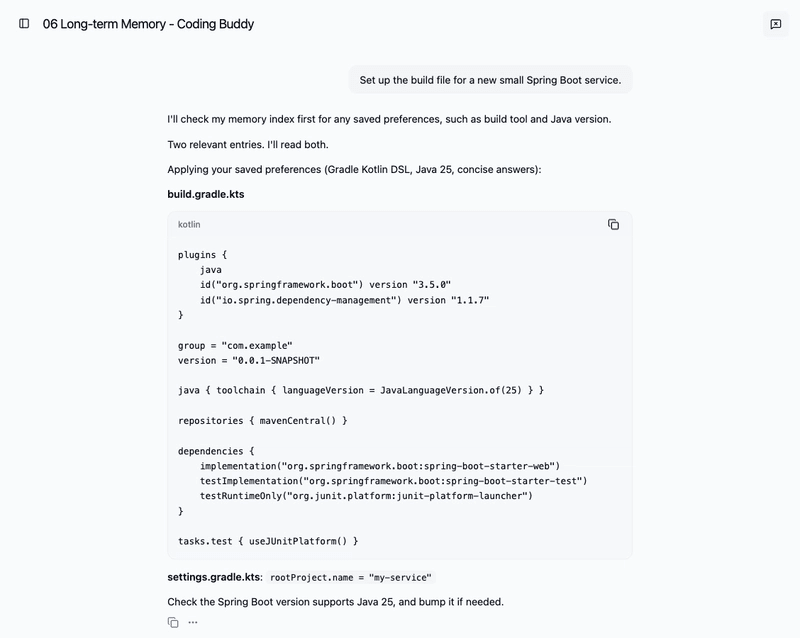
这是一次真实部署中的功能演示,能支持「跨会话读取成功」这个结论;它没有说明多次运行的成功率,也没有测试偏好冲突或记忆失效的情况。
我的判断
我认可这套方案把记忆做成可检查的数据。Settings → AI → Memories 支持按标题或描述搜索,按类型或归属筛选,并允许打开、编辑、删除条目。偏好变化时,用户可以直接修改,也可以告诉 Agent 更新。
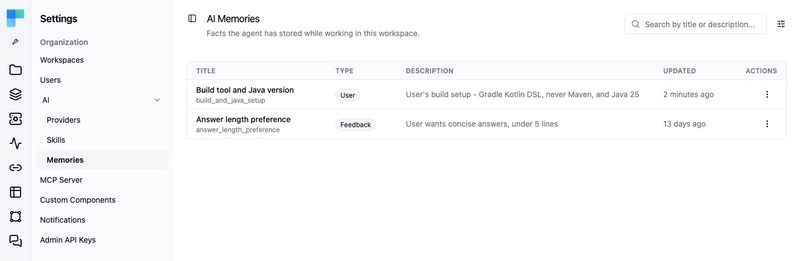
这比只承诺「助手会记住你」更容易排错:回答错了,可以检查它究竟保存了什么。编辑器测试不写入正式记忆,也给试验划出了清楚的边界。
但主动记忆依赖模型判断。临时要求会不会被当成长期偏好?新旧条目矛盾时听谁的?多个工作流同时修改怎么办?原文没有交代冲突处理、有效期和并发更新机制,也没有与固定项目规则、完整历史检索做对照。这部分应当视为设计经验,不能当成效果已被充分验证的结论。
对于必须遵守的构建版本和项目规范,我会优先保留明确、可审查的项目规则;对用户反复表达、允许调整的偏好,再考虑长期记忆。原文也区分了 Agent Skills 与记忆:前者提供大家共用的做事方法,后者保存用户和项目的具体信息,两者可以配合。
能拿来做什么
- 如果正在搭建 Java 编程助手,可以直接按原文路径验证:保存「Gradle with the Kotlin DSL、Java 25」,新开会话请求构建文件,同时检查记忆条目和生成的 build.gradle.kts。
- 为日常 AI 编程流程添加记忆时,先区分用户偏好与项目约束。回答长度可以归入 USER 或相关反馈,特定项目的技术限制应按 PROJECT 管理,并核对实际共享范围。
- 验证时至少覆盖新会话读取、偏好修改和记忆不可用三种情况。尤其在 ByteChef 中,应到部署后的工作流检查跨会话效果,编辑器测试不会写入正式记忆。
- 为记忆保留人工修正入口。使用 ByteChef 时,可以先通过 Settings → AI → Memories 检查错误事实,再判断需要修改条目还是调整提示词,避免只在聊天中反复纠正答案。