从故障复现到传感器溯源的SLAM排障方法
文章将漂移、跟踪丢失、地图畸变和位姿跳变等症状分类,强调沿原始传感器数据到定位结果的完整链路排查。调试应先稳定复现故障,并记录运动状态、环境、传感器配置及软件版本。
AI 深度解读
机器人跑了几分钟,地图突然扭曲,问题却可能出在更早的一帧数据上。STATERA Library《Localization, Mapping, and SLAM》第 23 章讨论的,就是如何沿着传感器、时间同步、运动估计和地图优化这条链路,追查 SLAM 的真正故障源。
作者的核心建议很明确:先证明输入可信,再讨论算法调优。它值得程序员读的地方,是把复杂系统里常见的「结果出错、原因藏在上游」拆成了一套可复现、可比较的排查流程。不过,原文提供的是工程方法,没有给出实验对照或收益数据。
地图出了问题,为什么不能直接改算法
SLAM 指同时定位与建图:机器人一边判断自己在哪里,一边构建周围环境的地图。定位结果会参与后续计算,因此小误差可能不断累积,最终表现为跟踪丢失、地图重影或位置突然跳变。
这些现象不能混成一句「定位不准」。作者要求先区分位置漂移、跟踪丢失、地图变形、位姿估计延迟、回环失败、优化振荡等症状,因为它们对应的排查入口不同。
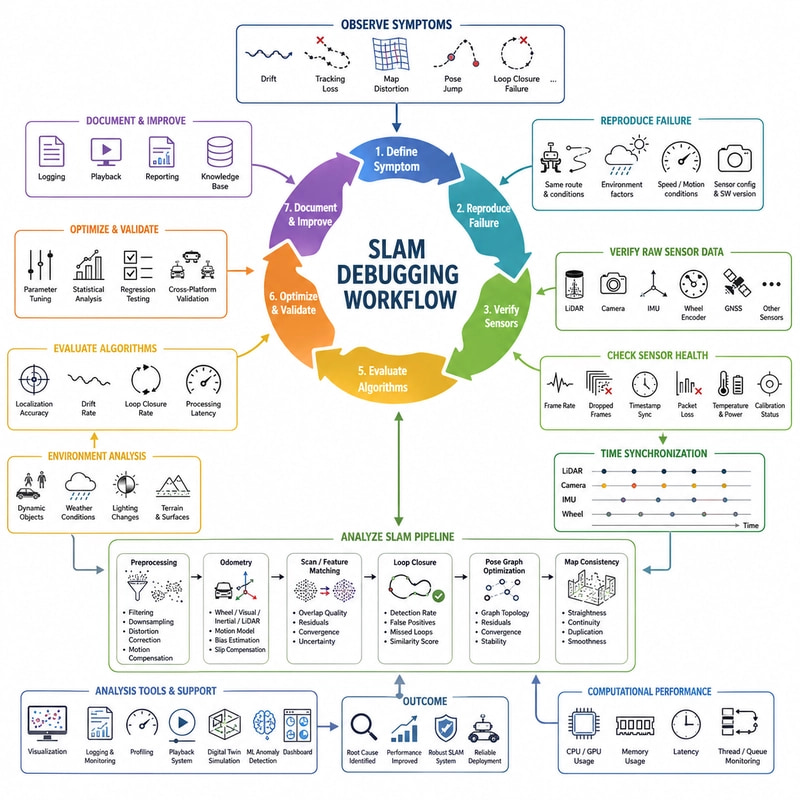
第一步是复现。记录机器人速度、运动方向、光照、天气、动态障碍物、传感器配置和软件版本,尽量在受控环境中重现故障。否则,改完参数后表现变好,也可能只是场景变简单了。
随后沿数据处理方向检查:
先验证原始传感器数据,再看滤波、降采样、特征提取和运动补偿;确认预处理没有破坏输入后,检查里程计,也就是根据连续观测估计短时间内的移动;最后分析扫描匹配、回环检测和位姿图优化。
这里有两个容易混淆的故障。错误回环是把不同地点误认成同一个地点,会给全局地图加入错误约束;漏掉真实回环,则会失去纠正累计漂移的机会。两者都可能让地图变差,但调整方向不同,不能只靠放宽识别阈值解决。
计算延迟也必须进入这条链路。算法算出的结果可能正确,却已经过时。作者建议同时观察 CPU、GPU、内存、线程调度、队列长度和通信延迟,避免把处理拥堵误诊为定位算法失效。
数据有输出,为什么仍然不能信
传感器检查的目标,不是确认「消息正在发」,而是确认数据在物理、时间和空间上都合理。
例如,LiDAR 配置为 10Hz,实际输出应接近这个频率;IMU 通常以 100Hz 以上运行。但平均频率正常还不够,短暂停顿、集中补发、重复帧和间隔抖动,都可能破坏连续运动估计。
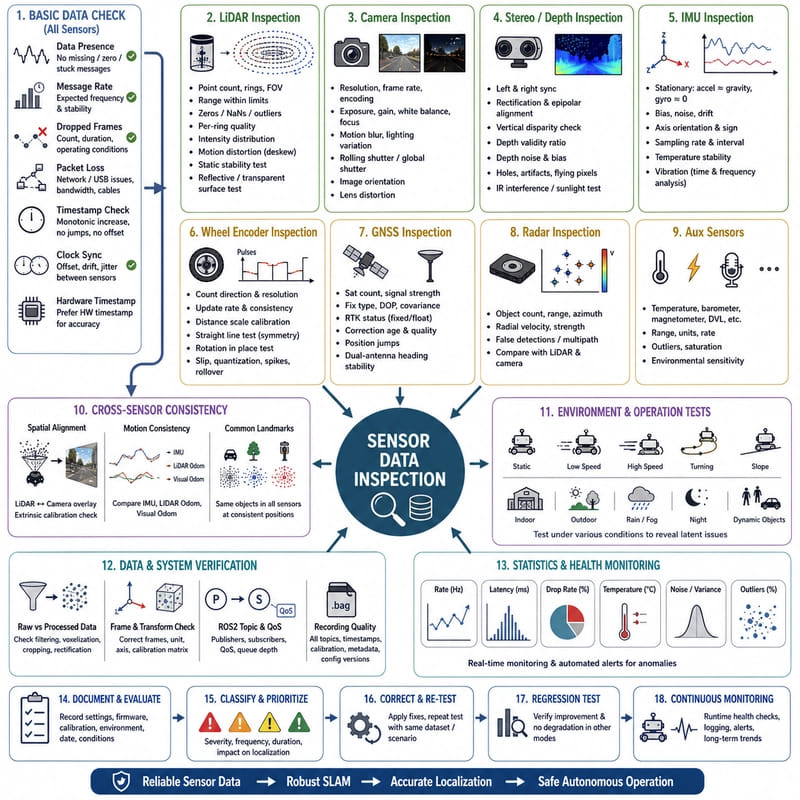
作者给出的检查思路很具体:LiDAR 点云先在传感器自身坐标系中显示,再检查坐标转换后的结果。机器人静止时,墙壁、地面和立柱应保持稳定。如果原始点云正常,进入地图坐标系后却出现倾斜或拉伸,就应追查坐标变换、标定、滤波和运动补偿。
运动中的异常还要单独分析。旋转式 LiDAR 的点并非同时采集,机器人移动过快时,墙可能看起来弯了。Deskew 的作用,就是把不同采集时刻的点按运动情况校正到共同参考时刻。墙面变弯不能直接判定为匹配算法有问题。
不同传感器也需要不同的物理参照:
IMU 静止时,加速度计应主要反映重力,陀螺仪应在噪声和偏置范围内接近零。轮编码器则需要把计数与实际移动距离对照,检查轮径、齿轮比、脉冲数和单位转换。GNSS 不能只看卫星数量,RTK 的 Fixed、Float、Differential、Standalone 状态也不能按同一可信度处理。
跨传感器对照能进一步缩小范围。例如把 LiDAR 点投影到相机画面:误差随距离增大,可以怀疑旋转标定;整体朝固定方向偏移,可以怀疑平移标定。这些是排查线索,还需要结合时间同步和安装状态验证。
软件侧同样可能丢数据。ROS2 Topic 要检查发布者、订阅者、消息类型、QoS 和队列配置。即使驱动正常,QoS 不匹配也可能让下游收不到预期消息。
时间戳正确,比时间戳存在更重要
时间同步是原文单独展开的重点。多个传感器各自测得准确,却把不同时间的观测融合在一起,系统仍然会失败。
时间戳必须说明实际测量发生在什么时候。
相机记录的是曝光开始还是结束?LiDAR 记录的是数据包生成还是整次扫描结束?IMU 记录的是采样时刻还是驱动接收时刻?字段名称相同,不代表时间语义相同。
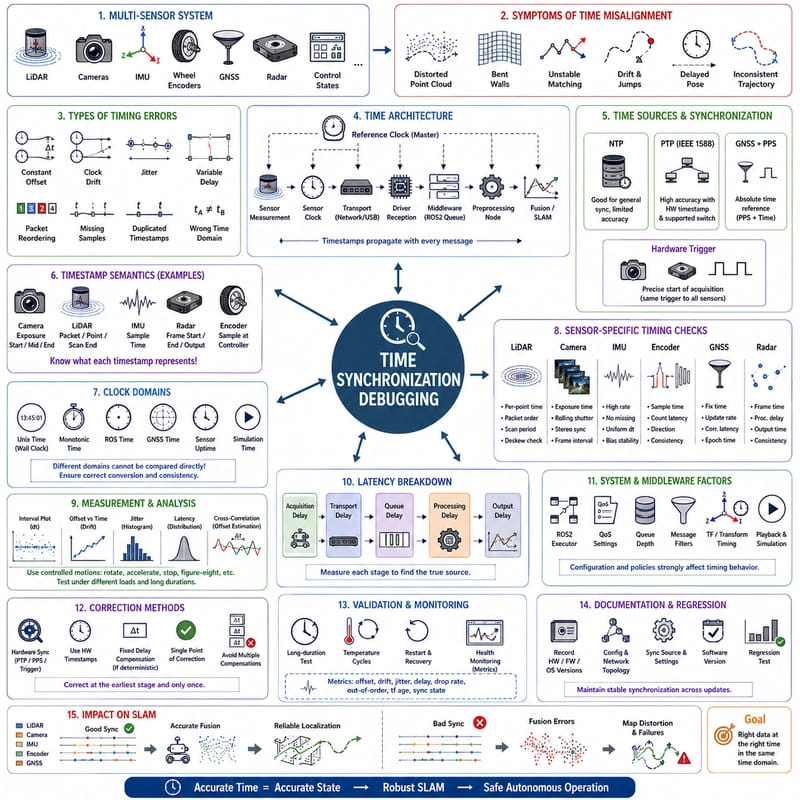
作者将问题分为固定偏移、时钟漂移、抖动、传输延迟、乱序、漏样和时间转换错误。固定偏移是一直快或慢一段时间;漂移则会随运行时间增加,可能开始正常,数分钟或数十分钟后才暴露。
100Hz 传感器的理想采样间隔是 10ms。如果实际采样间隔变成 8ms、12ms、15ms,积分和滤波就不能继续假定每次间隔相同。不过,调试时还要确认:变化发生在采样端,还是仅发生在消息到达端。
采得准但到得晚,与采集时间记录错误,需要分别处理。硬件时间戳能帮助识别真实测量时刻,但不能消除处理延迟;传感器内部时钟也必须正确同步或转换到系统使用的时间域。
Unix Time、Monotonic Time、ROS Time、GNSS Time、PTP Time 以及传感器自有时间,不能未经转换直接比较。Monotonic Clock 适合计算时间间隔,Wall Clock 便于跨设备对照日志,但可能因 NTP 校正或人工设置发生跳变。
ROS2 还要检查各节点使用 System Time、Steady Time 还是 Simulation Time。只有部分节点使用仿真时间,可能让回放数据被判为过期或来自未来。
所给原文在参考时钟选择处截断,没有完整说明具体同步方案,不能据此推断作者推荐了哪一种实现。
我的判断
这套方法最有价值的,是要求团队先建立可信证据:保留原始数据、记录中间结果、用相同输入比较修改前后,而不是看到地图变差就继续调参数。
但原文把「输入异常更常见」「时间同步是常见隐患」作为经验判断,没有给出故障样本统计,也没有提供采用流程前后的调试耗时对照。它适合作为检查框架,不能当作经过量化验证的故障概率排序。
「每次只改一个参数」有利于判断因果,却不代表参数之间没有相互影响。「所有故障都顺序走完整条流程」也偏理想化。已经有明确证据指向某个模块时,可以定点排查,再用回归数据确认影响范围。
回放同样有前提:记录必须包含必要 Topic、时间戳、Transform、标定文件和配置版本。真实运行与回放结果不同,本身就是线索,可能暴露对 Wall Clock、线程调度或消息顺序的依赖。
对前端和全栈读者,最接近原文的切入点是诊断工具与数据处理链路。没必要把机器人硬件检查生搬到普通业务页面,也不能据此得出 AI 编程工具能自动定位根因的结论。原文只把机器学习定位为异常发现、模式聚类和原因推荐的辅助工具。
能拿来做什么
- 如果你负责机器人诊断前端,可以把原始数据、预处理结果、估计轨迹和处理延迟放到同步时间轴上,让工程师能够对照故障前后的变化。
- 如果你用 Node 编写采集或回放工具,应分别保留测量时间与接收时间,并记录时间域、序号、配置版本和缺失消息,避免只保存解析后的业务字段。
- 给团队建立正常与失败两类回放样本,每次修改队列、滤波或同步逻辑后,用相同数据比较轨迹误差、处理延迟和失败情况,再补充不同运动与环境条件下的回归验证。