用 MCP 为本地智能体接入开发环境
指南介绍如何通过 MCP 统一连接外部工具与数据,让智能体读取代码、查询数据库、查看 Git 历史并运行测试。内容涵盖服务器选择、安全配置和首次连接,并强调按需获取仓库上下文。
AI 深度解读
MCP 想解决的是 AI 编程里最费手的环节:开发者反复找文件、贴代码、复制报错,模型却仍然拿不到当前项目的完整线索。作者的结论是,把本地 Agent 和统一的工具接口接起来,助手才能围绕真实仓库连续调查、修改和验证。
这篇指南值得读的地方,是把协议、检索、权限和接入流程串到了一起。不过,它提供的是架构解释和配置示例,没有性能对照实验。「接上工具会更好用」有道理,好用到什么程度,还得看具体实现。
本地 Agent,为什么不等于本地模型
先拆开三个容易混淆的概念:本地推理决定模型在哪里计算;本地 Agent 决定任务在哪里执行、访问哪些资源;MCP(Model Context Protocol)规定 AI 客户端怎样发现和调用外部工具、读取上下文资源。
所以,Agent 在电脑上读文件,背后的模型仍然可能运行在云端。也可以用 Ollama 运行量化模型,再连接文件系统和 GitHub MCP server。模型层和工具集成层分开后,更换模型就有机会复用已有连接。
作者用一个包含 250 个源文件,还有迁移、配置、文档和测试的项目说明检索的价值。排查认证请求失败,可能只需要控制器、中间件、数据库模型和一份配置。把整个仓库塞进去,会增加 token 消耗,引入无关信息,也容易混入已经过期的代码。
MCP 不会扩大上下文窗口,它让 Agent 可以按需找资料。
但协议只提供通道,不保证找得准。原文列出的语义检索方案,会扫描文件、识别语言,用 Tree-sitter 解析抽象语法树(AST),按函数、类、方法等单位切分,再生成 embedding,存入本地向量数据库。Agent 最后通过 MCP 搜索这些内容。
这样的切分比按固定字符长度截断更贴合代码结构。semantic-code-mcp、codesight-mcp、structured-repo-context-mcp 都被作者作为例子列出,但原文没有给出它们的检索准确率或横向比较。
隐私也要沿着数据流检查。本地索引可以减少外发代码,可只要推理在云端,客户端提交的片段仍会离开机器;本地 server 也可能调用外部 API。「本地」描述了某个组件的位置,不能单独证明整条链路私密。
MCP 怎样把工具接进一次开发任务
MCP 的架构有三层:host 是编辑器或桌面助手;client 是 host 内部负责连接某个 server 的组件;server 则提供文件、Git、数据库等能力。一个 host 可以维护多个 client 连接。
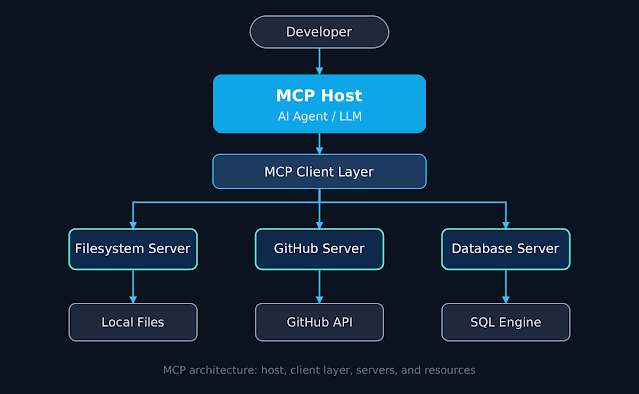
连接从 initialize 开始,双方交换协议版本、身份和能力,随后完成初始化通知。客户端通过 tools/list 发现工具,部分 SDK 将它封装为 list_tools(),再用 tools/call 调用。
下面这段请求解决的是「把一次读文件操作交给服务器执行」:
{
  "jsonrpc": "2.0",
  "id": 2,
  "method": "tools/call",
  "params": {
    "name": "read_file",
    "arguments": { "path": "src/main.py" }
  }
}
关键看 arguments.path:路径由请求传入,server 必须自行检查是否允许访问。模型没有直接操作文件系统,host、client 和 server 才是执行链路。JSON-RPC 2.0 用相同的 id 匹配请求与响应;通知没有 id,也不期待响应。
传输方式则有两种。stdio 由客户端启动子进程,通过 stdin、stdout 交换换行分隔的 JSON-RPC 消息,适合本地开发工具。日志必须写到 stderr,否则会污染协议流。它不开放网络端口,但仍以操作系统用户权限运行。
Streamable HTTP 适合独立部署或多个客户端共享的服务。客户端向 /mcp 发送 HTTP POST,服务端返回 JSON,或请求范围内的 SSE 流;请求示例包含 Content-Type: application/json 和 Accept: application/json, text/event-stream。
版本细节需要谨慎看待:原文称,Streamable HTTP 替代了 2024-11-05 修订版的独立 HTTP+SSE 传输,2026-07-28 规范又移除了 GET 流端点和协议级会话。这些是原文陈述,不能据此假定手头客户端已经支持,应核对双方实际版本。
MCP 还涉及 Tools、Resources、Prompts,以及传递目录边界的 Roots、请求模型补全的 Sampling、请求用户输入的 Elicitation。它也不自动提供长期记忆:对话状态在 host,索引和缓存可能在 server,重启后仍存在的数据要靠文件、SQLite 或向量数据库保存。
接入只需一份配置,权限却不能只靠配置
作者给出的入门路线,是约十分钟内在 Windows 上把文件系统 server 接到 Claude Desktop。先用 node --version、npm --version 检查环境,再打开 %APPDATA%\Claude\claude_desktop_config.json。PowerShell 命令是 notepad "$env:APPDATA\Claude\claude_desktop_config.json"。
这份配置指定启动命令,并把可访问范围限制到一个项目目录:
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-filesystem",
        "C:\\Users\\Developer\\Projects\\MyApplication"
      ]
    }
  }
}
重点看 args 最后一项,以及 JSON 中双写的反斜杠。npx -y 会在需要时下载并运行包;可复现环境应固定经过审查的版本,原文没有指定版本号。完全退出并重启 Claude Desktop 后,可以让它列目录、定位入口、读取指定文件。失败时再查 npx --version、目录权限、JSON 语法和连接日志。
能读文件只是第一步。README、代码注释、issue、数据库记录都可能夹带提示注入,诱导 Agent 读取环境文件或外发凭证。把检索内容标为不可信有帮助,但真正的边界仍要由执行环境强制落实。
模型答应遵守权限,不能替代服务器拒绝越权请求。
原文建议分开只读能力和受限写入能力,独立验证参数,对敏感操作要求批准,并限制工具调用次数、重试、运行时间和调用频率。隐藏工具也不够,如果 server 仍接受对应请求,权限漏洞依然存在。
选型同样要区分示例与产品。modelcontextprotocol/servers 是教学参考;早期 GitHub、PostgreSQL、SQLite 参考实现已归档。GitHub 自己维护的 github/github-mcp-server 支持可配置工具集和只读模式,原文也给出了 Docker 镜像 ghcr.io/github/github-mcp-server 的接入思路。
凭证应经环境变量或凭证管理器注入。示例中的 GITHUB_PERSONAL_ACCESS_TOKEN 使用 ${GITHUB_PERSONAL_ACCESS_TOKEN},但变量插值是否生效取决于 host。网络部署还要处理 HTTPS、认证、逐操作授权、Origin 校验和审计;Registry 收录并不代表安全认证。
我的判断
我认可作者把「按需检索」放在「更大上下文」之前。调试需要的是当前、相关、可追溯的证据。对于跨文件问题,让 Agent 自己读取依赖和测试结果,确实能减少人工搬运信息。
但原文没有展示一场完整调试,也没有给出成功率、耗时或 token 成本。小型本地模型接上工具后能改善多少,目前只能算有条件的经验判断。索引漏更新、工具返回噪声、模型选错调用,都可能抵消收益。
N × M 连接变成约 N + M,解释了标准接口的复用价值,却不是开发工时公式。认证、权限和部署仍然各有成本。已有脚本能解决的单一任务,未必值得额外部署 server;需要跨客户端复用工具时,MCP 的价值才更清楚。
还有一个容易混淆的边界:Roots 表达客户端关心的目录,操作系统权限和 server 校验才负责真正限制访问。把这几层混在一起,很容易得到一个界面上受限、执行时仍然权限过大的 Agent。
能拿来做什么
- 给前端或 Node 项目做首次接入时,只授权一个项目目录,先验证列目录、找入口、读指定文件,再考虑添加修改和执行能力。
- 排查跨文件问题时,让 Agent 先找相关函数,再检查依赖、Git 历史和测试输出;如果频繁找错位置,应先检查检索与索引质量。
- 接 GitHub 或数据库前,检查实现维护情况、协议版本和实际权限,从只读模式或只读账号开始,并确认返回内容是否包含敏感信息。
- 使用本地 Agent 加云端推理时,明确哪些代码片段会被提交;同时设置调用上限、超时和取消机制,避免任务在搜索、修改、测试之间反复循环。