Kimi 托管智能体的权限与成本边界
Kimi Hosted Agents 托管会话历史、隔离沙箱、执行调度与恢复,但自定义工具仍由客户端执行,业务鉴权需要接入方负责。沙箱按每小时 0.072 元计费,模型与插件费用另计,默认公网访问和工具放行也需显式收紧。
AI 深度解读
Kimi Hosted Agents 想接走的,是 Agent 接入模型之后那摊工程活:保存历史、运行沙箱、调度任务,以及故障后的执行恢复。它适合长时间运行的异步任务,但托管范围有边界,自定义工具和业务授权仍由接入方负责。
原文最有用的提醒有两个:¥0.072/小时只是沙箱价格,默认配置也不能直接当作生产策略。评估是否迁移,需要一起检查费用、权限、断线恢复和文件交付。
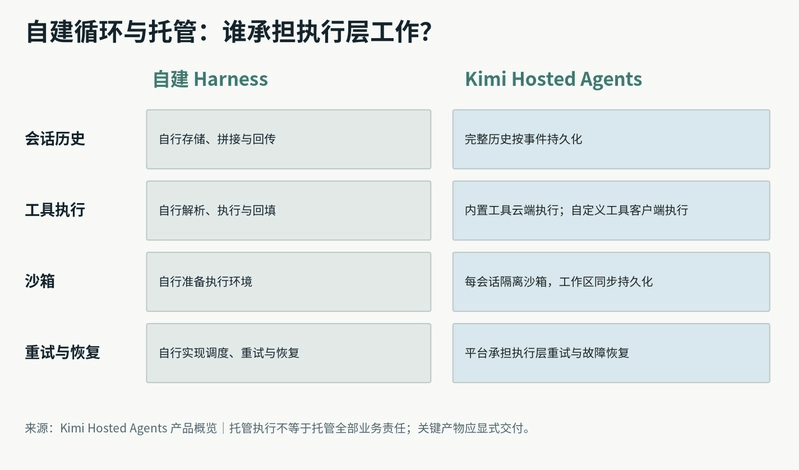
托管接走了哪些工作,哪些还得自己管
原文引用的发布页更新于 2026-11-05。Kimi 将 Harness 做成云端服务,这里的 Harness 可以理解为包在模型外面的执行框架:负责记录过程、运行工具、安排执行和处理故障。
它提供事件历史持久化、隔离沙箱、执行层重试与调度,并支持平台故障后的接管恢复。面向的场景包括内部监控、运维响应,以及投研、客服等长程任务。
托管运行时,不等于托管业务责任。
内置工具在云沙箱执行,自定义工具仍由客户端执行。接内部系统时,鉴权、参数校验和结果回填都要自己做;平台恢复执行,也不能保证业务写操作不会重复发生。
模板同样不能替代业务验收。新闻页列出首批 8 个金融 Agent 模板,产品概览列出 12 个官方模板,还覆盖游戏、运维和社群运营。资料口径不同,原文没有给出数量变化的时间线。
如果团队必须逐轮决定模型输入和调度,模型推理 API 仍是合理选择。原文用 Twinkle Model 的 OpenAI 兼容接口演示了最小文本往返,需要先安装 openai:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://big-model.smart-agi.com/v1",
    api_key=os.environ["TWINKLE_API_KEY"],
)
messages = [{"role": "system", "content": "只依据提供的材料分析,缺失信息标为未查到。"}]
for question in ["列出事故排查所需材料,暂不执行工具。", "补充哪些动作需要人工确认。"]:
    messages.append({"role": "user", "content": question})
    response = client.chat.completions.create(
        model="kimi-k3.1-pro",
        messages=messages,
    )
    reply = next(iter(response.choices)).message
    messages.append(reply.model_dump(exclude_none=True))
    print(reply.content)
要看的是 messages.append(...):历史由应用维护。这段代码没有沙箱和工具执行,也没有接入 Kimi 的 sessions 或 environments API;模型名须以上架情况为准。
¥0.072/小时,为什么算不出任务总价
原文给出的计费公式是:
沙箱运行时长 × ¥0.072/小时 + 模型推理费用 + 插件调用次数 × 对应单价。
每个会话使用独立云沙箱,模型 token 按所选模型计费,插件按次计费。所以,1 小时 × ¥0.072 = ¥0.072,只能说明沙箱这一项。
原文没有查到可稳定提取的插件名单和单价,也未提供实际用量。优先观察 token 和插件调用频度,是作者的排查建议,并非测出来的成本占比。
停止计费也有条件:所有线程的模型请求及后续执行结束,会话进入 idle,才停止累计沙箱费用。取消当前轮次后仍可继续,归档则是不可逆的只读终止。产品里的「停止」按钮必须明确对应哪种动作。
权限和恢复,客户端必须补上哪些环节
创建会话时,要通过 environment_id 绑定环境。省略 networking 会默认使用 unrestricted,允许访问公网,同时拦截通用安全黑名单。生产环境建议配置 limited 和 allowed_hosts。
主机规则不接受 URL scheme 或路径;*.example.com 不包含根域,不带端口时只放行 80 和 443。更关键的是,这些规则只管沙箱进程出站,不影响平台层的 Web Search、Fetch。MCP 服务和包管理器另有默认关闭的开关,需要分别配置。
工具默认启用,permission_policy 默认为 always_allow。可能改变外部状态的工具宜设为 always_ask,不用的设为 enabled:false。前端还得提供允许或拒绝的交互,否则任务会停在用户看不到的确认环节。
恢复流程也需要客户端配合:
- 先订阅事件流,再发送
user.message;创建会话本身不会启动执行。 - 保存最后一帧的
id:,断线后通过cursor或Last-Event-ID续接,并对展示事件去重。 - 自定义工具的写操作保存业务执行凭据,恢复后核对结果,再决定是否重新提交。
文件也不能只看沙箱里是否存在。/mnt/agents/ 会同步到持久化工作区,但退出前尚未同步的最新内容可能丢失。关键产物应通过会话文件接口取回,或用 save_artifact 显式交付不可变版本。
我的判断
这篇对责任边界的提醒成立。长程任务确实需要处理历史、调度和恢复,托管服务把这些能力集中提供,有评估价值。
但原文没有自建与托管的成本、成功率或维护工时对照,也没有完整任务实测。它支持「可以减少一部分基础设施工作」的判断,尚不足以证明迁移后一定更省钱、更稳定。
自建循环保留了每轮输入与调度的控制权,代价是自己承担执行工程。托管是否合算,要看团队真正卡在哪一层。另一个阅读前提是,作者运营 Twinkle Model 中转站;示例体现其接入方式,不能作为 Kimi 托管能力的验证。
能拿来做什么
- 接入前列出工具清单,标明云端或客户端执行、是否写入业务系统、是否需要人工确认,逐项落实鉴权与校验。
- 给前端补齐确认、取消、归档和断线恢复交互,把恢复事件流与重新提交任务区分开。
- 用一条真实异步任务记录沙箱时长、模型 token、插件次数和产物取回结果,再评估迁移;环境和智能体版本在创建会话时固定,更新后还要验证新会话。