让 AI 网页测试同时核对后端结果
Vedha 是基于 Playwright 的开源 MCP 服务,教程展示如何接入 Claude Code、Cursor 等客户端,让代理操作真实浏览器并检查服务端结果。配置要求显式限定可访问域名,目标是避免仅凭页面成功提示判定测试通过。
AI 深度解读
AI agent 能把结账页面点一遍,却未必知道订单是否真的保存了。Vedha 想解决的就是这个缺口:页面显示成功还不够,测试还要检查请求和服务端状态,最后把验证过的操作变成能放进 CI 的 Playwright 测试。
作者给出的接入流程约需 5 分钟,最有价值的部分是区分「已验证」「失败」和「结果未知」。对正在让 AI 写端到端测试的团队,这比多生成几条点击脚本更值得关注。
页面显示成功,为什么测试还要判失败
Vedha 是基于 Playwright 的开源 MCP server,可接入 Claude Code、Cursor、VS Code 等 MCP 客户端。它在浏览器操作之外,还检查操作产生的请求,以及能够回读的服务端状态。
作者用一个结账流程演示差别:在 localhost:3000 为 Ada 下单,页面出现 Order placed。正常情况下,POST /api/orders 返回 201,Vedha 再回读 /api/orders,确认订单存在,才报告 verified。
故障版本则让同一个接口返回 500,前端仍展示成功文案。此时,文本断言虽然通过,Vedha 的整体结果仍是 failed (health_check_failed),并提醒 agent 不要宣称成功,除非后续步骤确实修复了问题。
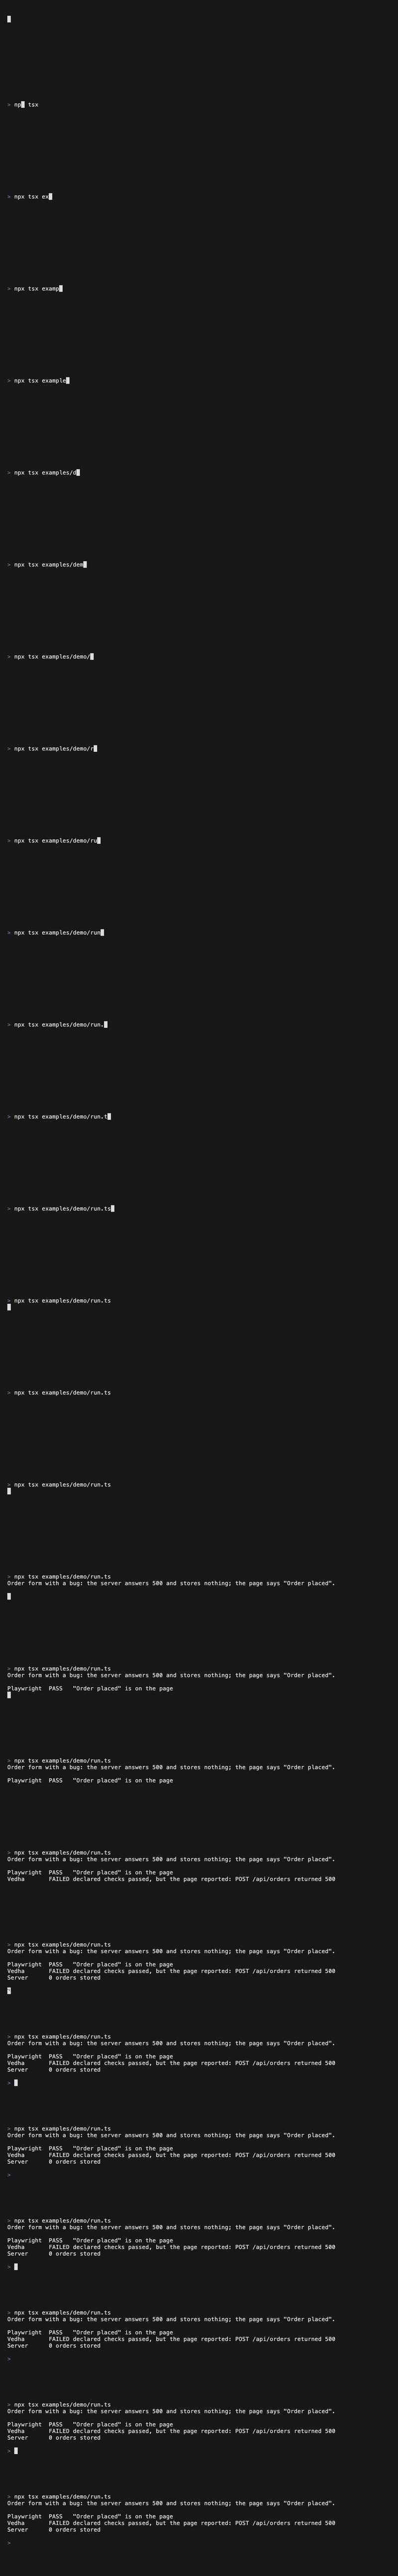
页面反馈只能证明界面发生了变化,不能单独证明业务操作完成。
不过,这不代表 Playwright 无法发现此类问题。开发者同样可以手写响应检查和数据断言。Vedha 的价值是把这些检查纳入 agent 的操作流程,减少只看页面就宣布通过的情况。
它还处理一种更麻烦的状态:提交超时,但无法确定订单是否已创建。Vedha 会返回 outcome_unknown,在只读检查澄清结果前拒绝再次点击提交,避免 agent 盲目重试。需要主动查询时,可以用 vedha_probe 请求 GET /api/orders,无需离开当前页面。
从一次探索到 CI,哪些信息需要留下来
Claude Code 的接入命令是 claude mcp add vedha -- npx -y @vedhajs/mcp --allow-domain localhost --out ./vedha-out。其他客户端在 MCP 配置中以 npx 启动,参数使用相同的 -y、@vedhajs/mcp、--allow-domain localhost 和 --out ./vedha-out。
其中 --allow-domain localhost 是必要配置,浏览范围由允许的域名决定。机器首次使用 Playwright 时,还需执行 npx playwright install chromium。可选命令 npx skills add HMAKT99/VEDHA 用于安装测试 skill,教 agent 声明检查、标记写操作,以及不要重试结果未知的操作。
启动应用后,就可以要求 agent 测试结账。下面这次 vedha_act 调用把填表、提交及预期结果连在一起:
{
  "op": "fill", "intent": "enter name", "target": { "label": "Name" }, "value": "Ada",
  "then": [{
    "op": "click", "intent": "place the order",
    "target": { "role": "button", "name": "Place order" },
    "mutating": true,
    "expect": { "text_contains": "Order placed" }
  }]
}
关键是 mutating: true:它告诉 Vedha,这次点击会修改数据,需要检查服务端效果。expect 则声明页面上应出现什么,两者承担不同的验证责任。
流程验证成功后,让 agent 保存为 Playwright 测试,它会调用 vedha_promote。作者展示的生成结果如下:
// Generated by Vedha from an explored session. Review before committing.
import { test, expect } from "@playwright/test";

test("places an order", async ({ page }) => {
  await test.step("open the shop", async () => {
    await page.goto("/");
  });
  await test.step("enter name", async () => {
    await page.getByLabel("Name", { exact: true }).fill("Ada");
  });
  await test.step("place the order", async () => {
    await page.getByRole("button", { name: "Place order", exact: true }).click();
    await expect(page.locator("body")).toContainText("Order placed");
    await expect.poll(async () => {
      const res = await page.request.get("/api/orders");
      const body = await res.json();
      const items = Array.isArray(body) ? body : [body];
      return items.some((it) =>
        Object.entries({ name: "Ada", qty: 1, product: "Widget" }).every(([k, val]) => it[k] === val),
      );
    }).toBe(true);
  });
});
要看的是最后的 expect.poll:测试会回读订单,检查 name: "Ada"、qty: 1、product: "Widget" 是否匹配。探索时拿到的服务端证据,被保留成了回归断言。
生成代码仍需审查。这里的 / 依赖测试环境配置;订单列表里出现匹配记录,也未必足以证明它来自本次提交。原文称生成文件会列出假设,但展示的片段没有给出详细清单。
接入 CI 时,作者还建议执行 npm install -D @vedhajs/playwright-test,把导入改为 import { test, expect } from "@vedhajs/playwright-test";。按照原文描述,这个 guard mode 会让原本断言通过、但应用出现 5xx 或写请求失败的测试转为失败,也适用于人工编写的测试。
我的判断
我认同它对测试结果的分级。尤其是 outcome_unknown,把「还没证实」保留下来,比让 agent 为完成任务而继续提交更合理。对表单提交、下单等写操作,这个约束很实用。
但服务端回读有前提:应用得有合适的查询接口,agent 也得能识别目标记录。读到了什么、能否对应本次操作,直接影响验证强度。原文没有讲清复杂权限、异步落库或记录关联如何处理,不能据此认定它能自动验证所有业务结果。
基准数据也需要收着看。作者报告,一次小规模试验使用一个模型、留出任务,每项做 3 次试验,Vedha 漏掉 9 个植入缺陷,Playwright MCP 漏掉 26 个,token 使用量约少 30%。这是积极信号,但所给内容没有展开任务分布、样本规模和配置细节,不能直接推成一般团队的收益。
它最值得借鉴的是验证规则,而不是把某次基准结果当作选型结论。
已有成熟 Playwright 套件的团队,可以先补响应和回读断言;主要依靠 agent 探索页面的团队,则更有理由试用这种统一约束。
能拿来做什么
- 先挑一个有明确写入结果、也有查询接口的流程试跑,例如创建订单;同时检查成功文案、请求结果和新记录,判断它能否正确关联本次操作。
- 审查 AI 生成的 Playwright 测试时,重点找「点击提交后只检查提示文字」的用例,补上响应或服务端状态断言,并处理测试数据隔离。
- 给日常 AI 编程流程加一条规则:提交超时后先做只读查询,确认结果再决定是否重试,避免重复写入。
- 没有现成应用时,可按原文依次运行
git clone https://github.com/HMAKT99/VEDHA && cd VEDHA、pnpm install && pnpm build、npx tsx examples/demo/run.ts,用演示项目观察成功、失败和结果未知的区别。仓库采用 Apache-2.0 许可。