Meta 推出面向智能体子任务的 Muse Ember
Meta 发布小型模型 Muse Ember,面向工具调用、编码子任务、路由、抽取及长文档解析,支持百万输入 token。短提示输入与输出价格分别为每百万 token 0.10 和 0.50 美元,超过 20 万输入 token 后涨价,实际成本还需考虑推理 token。
AI 深度解读
Meta AI 推出的 Muse Ember,瞄准的是 Agent 每天反复执行的工具调用、代码子任务和信息提取。Simon Willison 关心的重点很实际:小模型是否已经能用更低的成本,承担一部分复杂任务?
他的结论偏乐观。Artificial Analysis 的结果显示,Ember 处于能力与任务成本的效率前沿;但他亲测的 SVG 绘图也暴露出一个限制:推理档位越高,结果未必越好。对程序员来说,这篇最有用的地方,是提供了一套比单看 token 报价更靠谱的选型思路。
同样的 token 单价,为什么任务账单不同
Meta 将 Muse Ember 定位为旗下最小、最高效的模型,面向复杂推理执行,以及工具调用、代码子任务、路由、信息提取和长文档解析等重复工作。这是厂商的产品定位,原文没有逐项验证这些能力。
短提示词下,它与 GPT-6 Luna、Claude Haiku 5.5 的报价相同:每百万输入 tokens 为 $0.10,每百万输出 tokens 为 $0.50。同日发布的 Claude Fable 5.2 则是 $8/$40,单价达到前者的 80 倍。
不过,三个小模型虽然都支持最多 100 万输入 tokens,却也都设置了长提示词涨价门槛。考虑这些门槛后,Ember 的定价介于另外两者之间。原文没有列出具体门槛和分段价格,不能据此算出长文档任务的准确账单。
更关键的是,推理模型完成同一道题,消耗的 tokens 可能相差很大。便宜的单价,并不自动对应便宜的任务。
Artificial Analysis 给出的任务成本更能体现这种差异:GPT-6 Luna 的 non-reasoning 档约为 $0.07,xhigh 档约为 $0.10;Muse Ember 的 xhigh 和 max 档分别约为 $0.12、$0.14;Claude Haiku 5.5 从 low 档约 $0.04,升到 xhigh 档则约为 $0.25。
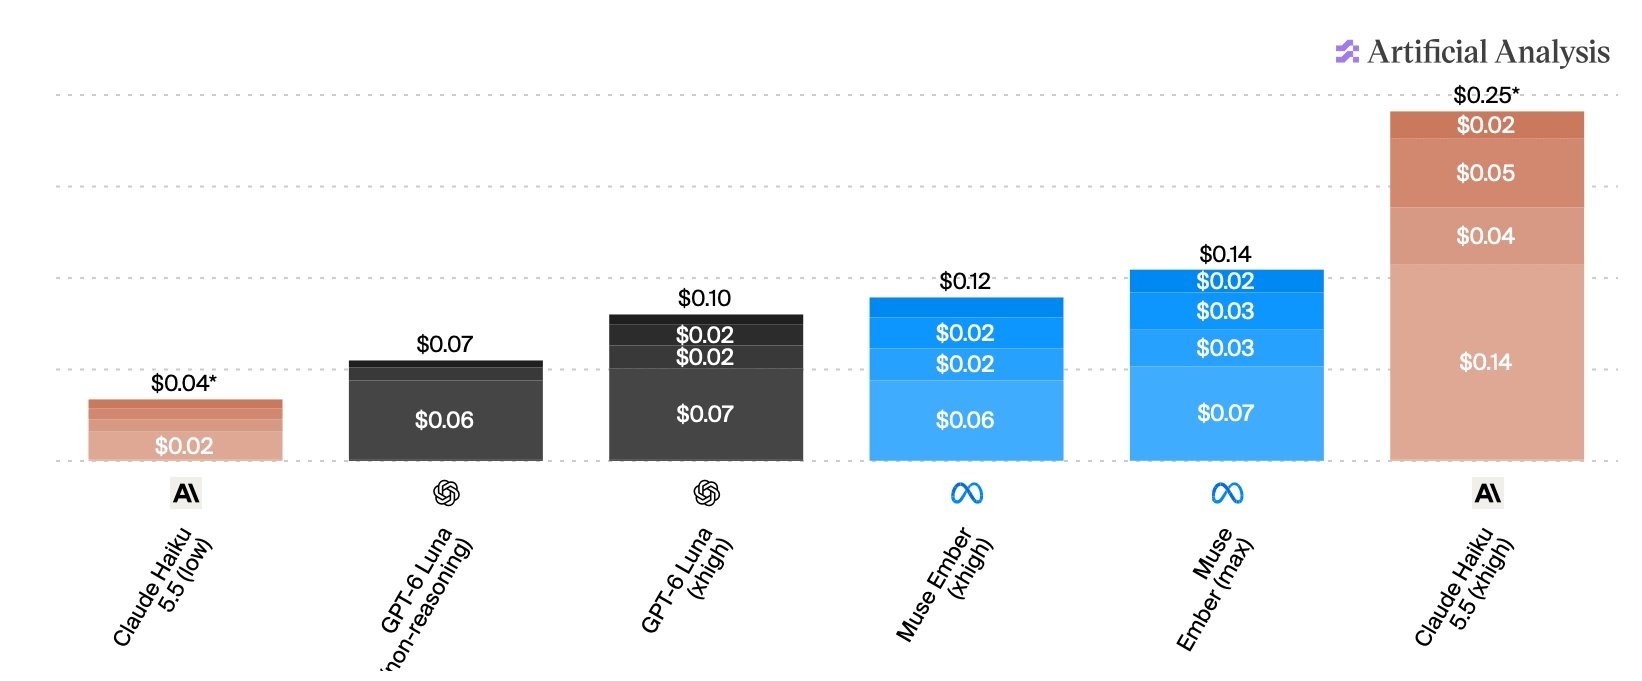
选模型时,应当比较完成同类任务的成本,而不只是每百万 tokens 的价格。
Ember 的优势,是在相近成本下拿到更高分
只看便宜还不够。一个模型如果经常答错,低价也很难变成生产收益。
因此,作者更看重 Artificial Analysis 的「Intelligence Index 与每任务成本」散点图。横轴是花费,纵轴是能力评分,越靠左上方越有吸引力。
图中,Muse Ember 的 xhigh 档约以 $0.12 获得 34 分,max 档约以 $0.14 获得 36 分。作为参照,GPT-6 Luna 的 xhigh 档约以 $0.10 获得 23.5 分;Claude Haiku 5.5 的 xhigh 档约以 $0.25 获得 34.5 分。
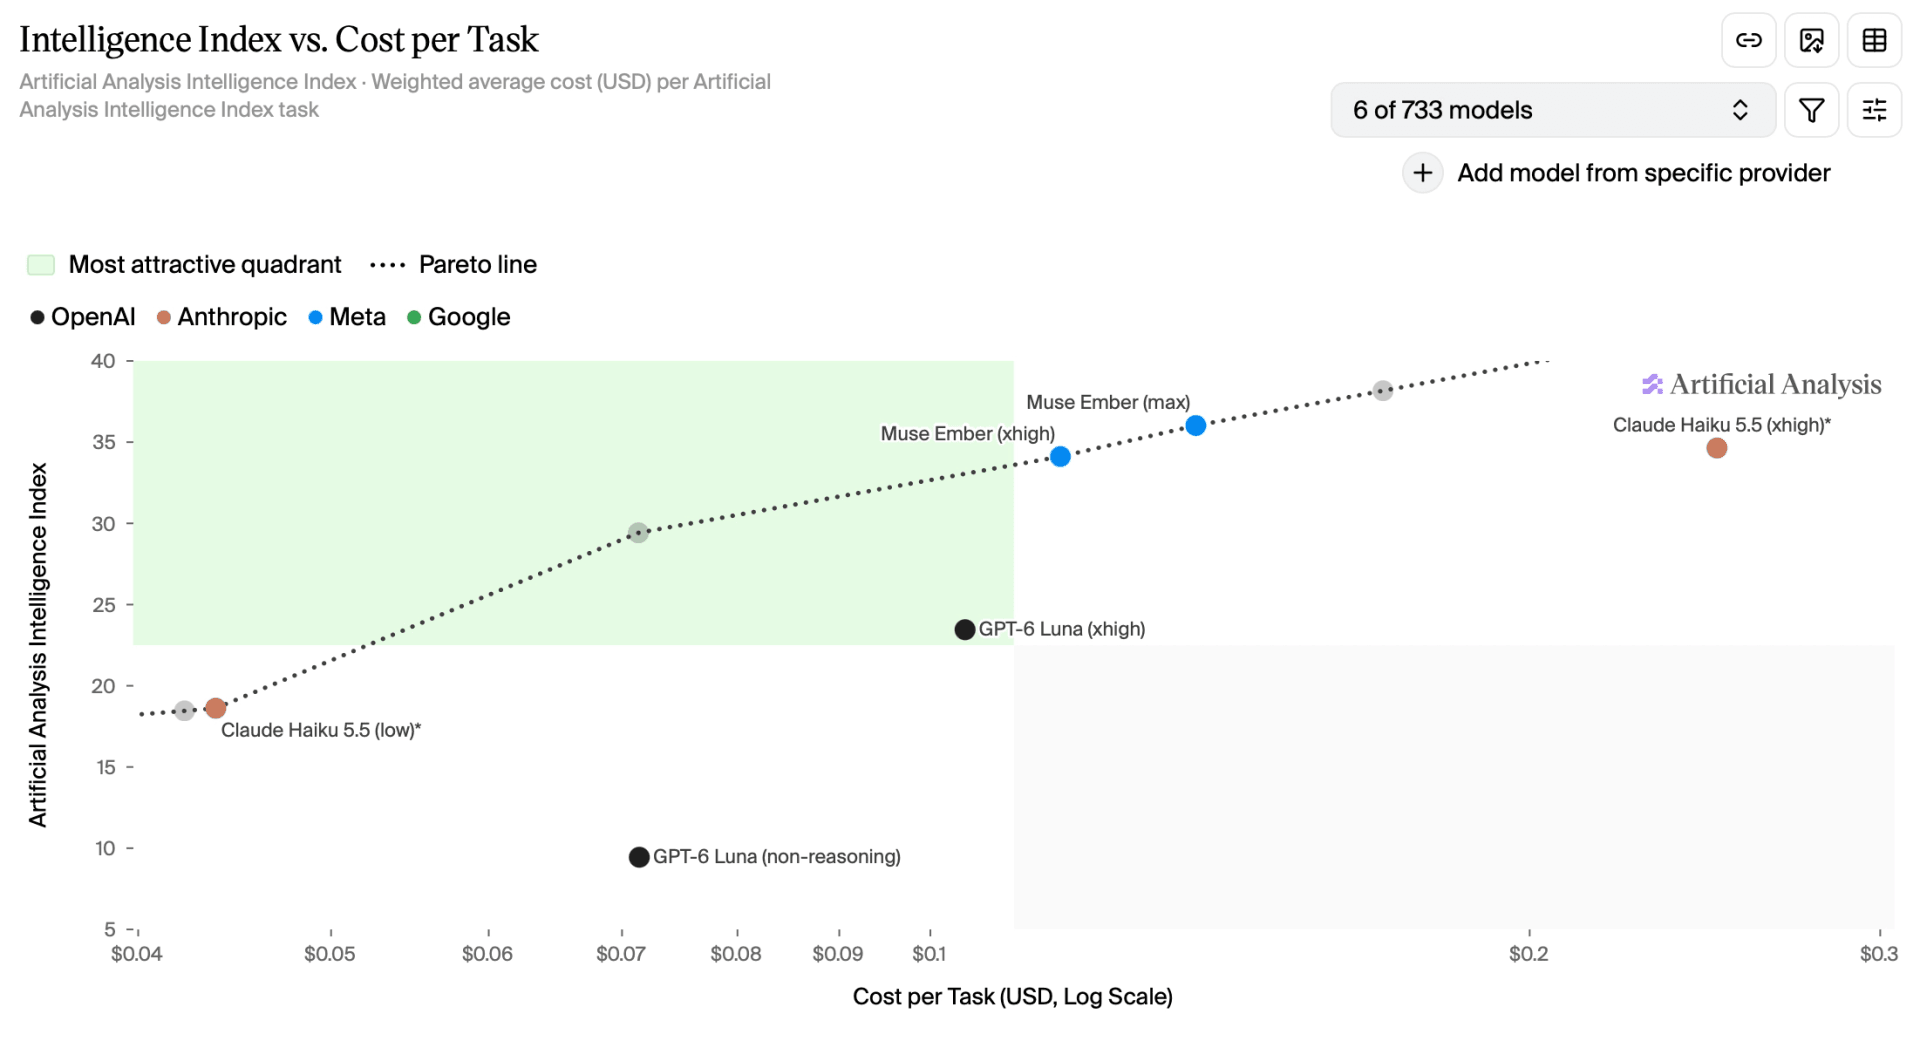
Ember 的两个档位都落在帕累托前沿(Pareto frontier)上。大白话解释:按照这套评测,想继续提高能力,就需要接受更高成本;没有另一个模型能同时做到比它得分更高、每任务花费更少。Meta 也用这个结果强调自己的效率优势。
这个结论有明确边界:它针对的是该评测中的能力和成本。图里也有其他前沿模型,作者特别指出,其中一个灰点是 GPT-6.1 Terra 的 low 档,并表示应该更多关注 Terra 系列。Ember 并没有独占所有划算的位置。
推理开到 max,结果就一定更好吗
Muse Ember 提供六个推理档位:minimal、low、medium、high、xhigh、max。作者分别让它们生成一幅「骑自行车的鹈鹕」SVG,用来观察输出差异。
结果并没有沿着档位逐级变好。high 档甚至没有返回完整 SVG,其他档位的视觉质量也与推理强度缺乏清晰对应关系。
下面是 max 档的结果:自行车框架尚可,篮子里有鱼,鹈鹕头上却多了一顶奇怪的蓝帽子。
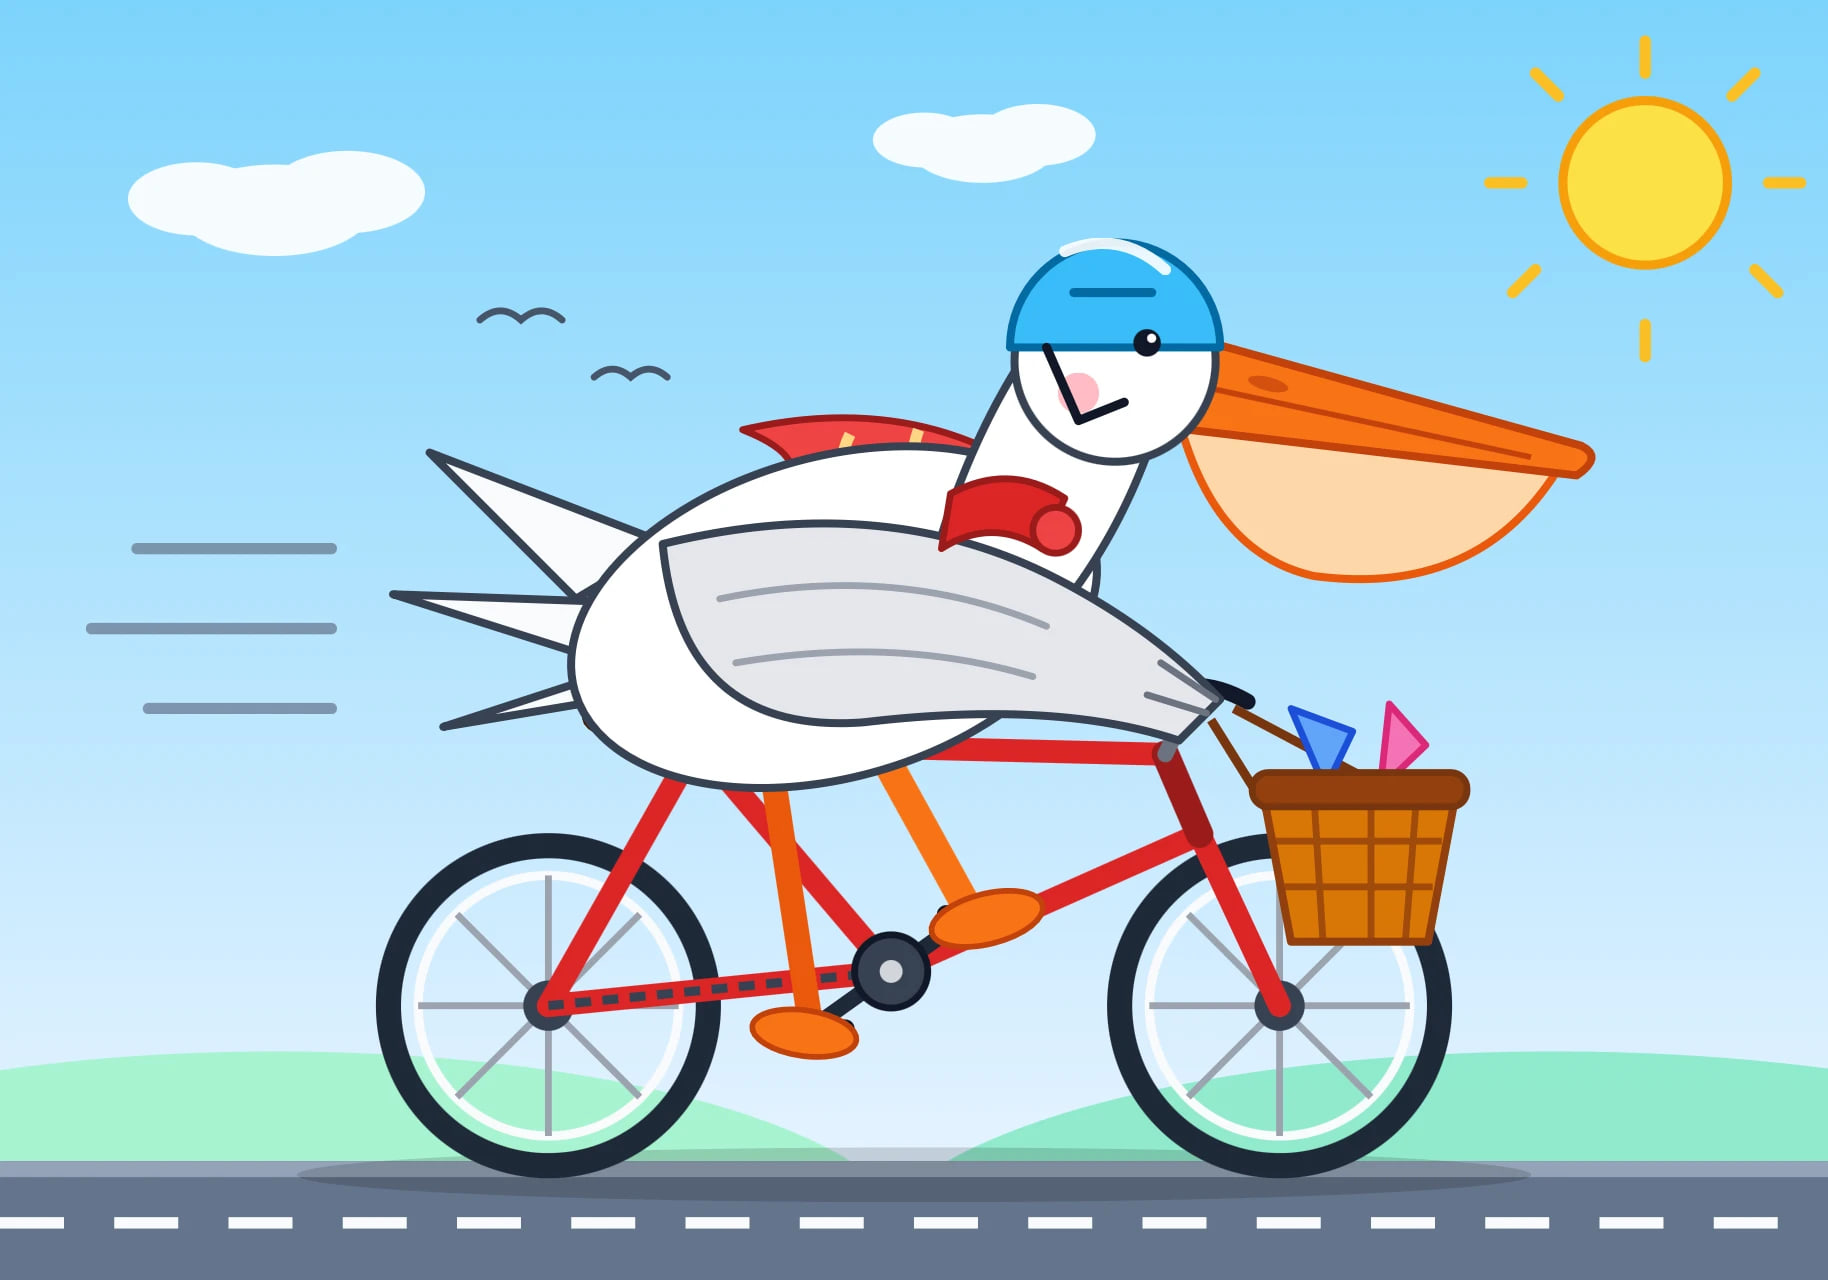
作者认为,这些鹈鹕与 Muse Wonder 的生成结果质量相近,而 Muse Wonder 的价格是 Ember 的 40 倍。这是作者对特定绘图任务的直观比较,不能延伸成两个模型整体能力相当。
这组实验更直接的提醒是:推理档位是需要验证的参数。至少在这次 SVG 测试中,增加推理强度没有稳定换来更好的交付物。
我的判断
我认同作者把注意力从 token 单价移到任务成本。这更接近日常 AI 编程的实际账单,也能避免拿关闭推理的低价档,直接对比另一个模型的高推理档。
但目前的证据还不足以支持直接替换团队主力模型。效率前沿来自第三方基准,原文没有给出真实代码仓库中的修改成功率、工具调用稳定性、响应延迟,也没有覆盖失败重试后的总成本。厂商列出的用途,仍需要业务样本验证。
鹈鹕实验则适合用来发现问题,不适合用来排综合名次。原文没有报告重复采样或系统对照,high 档的不完整输出值得记录,却不能据此认定这个档位普遍不可靠。与直接选择更贵的大模型相比,Ember 值得进入候选名单;是否适合接管某类任务,还得看任务验收结果。
能拿来做什么
- 给代码子任务、信息提取和工具调用分别准备一组固定样本,用相同验收条件比较 Ember、Luna 和 Haiku,同时记录成功率与实际花费。
- 测试 Ember 时保留推理档位作为变量,先比较 low、xhigh、max 的结果,再决定日常默认值,避免所有任务都开到最高档。
- 让模型生成 SVG 等结构化产物时,把「能否完整解析」加入验收;这能直接识别作者遇到的不完整输出问题。
- 处理长文档前先核对涨价门槛,再计算预算。100 万输入 tokens 是上下文容量信息,不能当作全程维持基础单价的承诺。