代码搜索实测:子 Agent 更贵却未更准
作者在六个开源仓库上进行了 288 次代码定位测试,各条件正确项找回比例为 97%—100%,差异不足 2 个百分点。强制使用同模型子 Agent 后,费用增加 74%—221%,耗时约为原来的 2—3 倍;结论限于这组只读搜索任务。
AI 深度解读
给 Claude Code 加一句「使用子代理」,搜索会更完整吗?作者用 288 次运行测了这件事:普通代码检索的答案召回率几乎没变,每次成本却增加 74% 到 221%,耗时约为原来的 2 到 3 倍。
这组实验更值得程序员关注的,还有一个自动化陷阱:在 claude -p 模式下,子代理可能先返回进度消息,稍后才交答案。脚本只取第一条或最后一条结果,都可能把正确答案漏掉。
多开一个 Explore,为什么没有多找到代码
Claude Code 2.1.318 新增了子代理 effort 配置 CLAUDE_CODE_SUBAGENT_EFFORT。作者想验证一个直觉:把搜索交给 Explore 子代理,再提高推理投入,能不能找得更全。
测试覆盖 6 个开源仓库:undici、fastify、cachetools、Python-Markdown、anyio、zod,全部固定到具体 commit。12 道题都属于「找出所有位置」,例如找出 lib/ 中所有创建 RequestAbortedError 的地方,并给出所在函数。
答案不是人工凭印象列的。作者用正则扫描源码,再用解析器确定外围函数或类,共得到 151 个答案项。实验采用只读工具,以无界面模式运行 Haiku 5.5 和 Opus 5.5,每组重复 3 次:
12 × 2 × 4 × 3 = 288
其中 72 次没有子代理指令,216 次要求使用子代理。作者还在首次运行前,将问题、答案键的 sha256 和 15 个百分点的判定阈值预注册到 GitHub,减少看完结果再改标准的空间。
结果很一致:所有条件下,正确答案的召回率都在 97% 到 100%,条件之间的差异不到 2 个百分点。这里衡量的是标准答案找到了多少,不能据此判断所有解释都正确。
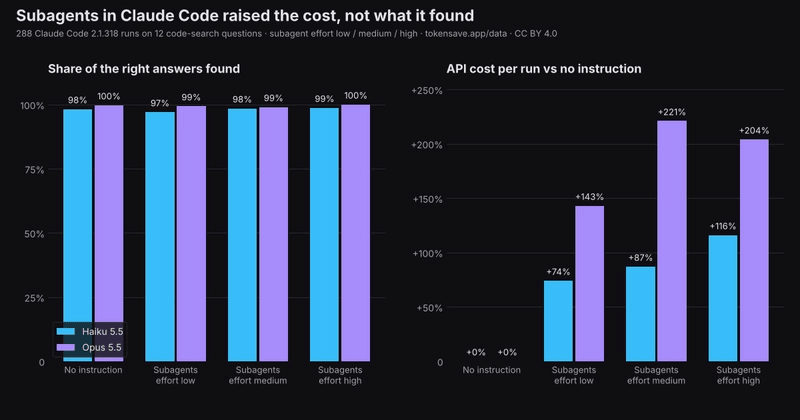
在这组普通代码检索任务里,子代理增加了开销,没有带来明显的召回收益。
成本涨在哪里,自动化又会踩什么坑
Haiku 5.5 使用子代理后,单次成本增加 74% 到 116%;Opus 5.5 增加 143% 到 221%。耗时约为原来的 2 到 3 倍。
一个关键细节是:子代理始终与主代理使用同一模型。Opus 调用的是 Opus 子代理,并没有自动换成更便宜的模型。提高 effort 也没改善检索结果,Opus 的 medium 甚至比 high 更贵。这个结果不足以证明 medium 通常更贵,但足以提醒人:配置档位不能直接当作账单预测。
在没有明确指令时,Claude Code 也没有主动使用子代理:本次 72 次中为 0 次,作者此前另一份数据的 504 次中同样为 0 次。这只能描述这些样本中的行为,不能推断它面对所有任务都不会主动委派。
更隐蔽的问题出在结果读取上。2.1.318 的 Explore 在后台执行,claude -p 的一次运行可能产生多个 result 事件。第一条可能只是「搜索还在后台运行」,最后一条也可能只是「自主循环已停止」。
216 次子代理运行中,有 210 次的首条 result 不含答案。只读第一条,统计出的答案召回率会降到 0% 到 9%;只读最后一条,也可能错过中间已经返回的答案。另外,4 次 Haiku 运行给出了答案,却一直没有退出,最终触及作者设置的 20 分钟超时。
作者最初的评分器也只读最后一条,发现问题后改为合并全部 result 事件,并在预注册记录中说明修改,数据中保留了不同读取方式的结果。
接入 CI 时,「收到 result」「拿到答案」和「进程退出」需要分别处理。
我的判断
作者对普通代码检索的建议有依据:别把「使用子代理」当成默认提示词,也别在没有测量收益时提高 effort。这些结论来自实际运行,全部 288 次记录按 CC BY 4.0 公开,验证路径比单纯展示几个成功案例更扎实。
但「子代理没用」超出了实验能支持的范围。两种模型不加指令时就已接近召回上限,剩余提升空间很小;测试对象是中等规模仓库,任务是定位代码位置,不能直接推广到大型 monorepo、跨模块分析或复杂实现任务。
实验还只覆盖一个 Claude Code 版本、一种提示措辞,每个组合重复 3 次。作者没有提供其他任务类型的对照数据,也没有比较直接使用 rg、AST 工具与模型检索的完整成本。因此,这份结果适合用来纠正「多代理必然更好」的预期,不能替所有团队决定搜索架构。
对位置明确、规则可描述的搜索,我会优先考虑确定性的检索工具,再让模型解释结果。这个取舍是工程判断,并非本次实验已经证明的优胜方案。
能拿来做什么
- 在前端或 Node 仓库查找调用点、异常创建位置时,先去掉模板里固定的「使用子代理」,保留直接检索作为基线,再比较召回率、费用和耗时。
- 用
claude -p接入 CI 或脚本时,读取全部 result 事件并汇总答案,同时单独处理退出状态和超时,避免把进度消息当成最终结果。 - 使用 Opus 委派搜索前,确认子代理实际使用的模型,并把它的费用计入单次任务预算。
- 调整
CLAUDE_CODE_SUBAGENT_EFFORT前,先用自己仓库的固定问题和已知答案做对照;没有测到收益,就保留默认值。