检索分数微涨,真实场景为何反而退步
作者借助 Claude Code 优化 Rust 与 SQLite 构建的本地记忆工具,测试分词、嵌入长度及混合检索权重等改动。多项调整只带来极小的基准收益,却损害真实场景表现,文章展示了数据划分和回归防护的作用。
AI 深度解读
给编程 Agent 做记忆检索,分数已经很高,还能靠调参挤出多少收益?palace-rs 的作者和 Claude Code 折腾了一周,唯一明确的提升,是 LongMemEval S 上的首位命中从 429 题变成 431 题。最后,这一周的改动没有发布。
这段经历值得读,不是因为找到了提分技巧,而是它把三个问题分开了:有没有找到正确记忆、有没有把它排在前面,以及问题是否还需要跨记录推理。分不清这些,优化很容易变成围着几道题打转。
正确记忆已经找到了,差在排到第几位
palace-rs 是一个本地优先的记忆工具,结构很克制:一个 Rust 二进制文件,加一个 SQLite 文件。检索结合 MiniLM 向量嵌入和 BM25 关键词搜索,检索路径不调用 LLM,也没有重排模型(reranker)。
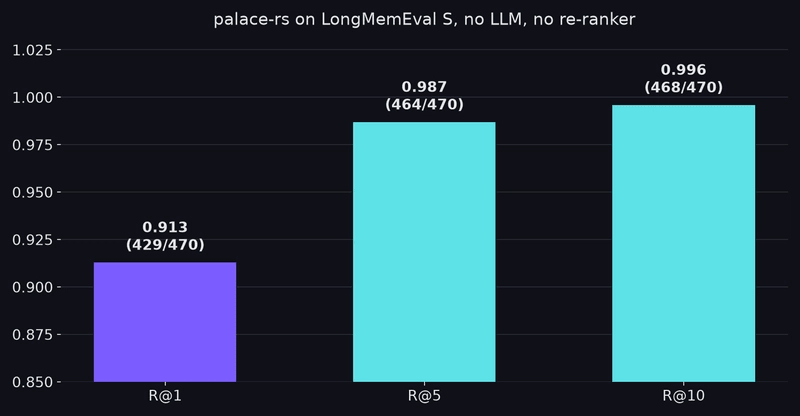
在 LongMemEval S 的 470 道计分问题上,作者报告:
- R@1 为 0.913,即 429 题。
- R@5 为 0.987,即 464 题。
- R@10 为 0.996,即 468 题。
这里的 R@K,可以先理解为正确会话是否进入前 K 个结果。作者还想改善 recall_all,它要求一道题对应的所有标准答案会话都进入前 K,要求更严。
更关键的观察是:470 题里,有 469 题的正确会话已经出现在前 30 个结果中。候选基本找到了,剩下的损失主要发生在排序环节。
找到正确记忆,和把正确记忆排在第一位,是两项不同的能力。
因此,继续扩大搜索范围未必能解决 R@1 的问题。作者尝试了不同的 cosine 相似度与 BM25 分数融合方式,结果彼此最多只差 3 题,说明在这套配置和数据上,融合策略能挖的空间已经很小。
为什么两道题的提升,最后也没有发布
作者给优化设了三条边界:不使用 LLM、不引入重排模型、不针对基准测试定制。
Claude Code 承担了大部分实验工作:离线回放分块得分导出数据,按 question-id 的哈希划分 DEV/TEST,并维护一套守护评测(guard suite)。这套评测同时包含作者自己的编程任务评测,以及针对其真实 palace 记忆快照的探针,用来检查基准提分是否损害实际使用。
一周下来,唯一明确的 R@1 收益是 429 → 431。其他所谓提升大多只涉及 1 到 4 道题,而且有进有退。在 470 题的规模下,一道题就约占 0.2%,小幅波动很容易显得比实际更重要。另一个评测 BEAM 100K 的 R@5 已经达到 355/355,也无法继续区分改善。
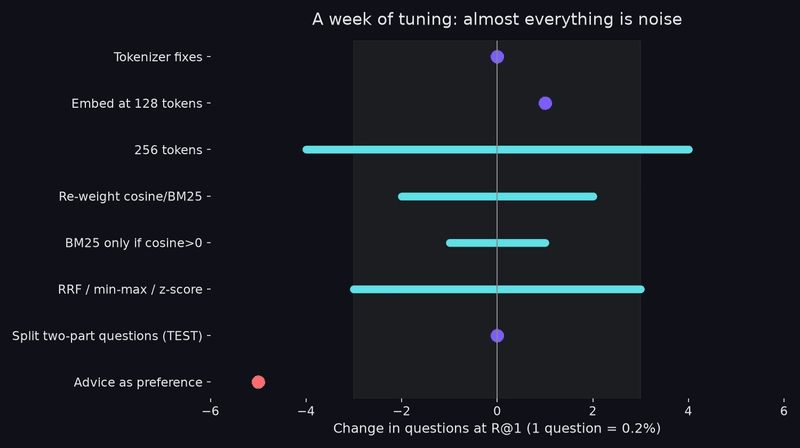
作者还报告,在涉及真实记忆探针的取舍中,LongMemEval 上的收益抵不过探针上的损失。原文没有给出完整的逐项对照,不能把这个结论扩展为所有检索系统的规律。
Claude Code 在这次实验里的价值,是如实报告收益只有两题、明确提示守护评测失败,并在作者要求「没有明确收益就停止」后停下来。最终没有发布改动,是实验结果的一部分。
剩下的题,可能已经超出纯检索的职责
作者认为,剩余失分集中在日期问题和跨会话计数。这类任务即使取回了相关记录,仍可能需要比较时间、汇总多次事件,再生成答案。
据作者转述,论文在这些问题上的收益来自 LLM,而他主动排除了这条路线。因此,他判断 LongMemEval S 对这套纯检索方案已经接近上限;如果继续改善 R@1,下一步更可能是本地 cross-encoder 重排器,而非继续调整融合公式。
cross-encoder 会把问题和候选内容一起输入模型,重新判断相关程度。它适合处理「候选找到了,但顺序不够好」的问题。不过,这只是作者提出的下一步,原文没有提供接入后的提升或延迟数据。
作者也在询问是否该转向 LongMemEval M、BEAM 1M 或自建评测。这些都是待探索的方向,不能当成已经验证过的方案。
我的判断
我认同作者保留真实任务评测、接受不发布结果的做法。对编程记忆工具而言,基准多答对两题,却让日常记忆检索变差,通常不值得交换。
但「主要是基准的问题」还需要收窄。现有结果能支持的是:MiniLM 加 BM25、没有 LLM 和重排器的这套方案,在 LongMemEval S 上继续调参的收益很小。它不能证明其他检索架构也到了上限。
日期和计数失分也值得拆开检查:究竟是相关会话没被完整取回,还是取回后缺少计算能力?原文没有逐题展开。日期字段、时间过滤等结构化做法是否有效,也没有对照数据,不能替作者认定它们可行或无效。
这是一份有价值的优化记录,但还不是证明基准失效的对照实验。
能拿来做什么
- 给 AI 编程助手接入记忆时,同时记录候选召回和首位命中。正确记录已在前 30 位时,优先排查排序,避免持续扩大检索范围。
- 调整检索策略前,保留一组真实开发任务和固定记忆快照作为守护评测。公开基准与日常任务一起比较,才能判断改动是否值得发布。
- 让 Claude Code 参与优化时,要求它报告具体多答对了几题、哪些题退步、守护评测是否通过,并提前写明停止条件。
- 把日期比较和跨记录计数单独归类。先核对所需会话是否完整取回,再决定该优化检索,还是补充后续处理能力。